Аналитик данных


Kanal geosi va tili: Rossiya, Ruscha
Toifa: ko‘rsatilmagan


Аналитика данных, Дата Сеанс
@workakkk - по всем вопросам

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Toifa
ko‘rsatilmagan
Statistika
Postlar filtri


🔥 Бесплатный курс по Claude Code на русском: от установки до команды агентов

На GitHub выложили Claude Code PRO Course, бесплатный практический курс по Claude Code на русском языке. Он ведёт от первого запуска до настройки многоагентной работы в команде.

Внутри 12 модулей в четырёх уровнях сложности: основы, рабочий процесс, расширения и масштабирование. Сначала установка, промптинг, память проекта через CLAUDE.md, настройки и права доступа. Потом профессиональный рабочий процесс, скиллы и слэш-команды, сабагенты и хуки.

Дальше идут MCP, плагины и маркетплейсы, а в конце headless-режим, CI и GitHub Actions плюс продвинутые техники. Основной упор сделан на управление контекстом, разработку через тесты и автоматизацию через конфигурацию как код.

Теорией курс не ограничивается: есть 8 практических лабораторных, готовый стартовый набор, библиотека промптов и пример собственного плагина. Лицензия MIT.

https://github.com/justxor/claude-code-pro-course


🚀 LLM всё лучше пишут код. Следующая проблема - как человеку быстро понимать их результат.

Несколько полезных приёмов:

- Текст: попросите объяснять в стиле ASD-STE100 - это строгий язык технической документации из авиации. Обычно текст становится заметно чище и понятнее. Можно попросить «80% ASD-STE100», чтобы стиль не был слишком сухим.
- Диаграммы: вместо длинного объяснения попросите схему - сложную систему часто проще понять визуально.
- HTML: попросите оформить объяснение как интерактивную веб-страницу с графиками, анимациями и примерами.
- Видео: для сложных тем можно попросить AI собрать полноценный explainer в стиле 3Blue1Brown с визуализациями и озвучкой.

Главная мысль: по мере роста возможностей AI человеку всё чаще придётся не выполнять работу самому, а проверять и понимать результат.

И сами LLM могут создавать для этого одноразовые инструменты - страницы, симуляторы, диаграммы и видео, которые раньше было слишком дорого делать ради одного объяснения.


Machinelearning dan repost
⚡️ DeepSeek перенесла DeepGEMM на Huawei Ascend и выжала из железа 99,8%

DeepSeek выложила DeepGEMM-Ascend, порт своей библиотеки матричных ядер на NPU Huawei Ascend 950. API остался тем же, что у оригинального DeepGEMM, а сами ядра переписаны под особенности Ascend.

Поддерживаются GEMM в FP4, FP8 и BF16, grouped GEMM для MoE, MQA logits и слитые операторы MegaMoE. Плотный GEMM почти упирается в теоретический потолок: FP4 даёт 1701 TFLOPS (98,3% от пика), FP8 861 TFLOPS (99,5%), BF16 431 TFLOPS (99,8%).

Внутри JIT-компиляция, конвейеризация на корутинах и тонкая обёртка над матричными инструкциями Ascend. Нужны CANN 9.20, torch_npu и Python 3.10+. Лицензия MIT.

https://github.com/deepseek-ai/DeepGEMM-Ascend

@ai_machinelearning_big_data

#DeepSeek


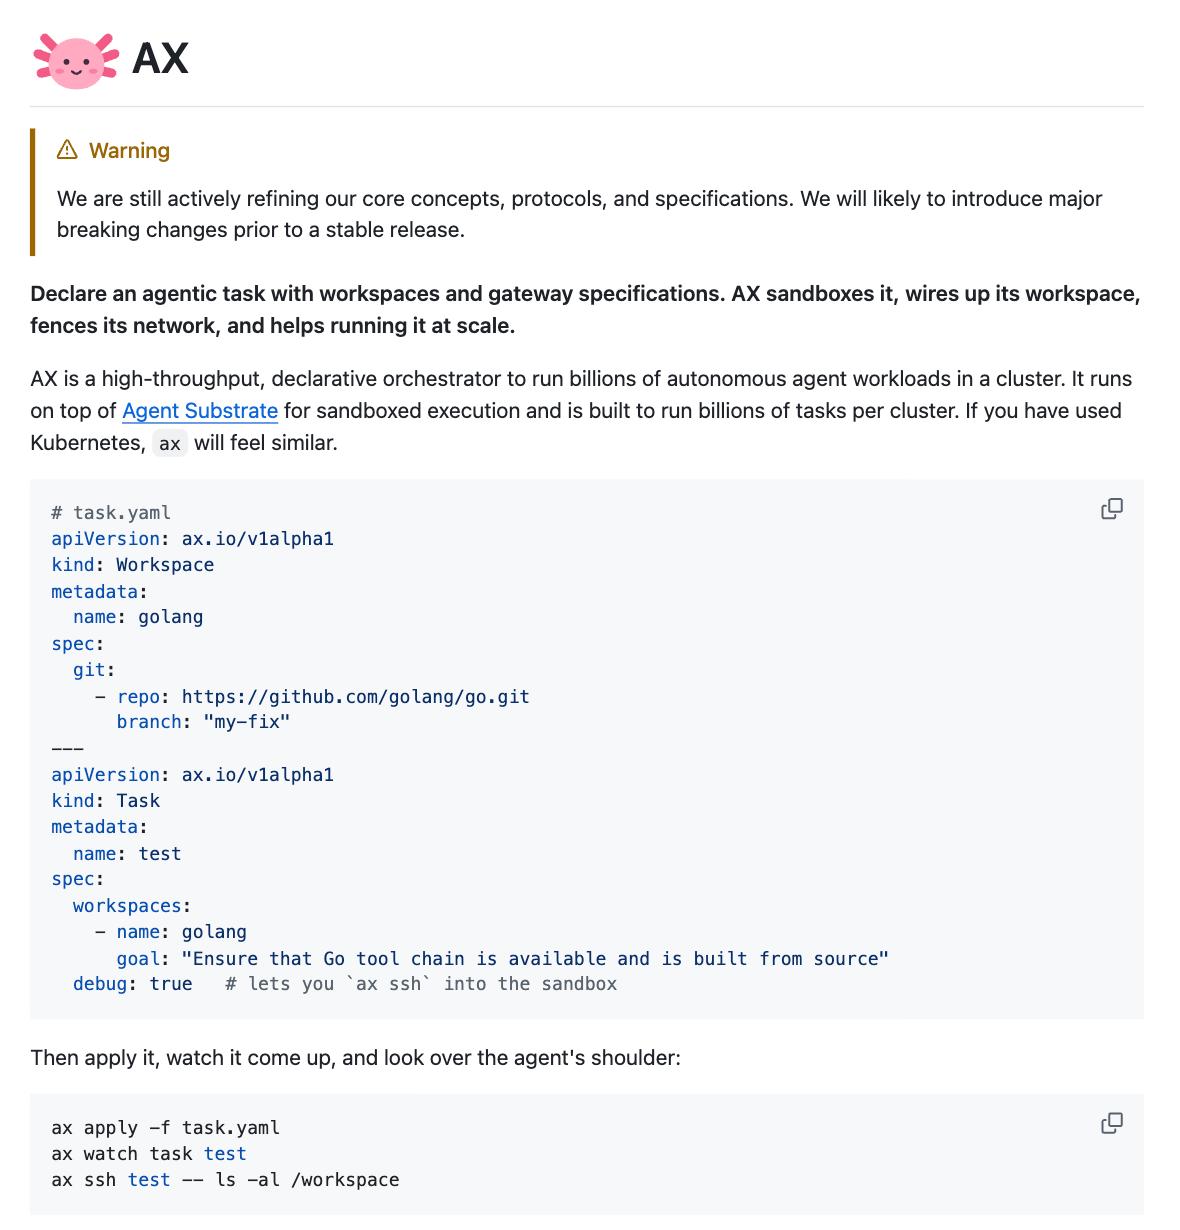
👣 Google открыла исходный код AX, среды для запуска AI-агентов в продакшене.

AX изолирует задачи, подключает репозитории, MCP-серверы и навыки, ограничивает сетевой доступ, а также позволяет приостанавливать и возобновлять работу агентов с сохранением состояния.

Это не новый агентный фреймворк и не облачный сервис, а инфраструктурный слой для масштабирования долгоживущих агентов в Kubernetes.

https://github.com/google/ax


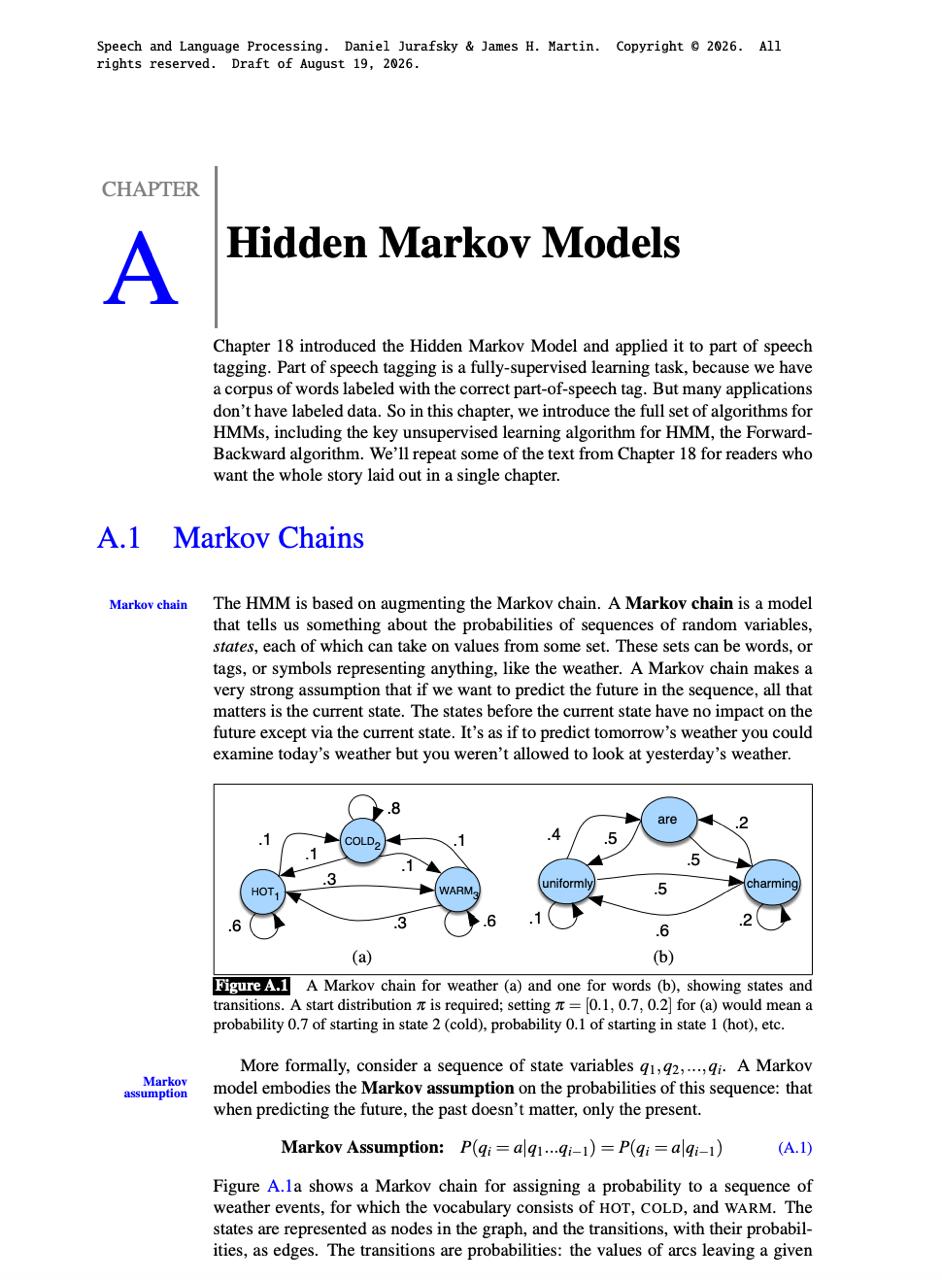
📘 Бесплатный 17-страничный PDF по Hidden Markov Models (HMM)

Короткий материал от Stanford по одной из классических моделей машинного обучения для работы с последовательностями.

Внутри разбираются:

- состояния и наблюдения
- transition и emission probabilities
- вычисление вероятности последовательности
- декодирование скрытых состояний
- обучение параметров HMM
- применение к последовательным данным

Хороший компактный материал, если нужно быстро разобраться, как работают скрытые марковские модели без чтения огромного учебника.

https://web.stanford.edu/~jurafsky/slp3/A.pdf


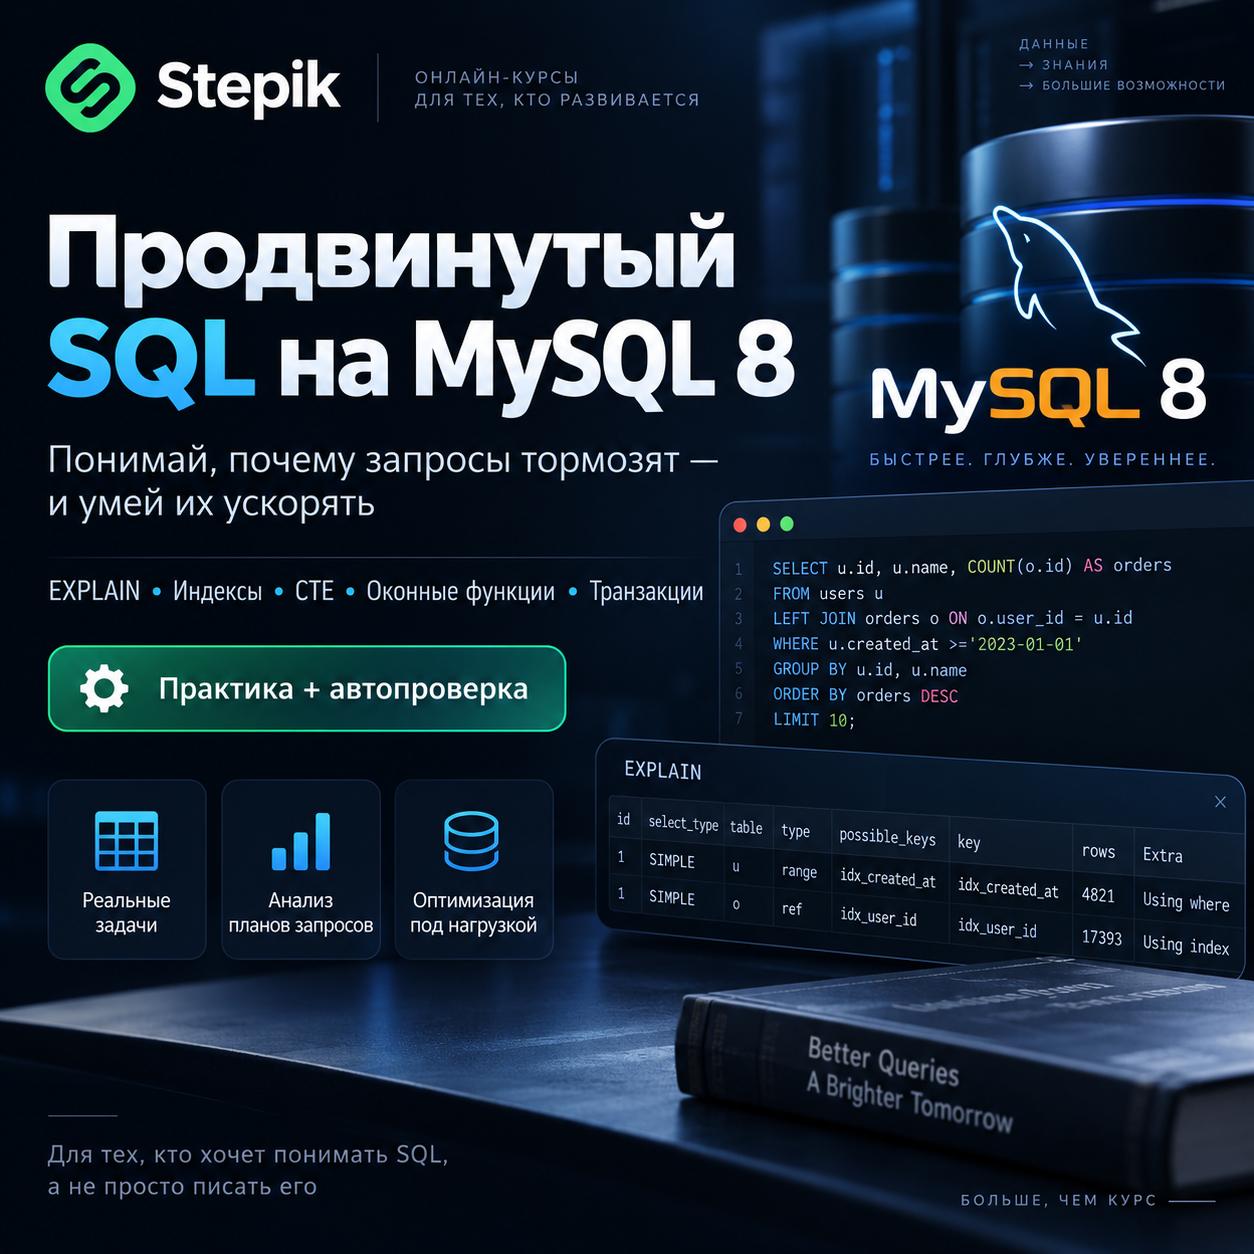
🔥 Один из лучших обучающих курсов на StepiK по SQL

SQL можно знать годами и всё равно теряться, когда запрос внезапно начинает тормозить в проде.

Этот курс про уровень, где ты не просто пишешь SELECT, а понимаешь, что происходит внутри MySQL, почему запрос работает медленно и как ускорить его без новых проблем. Здесь разбираются EXPLAIN, индексы, CTE, оконные функции, транзакции, аналитические паттерны, legacy SQL и работа с AI-ассистентами.

Каждый урок - с практикой и реальными SQL-задачами на MySQL 8 с автопроверкой.

После курса ты сможешь увереннее разбирать чужой код, находить узкие места и предлагать решения, которые действительно работают.

Для подписчиков скидка - 49% в течение 2 суток: https://stepik.org/a/298827/


Machinelearning dan repost
✔️ Hugging Face запустила агента для ML-экспериментов

Платформа встроила в свой чат-бот открытого ассистента ML Intern, который берет на себя полный цикл машинного обучения по текстовому описанию задачи.

Инструмент ориентирован на пользователей без профильного опыта. Для старта достаточно сформулировать идею в окне ввода текста, включить агента и он сам найдет релевантные модели и датасеты на Hugging Face Hub, в GitHub или в сети.

Перед стартом проводится оценка необходимых вычислительных ресурсов и фиксируется бюджет, за пределы которого агент гарантированно не выйдет.

После подтверждения ML Intern подготавливает данные, запускает обучение, мониторит процесс через отдельный дашборд, выгружает веса обратно на Hub, генерирует отчет и разворачивает интерактивное демо.


@ai_machinelearning_big_data

#news #ai #ml


Как нормально тестировать AI-агента, если правильный ответ ещё ничего не доказывает

У обычного чат-бота можно проверить финальный ответ. С агентами этого уже мало: модель может выдать вполне убедительный текст, но перед этим выбрать не тот skill, вызвать неправильный tool, потерять контекст на втором сообщении или выполнить только половину задачи.

Ed Crewe описал, как они строили eval-фреймворк для агентного чат-бота вокруг Postgres AI Hybrid Manager.

Начали с простого routing eval: для каждого запроса проверяется, выбрал ли агент нужный skill или tool. Это быстро, детерминированно и удобно гонять в CI.

Следующий слой — Task Completion Rate. Здесь уже оценивается сам результат: выполнил ли агент задачу, использовал ли нужные данные, предложил ли адекватный следующий шаг. Для таких проверок используется LLM-as-a-judge и заранее заданная rubric.

Но и этого оказалось мало. Реальные задачи часто состоят из нескольких сообщений, поэтому тестировать приходится уже целые диалоги с сохранением conversation state и отдельными проверками каждого шага.

Финальный уровень — trajectory testing: смотреть не только на ответ, а на весь путь агента к нему: маршрутизацию, выбор skills, tool calls, промежуточные действия, состояние диалога и итоговый результат.

Получается уже почти классическое E2E-тестирование, только объект проверки здесь не HTTP-запрос или UI, а поведение AI-агента целиком.

В основе автор использует deepeval, поверх которого добавлены YAML goldens, CI, плагины, multi-turn evals и телеметрия через Langfuse.

https://edcrewe.blogspot.com/2026/08/from-routing-checks-to-trajectory.html


⚡️ Harness Engineering - полный курс на русском

Как заставить AI-агента писать код надёжно. Не «какую модель выбрать», а как спроектировать вокруг неё рабочую систему: инструкции, инструменты, среду, состояние и верификацию.

Курс - от нуля до продвинутых тем: теоретическая база из 11 блоков, 14 модулей, 8 практических проектов, 14 лабораторных работ, диагностический протокол «как починить агента», библиотека готовых шаблонов, карта инструментов, 40 приёмов и каталог антипаттернов.

Главный тезис курса: способность модели и надёжность исполнения - это две разные вещи. Одна и та же модель в «голой» среде и в среде с продуманным harness даёт качественно разные результаты. Апгрейд модели - это самый дорогой и обычно не самый эффективный способ починить агента.

https://github.com/justxor/Harness_ru


Data Science. SQL hub dan repost
🚀 ИИ-агент ускорил SQLite до 59% меньше чем за 8 часов

Ускорить SQLite хотя бы на 5% уже было бы серьёзным результатом. Это один из самых зрелых и оптимизированных проектов в мире - его команда почти 20 лет выжимает из кода каждую долю производительности.

Но AI-агент KISS Sorcar менее чем за 8 часов и с затратами меньше $150 добился заметного ускорения сразу в нескольких типах нагрузки.

Результаты:

- 2,06× быстрее в официальном speedtest1 (~30 тыс. операций)
- 1,90× в TATP — транзакционная OLTP-нагрузка
- 1,30× в Star Schema Benchmark — аналитические запросы
- 1,25× в kvtest — работа с BLOB и дисковым I/O

Агент нашёл места, где стандартная конфигурация SQLite несла лишние расходы — особенно при записи транзакций на диск.

После этого он:

- изменил код и настройки
- прогнал бенчмарки
- проверил свои же изменения на ошибки
- сохранил совместимость с существующими тестами

Более миллиона тестов SQLite продолжают проходить.


анализ зрелой кодовой базы → поиск узких мест → изменение реализации → бенчмарки → проверка собственных решений.

GitHub:
https://github.com/ksenxx/sqlite-optimized/

Blog: https://kisssorcar.github.io/blog/sqlite-optimization-blog.html


#AI #SQLite #Programming #CodingAgents #Performance #OpenSource


Rust dan repost
✔️ Firecrawl открыла один из самых быстрых PDF-парсеров

Компания выложила в open source pdf-inspector - библиотеку на Rust, которая превращает PDF в Markdown, сохраняя структуру документа, заголовки и таблицы.

По заявленным тестам, обработка одной страницы занимает около 0,002 секунды, а набор из 200 PDF был пройден примерно за 2,8 секунды.

Главное здесь не одна скорость: парсер старается сохранить исходную логику документа, поэтому результат удобнее сразу отдавать в RAG, поиск, анализ или пайплайн подготовки данных.

Проект полностью открыт.

https://github.com/firecrawl/pdf-inspector


Анализ данных (Data analysis) dan repost
Ох уж, эта богатая жизнь


Агенты прокачивают друг друга

UCSB-AI выложили GEA, фреймворк для open-ended self-improvement агентов через обмен опытом.

Идея простая, но мощная: улучшать не одного агента в вакууме, а целую группу агентов как одну эволюционирующую систему.

Один агент нашёл удачный паттерн, другой переиспользовал его, третий доработал, группа стала сильнее.

Это похоже на переход от «один AI сам себя улучшает» к «популяция агентов накапливает коллективный опыт».

В репозитории есть код для запуска GEA, интеграция с SWE-bench и Polyglot, Docker-окружение, промпты и инструменты для foundation-моделей. Проект распространяется под Apache-2.0.

https://github.com/UCSB-AI/GEA


✔️ Data-Juicer: пайплайн для подготовки данных под foundation models

Alibaba и сообщество Data-Juicer развивают open-source систему для обработки датасетов перед обучением, дообучением и RAG.

Data-Juicer помогает чистить, фильтровать, дедуплицировать, синтезировать и анализировать данные. Работает не только с текстом, но и с мультимодальными датасетами: изображениями, аудио и видео. В версии 2.0 заявлено больше 100 операторов для разных модальностей.

Практический сценарий понятный: есть сырой корпус из разных источников, где много дублей, мусора, слабых примеров и перекоса по доменам. Data-Juicer позволяет собрать воспроизводимый data recipe, прогнать его на локальной машине или в распределённом режиме и потом оценить, как изменения в данных влияют на модель.

Проект смотрит на данные как на отдельный слой оптимизации. Позволяет настроить качество, смесь, фильтры и пайплайн обработки. В ранней работе авторы показывали прирост до 7.45% по среднему score на 16 LLM-бенчмарках и 17.5% win rate в GPT-4 pairwise evaluation за счёт data recipes.


https://github.com/datajuicer/data-juicer


Мы вообще понимаем, насколько Месси статистически ненормален?

Я наткнулся на цифру: по голам + ассистам за 90 минут он почти на 6 стандартных отклонений выше среднего нападающего из топ-лиг.

Для контекста: это уже не «очень сильный игрок».

Это уровень, который статистика почти не ожидает увидеть при жизни одного поколения.

Вот почему спор про Месси часто ломается: его сравнивают как футболиста, а он по цифрам ближе к аномалии.

Мы реально застали сбой системы.

Или всё ещё есть сомневающиеся?


⚡️ Ling & Ring 2.6: новый техрепорт и open-weight модели

Ant Ling выпустили технический отчёт по Ling & Ring 2.6 и открыли два base checkpoint.

Главное:

* 7:1 Hybrid Linear Attention: 7 Lightning Attention слоёв + 1 MLA слой, чтобы сделать 256K context практичнее
* KPop RL: адаптивный Binary KL вместо uniform KL, прирост SWE-bench Verified с 70.8% до 76.28%
* ~4× token efficiency: больше “интеллекта” на меньшее число output-токенов
* Ling-2.6-flash: 104B, быстрый inference
* Ling-2.6-1T: trillion-scale flagship
* Ring-2.6-1T: deep reasoning и long-horizon agentic задачи

Суть релиза: команда оптимизирует не только модель, а всю связку architecture + training + agentic capability.

Открыты:

* Ling-2.6-1T-base
* Ling-2.6-flash-base
* код и inference-стек

📑 Full technical report: http://arxiv.org/abs/2606.15079
🧱 Ling-2.6-1T-base:
http://huggingface.co/inclusionAI/Ling-2.6-1T-base
🧱 Ring-2.6-flash-base:
http://huggingface.co/inclusionAI/Ling-2.6-flash-base
💻 Code:
http://github.com/inclusionAI/Ling-V2.5
⚙️ Inference:
http://github.com/inclusionAI/linghe


The Information: по сообщениям, Anthropic переходит от аренды облачных вычислений к аренде и самостоятельному управлению дата-центрами. Планируемая мощность в США — более 1 ГВт, а Google потенциально может выступить гарантом или поддержкой по арендным платежам.

Старая модель была простой: Anthropic платит облачным провайдерам за GPU или кастомные чипы, но сам провайдер контролирует здание, электропитание, сеть, охлаждение и большую часть графика поставок железа.

Новая модель приближает Anthropic к «цеху» ИИ-индустрии, где дата-центры — это уже не офисные здания, а энергоёмкие машинные залы, круглосуточно питающие системы обучения и инференса.

Для контекста: до сих пор вычислительная стратегия Anthropic в основном строилась через облачных провайдеров. Компания уже взяла на себя обязательства по аренде серверных мощностей более чем на 10 ГВт, включая соглашение с Google на $200 млрд.

Также Anthropic заключила крупные облачные сделки с Akamai, AWS, CoreWeave и Fluidstack. Они охватывают в том числе железо Amazon Trainium и партнёрство с Fluidstack на $50 млрд.

Кроме того, компания расширила команду по дата-центрам и подписала договор аренды со SpaceX/xAI на весь дата-центр Colossus 1 за $1,25 млрд в месяц, а также получила площади в Colossus II.


🖥 Python в 2026 - уже не просто «первый язык программирования».

Это инструмент, с которым можно автоматизировать задачи, писать скрипты, собирать проекты, работать с данными, делать ботов и использовать ИИ как ускоритель разработки.

Но есть проблема: большинство новичков учат Python кусками. Немного синтаксиса, пару задачек, немного теории - и потом ступор: «а что с этим делать дальше?»

Этот курс сделан иначе. Здесь упор на реальную практику: вы не просто смотрите уроки, а постепенно учитесь писать код, разбирать ошибки, собирать рабочие решения и понимать, как Python применяется в нормальных задачах.

Что внутри:

- Python с нуля понятным языком
- практика вместо бесконечной сухой теории
- реальные задачи и проекты
- автоматизация рутины
- работа с файлами, данными и API
- понятная логика программирования
- современный подход к разработке с ИИ
- отдельный акцент на вайбкодинг

Вайбкодинг -это умение правильно ставить задачу, проверять код, понимать результат и ускорять работу без слепого копирования. В 2026 году это уже не бонус, а нормальный навык разработчика.


Сегодня скидка 60 процентов:
https://stepik.org/course/288218/info


Rust dan repost
👣 Я заставил LLM писать Rust полгода. Вот что они стабильно ломают

Полгода я использовал Claude, GPT и Cursor как основной инструмент для написания Rust-кода в проде. Не как «помощник для бойлерплейта», а как полноценного второго разработчика на монолите примерно в 80 тысяч строк (бэкенд обработки потоковых данных, tokio, sqlx, немного unsafe в hot path).

Доля сгенерированного кода в коммитах последних шести месяцев около 40%, остальное это правки, рефакторинг и места, куда модель я не пускаю.

За это время накопилась коллекция ошибок, которые модели делают с пугающей регулярностью, и которые проходят cargo build, проходят cargo test, иногда даже проходят cargo clippy, и при этом являются либо UB, либо логически некорректным кодом, либо тем самым «работает на моей машине».

Я не буду писать, какая модель лучше. К моменту публикации статьи рейтинг устареет. Я расскажу про категории ошибок, которые воспроизводятся у всех топовых моделей весной 2026 года, и которые упираются не в качество обучающих данных, а в фундаментальные слепые пятна архитектуры трансформеров применительно к системе типов Rust.

Цифры, которые буду приводить дальше, получены так: я завёл бенчмарк из 50 типовых задач (написать функцию, отрефакторить, добавить фичу), прогонял каждую через четыре модели в течение полугода, и руками классифицировал ошибки. Это не academic-level статистика, но порядки величин показывает.

🔜 Читать дальше

@rust_code


20-летний парень заработал $37 250 за месяц на YouTube-контенте, почти не открывая монтажку.

Он собрал автономную «фабрику контента», где Claude работает мозгом, а Premiere Pro - руками. Система крутится 24/7, пока он просто живёт своей жизнью.

Claude анализирует ниши с высоким CPM, пишет сценарии и через Python-скрипты запускает озвучку и генерацию видео. Уже в первый месяц один из его каналов набрал сотни тысяч просмотров на Shorts.

Одно клиентское видео за $400 - 15 минут работы ИИ - $400 прибыли.

20 видео в неделю - $8 000.

У него была идея, а Claude сделал всё остальное: от первой строки сценария до финального рендера.

https://x.com/shmidtqq/status/2053216306384515081

20 ta oxirgi post ko‘rsatilgan.