Всеволод Викулин


Kanal geosi va tili: Rossiya, Ruscha


Объясняю, как сделать AI системной бизнес-функцией, а не чередой бессмысленных пилотов.
Стратегия для руководителей — vikulin.ai
Для связи — @seva_batareika

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Мне сегодня 31

AI-эксперт — он как вино. Хорошеет с каждым годом!

А благодаря вам у меня был отличный год. Мы читали посты, ходили на конференции и откладывали в туду лист большие статьи. Спасибо вам за это.

Кстати, если хотите мне что-то подарить — подарите мне внимание и прочитайте мою последнюю статью!

Только ради бога, не просите просто саммери у ChatGPT. Это ровно тот контент, которым жалко делиться с ИИ.


Кто должен внедрять AI в корпорацию? Новая статья

Любые технологические трансформации это сложно. В первую очередь, потому что организации требуются новые компетенции. Поэтому возникают новые профессии.

Мы с командой довольно сильно продвинулись в этом. Ключевые выводы я написал в новой статье. Там вы найдете:

- Почему возникают новые роли

- Кто такой Forward Deployed Engineer

- Что будет с профессией в будущем, и какая роль будет вместо нее

Как всегда, жду ваши вопросы/мысли в комментариях или в личных сообщениях.


Решаем бизнес-кейс

У большинства сложных проблем нет единственно правильного решения. На своих занятиях я люблю разбирать их в виде кейсов.

Делаем автоматизацию бухгалтерии. Взяли последнюю GPT: все работает, метрики хорошие. Но данные нельзя отдавать во внешние API, поэтому пересаживаемся на опенсорс. Берем любимую версию Qwen, тюним промпт — качество сильно отстает. Перед вами встает вопрос: что делать дальше?

Базовые мысли

Если на GPT все работает, значит, вы уже собрали весь контекст. То есть все знания у модели есть, просто ей не хватает интеллекта, чтобы правильно их использовать. Значит, интеллект нужно как-то добавить. Каким образом это можно сделать:

1. Взять LLM побольше.
2. Дать LLM порассуждать подольше.
3. Сделать сложный харнесс: контекст-инжиниринг, мультиагентность, вот это все.
4. Дообучить модель.

В чем размен каждого варианта

При одинаковом качестве важны два свойства:

1. Стоимость работы: а) сколько GPU нужно купить; б) сколько людей нужно, чтобы решение не развалилось.
2. Стоимость улучшения: насколько дорого переходить на новую технологию.

Разложим все четыре варианта по этим двум осям.

1. LLM побольше. Дорого из-за GPU. Поддерживать недорого: просто следим за инференсом. Улучшать дешево: просто подменяем модель и получаем тонны профита.

2. Рассуждать подольше. Также как пункт 1, только платим не столько за размер модели, сколько за токены.

3. Делать харнесс. По железу может быть дешевле пунктов 1 и 2, потому что можно работать с моделями поменьше (например, рекомендую харнесс Т-Серч, реально помогает). Но улучшать его сильно дороже: новая модель в старом харнессе может не дать аплифта, и его придется полностью переделывать. LangChain переделывал свой харнесс Open Deep Research 3 раза за год.

4. Дообучать. Инференс можно гонять на модели поменьше, зато нужна ML-команда. Вы попадаете в проблему data drift и постоянного переобучения. Новые модели тоже придется дообучать, и не факт, что это получится тем же кодом.

Что выбрать

Все зависит от вашей ситуации.

— Если кровь из носа нужен эффект с самой дешевой экономикой прямо сейчас, делайте 4.

— Если готовы немного переплатить за счастье в будущем, выбирайте 3 и старайтесь делать харнесс как можно легче. Вам все равно потом его переписывать.

— Если вы богатый Буратино, идите в 1 или 2: через 5 лет скажете себе из прошлого спасибо. Это, кстати, известный принцип — The Bitter Lesson. Его в 2019 году сформулировал Ричард Саттон, один из отцов современного RL: в долгосрочной перспективе всегда выигрывают методы, которые масштабируются вычислениями.

Иногда эффект автоматизации настолько мал, что правильный ответ — вообще ничего не делать. Честно сказать, что сейчас эту задачу выгоднее не автоматизировать. Подождать, пока опенсорс созреет, и тогда сорвать это сладенькое яблочко.

Вы же помните, что мы решали бизнес-кейс?


Кому можно вайбкодить и как это делать

Управление AI-агентами очень похоже на управление людьми. Это мало кто в индустрии понимает, но я попробую вас убедить на самом простом примере — вайбкодинге.

Про вайбкодинг есть два крайних мнения: от «программисты больше не нужны» до «пользы никакой, раньше писали код, теперь ревьюим Клод». Давайте разберёмся, как к этому подходить, вдохновляясь дисциплиной, которой люди хорошо овладели. Менеджментом.

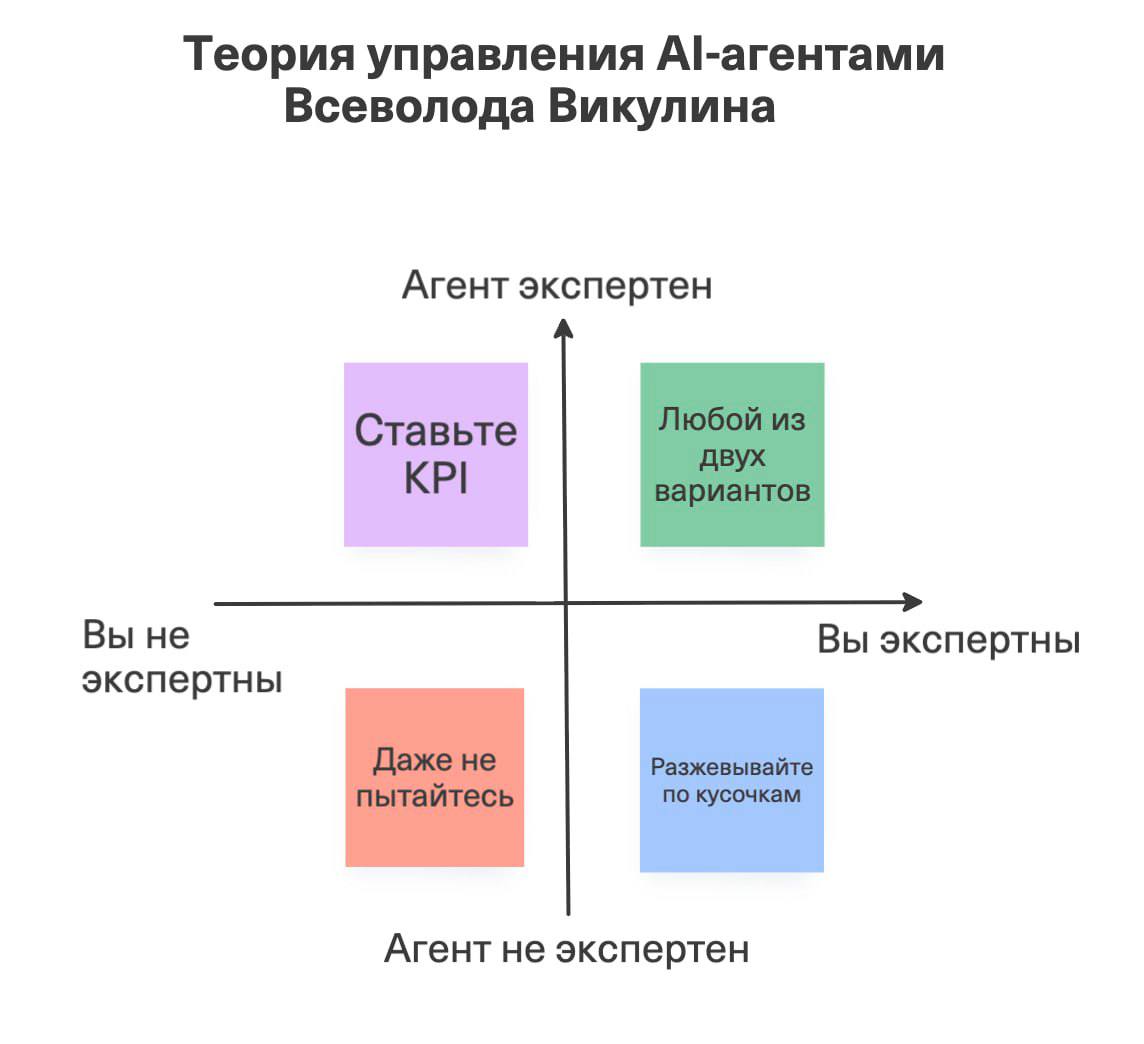
Базовая теория управления от Всеволода Викулина

Есть два ключевых фактора, от которых зависит, как передать работу другому исполнителю: экспертность исполнителя в задаче и ваша экспертность в задаче.

— Вы эксперт, а исполнитель нет. Тогда вам нужно самому декомпозировать задачу до такого уровня, чтобы исполнитель был экспертен в подзадаче. Потом принять результат подзадачи, дать следующую, и так далее.

— Вы не эксперт, а исполнитель эксперт. Декомпозировать сами вы уже не можете. Но совсем не контролировать нельзя, а то наделает всякого. Вы не контролируете его по ходу работы, а ставите конкретные KPI, которые он должен выполнить. Например, пройденные тесты, скорость работы и тд. Но не забывайте тут закон Гудхарта.

— И вы эксперт, и исполнитель эксперт. Идеальная комбинация. Можно пробовать оба варианта: и KPI навесить (он же эксперт, сам разберется), и расписать, что конкретно делать, если вы считаете, что вы самый умный (у меня так).

— Ни вы, ни исполнитель не эксперты. Ну, вы понимаете, что будет.

Не вайбкодер, а багодел

Может ли менеджер навайбкодить простой личный сайт? Может, даже если он не разбирается в разработке (я, кстати, навайбкодил). Клод в этом давно экспертен, а результат легко проверить глазами.

А сложный сайт с базой данных и регистрацией уже не сможет. Клод всё ещё экспертен, но менеджер не сможет чётко объяснить, что именно нужно сделать. И не напишет тесты, на которых агент будет проверяться, а глазами такое не проверишь. Нечем проверить результат — получаете багодельню. Я сам видел много сайтов AI-консалтеров, где не работала половина функционала.

Может ли опытный разработчик довайбкодить большую корпоративную легаси систему? Может, если разобьёт задачу на понятные куски и аккуратно объяснит Клоду, что надо делать. В этой задаче Клод пока не эксперт. И даже тесты ему не помогут. Возможно, следующие модели будут лучше навигироваться по тонне легаси-кода, но не уверен.

Вместо резюме

В менеджменте агентов нет ничего уникального. Вы на самом деле всё это уже умеете делать со своими коллегами.

Хотя нет, всё-таки есть. Агент не принесёт вам оффер, что другой человек платит ему x2 за те же токены. В OpenAI до этого ещё не додумались. Пожалуйста, не подсказывайте им.


Кто управляет разработкой AI-проекта

Несколько лет назад во время очередного релиза я понял, как называется моя профессия. Проджект-менеджер. Почему-то многие фыркают на это название. Ну, деливери-менеджер. Ну ладно, AI-деливери-менеджер. Так точно должно звучать круто. Сейчас обсудим, что это за зверь и как им стать.

В чем задача?

Довести проект до прода. И чтобы он был успешным для бизнеса. Как вы понимаете, учитывая плачевную статистику AI-проектов, сделать это сложно. А чтобы ваши проекты были успешными, вам одновременно надо иметь:

— Техническую адекватность. Вы должны хорошо знать ML, базово — бэкенд, немного фронтенд и продакт-менеджмент. Не лучше всех в команде, но достаточно, чтобы выслушать профессионала и понять его.

— Хорошие софты. Лидерство. Короче, чтобы с вами было хорошо и приятно работать.

— Любовь к принятию решений. Вы не самый сильный технарь, но вы должны брать на себя ответственность за финальное решение. Вам должно быть ОК принимать решения в условиях неопределенности. И отвечать за принятое.

Откуда такие берутся?

На самом деле пересечение этих трех осей довольно редкое. Такой милый технарь-решала (прям мой портрет, ей-богу!).

Обычно они вырастают из двух профессий. Либо ML-щики с высокой тягой к ответственности и бизнес-эффектам (ваш покорный слуга). Либо продакты с инженерным образованием и желанием прокачиваться в тех. скилах. Я видел успешные кейсы и тех, и других.

Хорошим проджект-менеджером AI-деливери-менеджером можно стать за несколько лет внедрения реальных кейсов. Успешного внедрения.

Карьерные перспективы

Это очень-очень дефицитная профессия. Ее уже не хватает, и дальше будет не хватать все сильнее. Взять этот ваш AI, собрать команду головорезов технарей и нанести непоправимую пользу бизнесу — это будет все востребованнее.

Наносить пользу можно в разных масштабах: один агентик в соло, пять агентиков с командой — и вот ты уже трансформируешь огромную операционную функцию. Дальше можно и всю компанию!

А что дальше?

На самом деле, с точки зрения именно менеджмента, это довольно несложная профессия. Потому что это управление твоей продуктовой командой. Короче говоря, ты босс своего проекта.

Более сильное менеджерское кунфу — это управление людьми, которые вне твоей команды. Там свои отдельные техники. Про это я тоже напишу пост. Когда сам разберусь. Обязательно разберусь, вот увидите.


Всеобъемлющая статья про инференс LLM

Многие у меня спрашивают, как посчитать GPU и как после этого сохранить рассудок. Потому что насчитали столько, что даже начальник, который очень-очень любит ИИ, не окнет.

Теперь у меня есть для вас решение: прочитать мою статью и начать оптимизировать насчитанное.

Всю статью старался писать максимально простым языком, чтобы было понятно не только хардкорному инженеру. В ней есть:

- Как устроен инференс LLM
- Как оценить, сколько на него нужно GPU
- Какие есть методы оптимизации
- В каких движках это релизовано

Читайте, делитесь с друзьями.

И задавайте вовпросы в комментариях или в личные сообщения @seva_batareika.

4.2k 1 112 2 79

Как стать AI-native компанией

AI всегда был гонкой инфраструктуры. Если вы хотите крутые AI-продукты, пожалуйста, сделайте логирование всех данных, сложите их в огромное хранилище, потом варите из этого таблички, а сверху табличек обучайте модели на кластере. Хотите покруче — переходите на новую инфраструктуру. Через 2 года сможете. Чтобы варить лучшую AI-кашку, нужно иметь дорогой горшочек. Почти из золота.

Мне, кстати, никогда это не нравилось. Я люблю 80% эффекта за 20% усилий. Поэтому мне нравится искать дырки в заборах: нетривиальные решения, которые срезают дорогие и долгие углы. Вот, например, последняя дырка в заборе — как мы описываем процесс для автоматизации через агентов. Дешево и быстро. А дорогие и долгие процессы мне не нравятся. Как-то неспортивно.

Вот сейчас открылась огромная дырень в заборе технологичности. И я просто кайфую. Готовы узнать какая?

AI может сам писать код. Наверное, вы ожидали инсайда покруче. Давайте еще раз. Дорогая инфраструктура — это код. AI может сам писать код. Так должно стать понятнее.

Нету хорошего интерфейса для разметки? Навайбкодь его. Нет всех тулов для агентов? Навайбкодь их. Нету бизнес-описания процесса? Ах да, только что рассказывал.

Конечно, мне стало тяжелее. Психологически. Стало сильно меньше отмазок, почему мой проект не взлетел. Надеюсь, так не только у меня.

Ценность софта будет падать. Я допускаю, что через год Codex за 2 недели работы сделает с нуля неплохую A/B-платформу. Куда тогда инвестировать, если не в инфраструктуру?

В людей. Инвестировать надо в людей. Именно этим я занимаюсь в этом канале и каждый день на работе. Один умный человек с правильными инструментами может найти дырку, пролезть в нее и вылезти обратно уже с мешком аплифтов.

А если у вас есть бодрая опытная команда, она может собрать AI-экскаватор, которым уже можно дырявить огромные бетонные стены. И загребать ковшом тонны профита.

AI-native — это люди. А не GPU, хранилища, кластера и крутые платформы. Главное — собрать таких людей. Ну и чтобы они потом не разбежались.

Вы ведь не уйдете, правда?

4.2k 1 48 14 94

Первый обзор научной статьи в этом канале

Я не фанат читать свежие статьи. Сам когда-то занимался физикой и понимаю: 99 % работ никогда не доходят до применения. Читать сто статей, чтобы найти золото, я не могу — я не металлоискатель. У меня свой метод.

Я статейный ждун. Жду, когда компании, у которых R&D-отдел в сто раз больше моего, перепробуют все эти статьи и найдут, что реально работает. А потом хитрый ждун про это узнаёт: от знакомых, из пресс-релизов или из тех же статей, но уже от самой компании — с комментарием, где оно работает в проде.

Сегодня смотрим на метод, которого я дождался, — AlphaEvolve. По слухам, его уже вовсю применяют наши большие западные коллеги. А теперь и я сам убедился в адекватности подхода. Садитесь поудобнее.

Что такое AlphaEvolve

Статья Google DeepMind.

Идея проста. Если у вас есть метрика, которую можно посчитать автоматически, — вы можете оптимизировать под неё промпт. Не трогая веса. Генетическим алгоритмом. В статье делали для кода, но метод работает для любой задачи, где есть внятная метрика.

Стартуем с одного промпта, складываем его в базу. Дальше цикл. Из базы достаётся промпт-родитель, а вместе с ним ещё несколько соседей — часть лучших, часть просто непохожих, чтобы не залипнуть в локальном оптимуме. Всё это уходит в LLM вместе с метриками качества: посмотри, что уже пробовали, предложи точечную правку промпта-родителя. Правку накладываем, считаем метрику, удачное возвращается в базу. И так тысячи раз.

Что этим методом наоптимизировали в самой статье:

— планировщик Borg: 0,7 % всех мощностей Google, больше года в проде
— FlashAttention: в одной боевой конфигурации инференса ядро на 32 % быстрее
— и даже побили рекорд перемножения комплексных матриц 4×4

Но применять можно к чему угодно. Хоть к классификации текстов: тюним промпт по F1 на обучающей выборке, финально меряем на тестовой (только не перепутайте!).

Почему я думаю, что за этим будущее

Одно слово. Интерпретируемость. Это основная проблема всех AI-моделей. А тут вы буквально видите, что «оптимизатор» выучивает из обучающей выборки.

Когда вы оптимизируете веса, вы живёте в чёрном ящике. Может, у вас датасет смещён и модель учит вообще не то — узнаете вы об этом уже в продакшене. Когда вы оптимизируете текст, на каждой итерации видно, что именно в него вносится. И нежелательное изменение можно откатить.

Ещё вы можете явно задать правила оптимизации: про это пиши, про это не пиши. Настоящий рай для любителей всё контролировать (мне, например, очень нравится).

Что вам надо делать сейчас

Важно: это работает, но только на крупных моделях, которые умеют в длинный контекст. Ваш любимый 1.5B Qwen не вытянет. Но на топ-тир моделях оно заводится.

А если нужно подешевле, то давайте дистиллировать результат в веса любимого Qwen'а. И весь такой цикл работает по кнопке: автоматически подобрали промпт на крутой модели, автоматически продистиллировали в веса маленькой.

Думаю, вскоре и обычные Qwen'ы научатся так делать.

И нафига тогда я отличия Adam от SGD в универе учил?


Вам LLM побыстрее или подешевле? Выберите только одно

Почему-то во всех командах, где я работал, я всегда отвечал за оценку, сколько нам надо GPU. То ли я выгляжу очень экономным, то ли авторитетным. Хотя для оценки GPU надо быть скорее везучим. Потому что оценить, во сколько нам влетит инференс — очень хитрая задача. И зависит это в первую очередь от терпения наших пользователей. Давайте вместе разбираться.

Предсказание в LLM идёт токен за токеном, слева направо. И в прошлом посте мы выяснили, что инференс LLM тормозит, потому что мы на каждый токен гоняем миллиарды весов модели по памяти видеокарты.

На самом деле, я вас тогда капелюшечку обманул. Помимо весов модели, нам придётся гонять ещё матрицу с результатами прошлых вычислений — чтобы не пересчитывать заново всё. Хранятся там K и V каждого прошлого токена, отсюда и название: KV-кэш. Подробнее про это самые любознательные инженеры могут почитать вот тут.

И иногда он даже может занимать памяти больше, чем миллиардные веса модели.

ТУТ НЕМНОГО МАТЕМАТИКИ, БОРИТЕСЬ ИЛИ ПРОПУСКАЙТЕ

KV-кэш занимает =

2 (K и V) × слои × число KV-голов × размер головы × байт × длина контекста

Допустим, у нас 60 слоёв, 8 KV-голов, размер головы 128, и храним кэш в fp16:

2 × 60 × 8 × 128 × 2 = 245 760 байт ≈ 246 КБ на токен

Тогда, если контекст 2000 на 1 запрос:

245 760 × 2000 ≈ 0,49 ГБ =

= Полгигабайта памяти. На один запрос.

Сева, ну и что нам с этих полгигабайта?

Память = размер модели + батч × размер KV-кэша

И тут ключевое: веса общие для всех запросов в батче, а KV-кэш у каждого свой. Поэтому веса делятся на всех, а кэши складываются.

Возьмём модель 35B в fp8 — это 35 ГБ. Если батч маленький, KV-кэш мал, на него можно забить. Но если батч 100, то кэш уже 50 гигабайт — больше, чем сама модель, и основное время будет уходить на его загрузку.

Итого очень понятный размен: больше батч — мы загрузили модель 1 раз и параллельно предсказываем весь батч. То есть больше пропускная способность видеокарты (токены в секунду), то есть можем держать больше запросов, то есть нужно меньше карт. Но при этом больше KV-кэш, дольше наш пользователь будет ждать своего ответа.

Можно легко построить график, как время между токенами зависит от пропускной способности карты (я Клод вроде справился). Если интересно, в комментах напишу промпт формулы, как такое рисовать.

Сева, а что нам делать-то?

Учиться терпению! Ну или платить. Очень простой план:

Шаг 1. Думаем, сколько пользователь готов ждать. Обычно ничего умнее, чем 5 секунд, не придумывается. Интересно, у всех так?

Шаг 2. Прикидываем пиковый RPS в сервис. Потом умножаем на 1.5, потому что прикинули плохо.

Шаг 3. Берём 1 карту, берём корзинку входных запросов (с продовым распределением, чтобы KV-кэш был честный). Бенчим ваш инстанс (команда vllm bench serve). Смотрим p50/p95/p99 перцентили. Расстраиваемся.

Шаг 4. Не хватило — делаем карты ×2, батч падает в 2 раза, время ответа падает по нашему графику. Правда, не в 2 раза, а процентов на 20, увы. Повторять до целевых 5 секунд.

Шаг 5. Видите, что вам нужно 100500 карт — сначала расстраивайтесь. А потом думаете. Может, они могут немножко подождать?))) Я там стриминг намучу, UI красивый сделаю, мемы смешные буду показывать, пока ответ загружается. И на одной H100 как-нибудь протянем...

Говорила мне мама, терпение — золото. 30 лет прошло. И только сейчас до меня дошло.


Какие команды добиваются экстраординарных результатов

Я ужасный разработчик. Если бы вы видели мой код в проде, вы бы отписались от этого канала.

Я довольно неплохой ML-щик: знаю много разных методов (потому что я старый)). Но многие в нашей команде сильно продвинутее меня.

Но я отличный менеджер. Если брать менеджмент в ML, я бы, думаю, попал в топ-30 до 30 :) Так что иногда буду писать про управление командами.

Какие команды добиваются экстраординарных результатов? Маленькие. Есть пошлое слово talent density — вот это про это. Почему так?

Во-первых, бизнес-эффект нелинейно зависит от качества решения. Агент, сделанный на 10% лучше, может дать экономию на 10 тысяч % больше. А качество решения в сложных R&D-задачах определяется самым сильным человеком в команде, а не суммой всех человеков. Так что вам выгоднее, чтобы самую сложную и дорогую проблему решил один гений, а не двести средних.

Во-вторых, главная мотивация сильных людей — вы не поверите — работать с сильными людьми. Поэтому если хотите кого-то нанять и удержать, придётся вырастить вокруг него интеллектуальный сад сильных коллег.

Ну и приятный бонус для менеджера. Когда команда маленькая, вы можете каждую секунду направлять самого сильного человека на самую важную проблему. И убирать все препятствия, что ему мешают. Вы ведь сильный менеджер, правда?

Конечно, есть большие и понятные задачи — например, интеграции чего-то с чем-то. Работа ясная, её просто очень много: надо сесть, заспекать огромный функционал и навалиться. Никакой десант гениев тут не поможет. Хотя…

Есть же ИИ-агенты. Может ли один гений со ста Клод-кодами сделать работу, на которую раньше нанимали крупного интегратора? Доживу ли я до этого?

Шучу, конечно доживу. Я даже думаю, что я это сделаю. Шучу. Мы это сделаем.

3.1k 0 32 13 89

Улучшаем качество без обучения. Диаграмма контекст–compute

Я много писал про важность контекста — пришло время упаковать это в нормальную схему. Напомню: у вас два рычага — вычисления на инференсе и контекст.

Шаг 0. Берём самую жирную модель, что доступна, и включаем ризонинг, чтобы рассуждала подольше. Экономика не бьётся — пофиг, бабки не проблема.

Шаг 1. Берём датасет, прогоняем на нём наш космолёт, смотрим ошибки, собираем контент, который эти ошибки исправляет. Лучше делать это в цикле через другого агента — подробнее тут.

Шаг 2. Потом окажется, что знаний дофига, но в них сложно ориентироваться, и модель начинает тупить. Теперь мы упрощаем доступ к знаниям. Улучшаем описания тулов, добавляем заголовки и теги. Строим харнесс, чтобы подсасывать в модель только лучшее. Часть контента дропаем, часть суммаризуем. Тут в итоге должно случиться офигенное качество.

Шаг 3. Начинаем сжимать модель — и тоже через контекст. Модель меньше, но это не беда, ведь у нас есть эталон из шага 2. Теперь мы пишем контекст, но чтобы мимикририровать под ответы большой модели. Для этого можно использовать разные алгоритмы оптимизации, например, генетические алгоритмы (никогда не думал, что на полном серьезе это напишу). Написали ответ -> сравнили с большой моделью -> дифф рассуждений отправили в промпт. Да, вы правы, это очень похоже на дистилляцию. Это она и есть. Качество может просесть, но не так сильно, как кажется.

Готово, вы восхитительны.

Кстати, всё это делается прямо по API, вообще без своих GPU. Главное — чтобы был эвал, под который собирать контекст. Дальше уже дело техники.

Про детали этой техники есть много интересных идей/статей, обсудим их вместе с вами.

3.1k 1 62 11 59

Запись моего выступления на Data Fest

Находится вот тут. Говорил про экономику и стратегию. Про правильные процессы и полезных в них агентов. Про платформы и форвард-деплойд инженеров. И много шутил.

Местами даже удачно. Местами мне до сих пор неловко.

Вам точно понравится.


Внедрить AI — это испить чашу боли. А можно ли иначе?

Во-первых, я говорю только про крупные внедрения, которые видны в P&L компании. Если вы сделали ассистента, которым никто не пользуется, — это тоже больно, но по-другому.

Во-вторых, я не говорю про «продуктовый AI» — это когда у вас большая поверхность в продукте и похожие задачи на входе. Рекомендательные системы, поиск, кредитный скоринг и так далее. Там тоже тяжело, но тяжело технологически. А я — про боль.

Мне больно, потому что У ВСЕХ ВСЕ ПО-РАЗНОМУ. Каждый процесс в поддержке отличается от соседнего. Так же будет в бухгалтерии, в разработке и где угодно ещё. У всех миллион интеграций, и большая часть из них устроена по-своему — как будто только для того, чтобы мне было больно (подробнее читайте в моей статье).

Хитрый трюк: сделать так, чтобы больно было, но не вам

Платформа. Накрутить заранее миллиард кастомизаций, закопать их в двадцать слоёв интерфейса и написать три тома документации. Чтобы потом каждый смог сам себе встроить агента (если разберётся).

Проблема: это очень много кода. Все возможные эвалы, интеграции, методы тюнинга промптов заставят огромную команду долго потеть. Так можно — если у вас есть венчур и умение делать продукт.

У меня нет ни того, ни другого. Поэтому платформу из миллиарда строчек кода я делать не хочу.

Вы не поверите, но я опять буду делать агентов. Код-агентов.

— Агент, который напишет тулы под конкретную интеграцию.
— Агент, который оценит итоги конкретного A/B-эксперимента.
— Агент, который подберёт промпт для конкретного агента (мы разбирали тут).

Звучит как фантазия спятившего менеджера, но оно заводится. Об этом я рассказывал на недавнем митапе.

Моя платформа — это тончайший слой поверх галеры AI-гребцов, которые под ключ сделают любую кастомную интеграцию. Без кучи денег на разработку. На слабоумии и отваге. По-моему, неплохое топливо.

Ну а чего вы от меня ожидали?


Чтобы ускорить инференс LLM, надо всего лишь... ЧИТАТЬ ДАЛЕЕ

Не все понимают, что тормозит инференс LLM. Сейчас расскажу — и, честно говоря, дальше вы уже сможете без меня. Почти вся оптимизация следует из этого. Всему виной то, что мы...

ГОНЯЕМ ВЕСА ТУДА-СЮДА

Совсем базово. В GPU, как и в других вычислительных устройствах, есть два класса памяти: DRAM и SRAM (хихихи, но не так смешно как JEPA у Лекуна).

DRAM — относительно дешёвая и относительно медленная. Именно туда вы загружаете модель, когда поднимаете инференс. Допустим, у вас модель на 35B параметров и вы храните её в fp16 (2 байта на вес). Значит, нужно 70 ГБ DRAM. Дальше разбираем на примере H100: там 80 ГБ. Влезло.

SRAM — дорогая и быстрая. Дорогого и быстрого логично давать умеренно. В 1000 раз меньше. Зато SRAM сидит вплотную к ядрам, на которых и происходят вычисления. Поэтому веса модели перетекают из DRAM в SRAM — на H100 со скоростью 3,3 ТБ/с.

Теперь самая тупая математика. Чтобы перетащить 70 ГБ весов со скоростью 3,3 ТБ/с, нужно 70 / 3300 = 21 мс.

Декодинг идёт токен за токеном, то есть ради каждого проклятого токена надо каждый раз прогнать через шину эти проклятые 70 гигабайт. Поздравляю, ваша максимальная скорость — 1 / 21 мс = 47 токенов в секунду. Прочувствуйте это. Мы еще ничего не считаем. При полной загрузки 70 ГБ весов вы никак не сделаете декодинг на 1 H100 быстрее 47 ток/секунду.

Это, мне кажется, действительно забавно. Вы купили за много миллионов рублей H100, которая умеет делать ОДИН КВАДРИЛЛИОН операций в секунду. Я даже гуглил это слово. А карта сидит холодная, потому что всё время уходит на перекачку весов. Это называется тупизм memory-bound режим.

Чтобы не быть настолько идиотом, возникает логичная идея. Раз я уж эти проклятущие веса из DRAM в SRAM перегнал — может, я обслужу не один запрос, а сразу несколько? Веса-то одни и те же. Чтобы H100 моя родненькая не стояла холодненькая.

Поздравляю, вы придумали батч. Если растить батч больше и больше, рано или поздно вы упрётесь уже в сами вычисления, в эти самые квадриллионы операций. Тогда вы попадёте в compute-bound режим.

Теперь реально понятно, как ускорять

— Квантизация. Храним вес не в 2 байтах, а в 1 или меньше — гонять через шину нужно вдвое меньше данных.

— Спекулятивный декодинг. Маленькая модель набрасывает несколько токенов, а большая проверяет их за один проход — то есть за одну прогонку весов.

— MoE-архитектура. Из памяти на каждом токене читаем только активные веса, а не всю модель (с батчом это работает хуже, обсудим потом).

И много чего ещё. И всё — вокруг одной и той же проблемы.

Часто, чтобы разобраться с кучей инженерных методов, надо понять всего один базовый принцип. Сегодня мы поняли его для инференса: ХВАТИТ ГОНЯТЬ ВЕСА ТУДА-СЮДА.

Теперь у вас точно всё получится ^^


Бизнес-модель моего телеграм-канала

Клянусь вам: раз в неделю мне пишут продюсеры онлайн-курсов. «Сева, у тебя такой классный контент, но ты не монетизируешь его на максимум! Давай опрос проведём, вороночку построим, курсик запишем, прибыль поделим».

После быстрого ответа «Нет» они удивляются: а зачем тогда всё это, если не ради того, чтобы стричь бабло? Сейчас расскажу.

Я хочу собрать самое крутое сообщество, которое внедряет AI в бизнес. По-настоящему.

Не придумывает бесполезные стратегии AI-трансформации.
Не вайбкодит личного ассистента для почты генерального директора.
Не продаёт курсы «Как стать AI-native мясокомбинатом».

Я собираю людей, которые действительно хотят менять этот мир с помощью AI, и помогаю им этого добиться. Тремя способами:

— бесплатным советом (просто пишите в личку с вопросом);
— совместной работой (мы нанимаем :));
— вот такими, надеюсь, не самыми бесполезными постами.

Для вас я делаю этот канал, для вас пишу этот пост — и безумно благодарен вам за доверие. Нас уже 5 тысяч. Мы провели первый совместный митап. Спасибо, друзья: наше сообщество начало строиться.

Отдельно благодарю Юлю — мою самую преданную подписчицу и любимую жену. Без её поддержки я бы за это точно не взялся. Ну правда, вы посмотрите на эти подарки!

Торт уже во мне.

2.8k 0 13 11 243

5 лет проведения собеседований в одном посте

Эта картинка стоила мне 5-ти лет опыта нанимающего менеджера и 3-х лет интенсивной психотерапии.

На финальной встрече я редко спрашиваю что-то про LLM. Во-первых, потому что уже до меня спросили. Во-вторых и в главных — потому что я уверен, что это не главное. Те методы NLP-разработки, которые применяем мы сейчас, год назад не использовал вообще никто. А еще через год все снова поменяется. Главное, что я ищу в кандидате, — это софты. И главный из них — бодрость.

Термин я украл у бывшего руководителя из Яндекса. Уверен, что, если спросить нас обоих, мы дадим разные определения этого качества. Но при этом я уверен, что понимаем мы его одинаково.

Бодрость — это когда человека просишь, и он решает. Он не просит у тебя точного ТЗ, он сам задаст все вопросы. Он не думает про Scrum и Kanban: если нужно, он сам навайбкодит себе подходящий фреймворк. Он сам найдет бездомную команду и внушит ей, что теперь для нее это самая важная задача в мире. Он думает про результат и с улыбкой относится к неопределенности его достижения.

У меня даже появился тест на бодрость: если в проекте неожиданно всплывает задача, которую хрен пойми как делать, но надо очень и еще вчера — на ум приходит он. Тот самый мистер Бодрость.

Выявлять это чудесное качество можно при разговоре. Слушайте, за что человек отвечал в проекте. Если МЛ-щик писал веб-приложение, потому что все разработчики были заняты, — мне он нравится. А если он еще и никогда раньше этого не делал и сам разобрался с ЧатГПТ — мое сердечко бьется сильно-сильно.

Не на все задачи нужны бодрые. Во-первых, им бывает скучно, и вам придется постоянно их челленджить. Во-вторых, они не подходят для системной работы. Если составить команду только из них, они через какое-то время закопаются в своей бодрости. И разрушат вам продакшен. Помимо бодрых, нужны люди, которые умеют строить системные процессы. Долгие цели, спринты, демо, груминги… Что там еще есть? Я — не умею. Я — бодрый. Поэтому я их нанимаю :)

3.6k 1 112 11 129

Как вам улучшать LLM, если я запрещаю их дообучать

Я, кажется, самый большой хейтер дообучения в индустрии. Не потому что не умею — а потому что это технически очень сложная задача, которая может сломать вам жизнь LLM. Писал подробнее тут и тут.

И каждый раз слышу в ответ: ты, конечно, умный, Всеволод, но вот у нас качество не 100 %. Как нам улучшать модель без обучения?! Любимая привычка двигать веса в сторону локального минимума засела в нас так крепко, что мы разучились делать все остальное. Что ж, будем меняться.

1. Самое главное — контекст. Это ровно тот же backpropagation, только через текст, а не через веса. Посмотрите на цикл: модель ошиблась → вы нашли примеры, где она ошибается (на самом деле другой агент нашел) → дописали их в контекст → перезапустили замер. Очевидные плюсы. Веса не меняются, можно сервить в одном месте. Все очень наглядно — можно глазками проверить, что сейчас меняется. Легко пофиксить, если ваш начальник увидел в проде не понравившийся ему ответ. И главное — это, черт возьми, работает. Уже есть огромное число статей, многие из которых нам придется вместе разобрать, чтобы удостовериться.

2. Второе — сompute. То, насколько много вычислений вы тратите на инференс модели. Для LLM есть даже отдельные законы масштабирования, которые показывают, как растет качество, чем больше вычислений вы наваливаете. Берите модель с параметрами побольше. Дайте ей порассуждать подольше. Побейте задачу на подзазачи, решите разные промптами. Дорого? Оптимизируйте инференс. Есть куча методов, один из них мы обсуждали на митапе.

Работы у нас с вами будет еще очень много. Только, думаю, не придется learning rate по графику подбирать. А вам это нравилось? Мне, если честно, не очень. Уж лучше json md-файлики перекладывать.


Если вы пропустили наш митап по внедрению GenAI в обслуживание

То мы его записали: YouTube и ВК. Там 4 крутецких доклада:

1. Вводный про стратегию и платформу

2. Как мы замеряем качество агентов

3. Про спекулятивный декодинг

4. GenAI поверх интерфейсов сотрудников.

Рекомендую смотреть ровно в таком порядке. Ссылки на презентации на странице мероприятия.

Будут еще крутые митапы, где мы будем собираться нашем уютном комьюнити и делиться, как внедрять агентиков в суровый энтерпрайз.

Честно. Технологично. И с чувством юмора :)


Один контекст, что правит всеми

В прошлом посте мы обсуждали, как устроена оценка агентов вообще. Сейчас я расскажу, что конкретно делаем мы. И почему я считаю, что это очень круто.

О что заземляться

Чтобы измерить качество агента, нужен ground truth — точка опоры, относительно которой видно, где он накосячил.

Первое, что приходит в голову — взять экспертов. Cпрашивать их: хороший ответ или плохой. Идея рабочая ровно до того момента, пока вы не захотите что-то с ней сделать. Мнение эксперта живёт у него в голове. Его нельзя пересмотреть, про него можно только на кухне поспорить. Вы получаете оценку, но не получаете рычага, как ее улучшить.

Регламент — другое дело. Агент отступил от правила — ошибка. Но нельзя просто так взять и написать эту базу знаний выписать. У людей куча правил, которые для них слишком очевидны, чтобы их проговаривать. Поэтому мы строим отдельный агентский пайплайн, который эти знания собирает, об этом я писал в посте.

Как схема идеально замыкается

— Асессор по базе размечает — смотрит на ответ агента и сверяет, где тот разошёлся с регламентом.

— Агент по ней же работает — решает обращение клиента, сверяясь с правилами.

— LLM-as-a-judge калибруется об разметку асессоров (напомню, они сами читают ту же базу) и тоже размечает

— Теоретически, по этой же самой базе может работать не только агент, но и сотрудник. Там, где агент пасует, за дело берётся живой оператор — и работает по тому же контексту, что и LLM.

Складывается в квадрат: агент и человек — те, кто действует; judge и асессор — те, кто проверяет. Четыре роли, один контекст под ними. Это делает систему невероятно гибкой. Поменял ошибку, про это сразу узнали все. Появилось новое правило, моментально проросло всей системе. Да и людей можно будет джаджами замерять :)

Конечно, интерфейсы к контексту у человека и LLM разные. Для человека есть целая область: User Interface (UI). Пока Agent Interface лучшие умы еще зарождают, можно делать по старинке: дал агенту grep — и он сам выгреб нужный кусок. И реально работает!

Где я вас обманул

Звучит слишком идеально, чтобы быть правдой. Внимательный читатель канала уже должен понять, в чем подвох.

В этой схеме мы никак не проверяем сбор самого контекста. Соберём базу криво — все наши четыре друга посыпятся одновременно.

Контекст должен полным, без ошибок и противоречий. Полноту, допустим, можно обкалибровать об ответы сотрудников. Но потом надо все проверить на адекватность с помощью других людей, например, особо внимательной команды редакторов. Приятное в том, что часто проверять базу не нужно. Только переодически просматривать по регламенту.

Заключение

Я рассказал вам все, что знаю сам (а знаю я немного). Как собирать контекст для агентов, как об него калибровать разметчиков, и как это все работает вместе. Это же наша команда рассказывала на недавном митапе (скоро выложу видео!).

Если остались вопросы, пишите в комментариях или в личные сообщения. Дальше будем активно разбирать инференс LLM.

20 ta oxirgi post ko‘rsatilgan.