Задачи DS - Собеседования, Соревнования, ШАД


Kanal geosi va tili: Rossiya, Ruscha
Toifa: Martaba


Чат: @zadachi_ds_chat
По всем вопросам: @vice22821

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Toifa
Martaba
Statistika
Postlar filtri


ШАД и Лаборатории

ШАД — это не просто диплом и не просто строчка в резюме. Это еще и доступ к специалистам, которые делают науку и индустрию. Но работают они в разных местах, и далеко не везде ШАД одинаково ценят. Где-то он открывает двери, а где-то на него вообще не смотрят. Мы собрали два списка, чтобы ты понимал, куда идти, если хочешь использовать ШАД как трамплин, а куда — если у тебя другие цели.

Где ШАД в плюс
- Лаборатория компьютерной графики и мультимедиа ВМК МГУ - её заведующий ведёт в ШАДе компьютерное зрение
- AIRI - в ШАДе преподают руководители групп «Пространственный интеллект» и FusionBrain.Robotics, а также старший научный сотрудник института
- Группа генеративного ИИ Сколтеха - её руководитель сам выпускник ШАДа и читает там курс по генеративному ИИ вместе с сотрудницей группы
- Лаборатория теоретической информатики ФКН ВШЭ - завлаб ведёт в ШАДе теорию информации
- Научно-учебная лаборатория Яндекса на ФКН ВШЭ - её сотрудники преподают в совместной с ШАДом магистратуре
- Лаборатория ИИ Яндекса - руководитель группы ML-разработки ведёт в ШАДе машинное обучение
- Лаборатория машинного интеллекта МФТИ и лаборатория МФТИ-Сбербанк - их руководители приложили руку к развитию ШАДа

Где на ШАД не смотрят
Лабы по железу и системному ПО от YADRO и Huawei. Ни одного преподавателя ШАДа оттуда нет, и в их материалах для студентов ШАД не упоминается. У них свои каналы: лаборатория YADRO в НГУ, программы Huawei при МФТИ, Бауманке и Сколтехе, Excelsior at Huawei в Новосибирске. Туда берут через свой отбор: задачи, профильная база, публикации

Хочешь в ШАД, но не знаешь, с чего начать? Наши курсы закрывают всю базу за 3 месяца, а доступ к материалам и мокам остаётся навсегда. Записывайся с гарантией поступления.
➡ Записаться

Подписаться: @codeof_art


Нужен ли ШАД, чтобы попасть в ML

Попросил выпускника-«старичка» рассказать о своих мыслях по поводу ШАДа. С некоторыми тезисами я не согласен, а другие требуют уточнений. Но решил поделиться как есть. Короче, не судите строго! Дальше слегка обработанный текст нашего выпускника.

В ML я пришёл около десяти лет назад. Хайпа вокруг ШАДа тогда почти не было: сильному студенту хватало немного подтянуть матан, чтобы поступить. Сейчас я работаю в Яндексе, в команде речевых технологий. Почти каждый мой стажёр однажды спрашивает: «Идти ли в ШАД?» — хотя на самом деле его волнует другое: «Если поступлю, меня точно возьмут на джуна/миддла?»

Я сам через это прошёл: поступил, отучился, а теперь провожу собесы. По кандидатам быстро видно, кто действительно учился, а кто вписал ШАД в резюме в надежде, что диплом никто не спросит. Бывает и наоборот: человек без ШАДа знает и умеет больше выпускника. Поэтому давайте честно разберёмся, где польза, а где миф.

Ожидания vs Реальность
Многие представляют так: два года интенсивной работы, а потом диплом, с которым берут куда угодно. За пределами Яндекса его у меня не спросили ни разу. Работодателю важно, что ты умеешь, а не где учился. Хотя строчка в резюме всё равно работает, как и сильный техвуз: её замечают.

Внутри Яндекса картина другая. Многие руководители сами выпускники, кто-то преподаёт. Они знают программу изнутри, поэтому к твоей базе относятся с другим уровнем доверия. Но и здесь диплом только открывает дверь. Дальше смотрят, как ты решаешь задачи.
По-настоящему ценное в ШАДе — не бумажка, а три вещи, которые в одиночку получить куда сложнее.

1. Фундамент
Поступал я на третьем курсе, уже работая стажёром, и был уверен, что в ML разбираюсь. По меркам того времени так и было: табличные модели, метрики, первые статьи. Сегодня это уровень вводного курса. Первая же домашка всё расставила по местам. Объяснить, почему логрег минимизирует именно такую функцию потерь, я не смог. Пользоваться инструментами умел, а их устройства не знал.

Окупилось это через полгода. Модель в проде начала вести себя странно, и я нашёл причину, а не крутил гиперпараметры наугад, как раньше. Умение не просто запустить, а объяснить, почему работает — и есть главный результат учёбы.

2. Нагрузка (и навык планирования)
ChatGPT тогда не существовало, всё писали руками. Сейчас списывать у нейронок там тоже не дают. Как я научился выдерживать этот темп, лучше покажу на примере.

Первый семестр, октябрь. На работе нужно пересобрать выборку и переобучить модель к демо в четверг. На ту же неделю выпадает дедлайн по домашке, которую я, конечно, отложил. Предупредить лида мне даже в голову не пришло: сам взялся совмещать, сам и выкручивайся. Три ночи подряд сидел над задачами до четырёх утра. Днём собирал пайплайн на автопилоте.
Четверг, демо. На графике прирост почти в десять пунктов. Лид долго смотрит на него, потом спрашивает, как я делил данные. Оказалось, при пересборке часть теста попала в трейн. Весь прирост был утечкой. Заметить её свежей головой было бы делом пяти минут. На демо сидел продакт, так что краснел я при свидетелях. Домашку в итоге тоже сдал на тройку: к третьей бессонной ночи голова уже не варила.

Вечером лид позвал меня поговорить. Вопрос был один: почему я молчал? Спринт он спокойно бы перестроил, а учёбу считал хорошим вложением и готов был под неё подстроиться. Договорились так: в дни занятий я ухожу раньше, о дедлайнах предупреждаю заранее. Легче не стало, но я кое-что понял. Выдерживать нагрузку — значит не геройствовать ночами, а планировать и вовремя говорить, где не успеваешь. Это навык, который потом не раз спасал меня в работе.

3. Люди
Это недооценивают сильнее всего. Мои однокурсники теперь работают во многих ML-командах, с которыми я пересекаюсь. Когда хочу узнать, как соседи решали похожую задачу, я не пишу в общий чат. Я пишу тому, с кем полгода сидел над домашками до двух ночи. А про новые вакансии слышу раньше, чем их публикуют.

Так стоит ли идти?
Да, если хочешь понимать модели, а не только пользоваться ими. Если готов отдать два года вечеров и выходных. И если у тебя уже есть практика, к которой можно приложить теорию.
Если же нужно побыстрее найти первую работу, есть путь короче: пара сильных пет-проектов и стажировка. А провал на первом отборе ничего не значит. Я и тогда поступил не с первой попытки.

Комментарий от «Поступашек»: Здесь нужно понимать, что за 10 лет конъюнктура рынка сильно поменялась, конкуренция выросла. Да и ШАД за 10 лет тоже изменился. Поэтому оценка автора может быть смещенной. Кроме того автор в основном рос и развивался в Яндексе, поэтому к фразе "диплом ШАДа нигде не спросили" нужно относиться осторожно. Ну и напоследок люди разные, с разными желаниями и интересами — ШАД же не гарантирует ничего, он лишь дает возможности и потенциал, а как вы всем этим воспользуетесь вопрос только к вам.

Но чтобы эти возможности вообще появились, нужно сначала поступить. Материала немала, но если начать грамотную подготовку в ближайшее время, то вы спокойно пройдете этот путь без стресса и авралов. Именно под это и заточены наши курсы по поступлению в ШАД.
➡ Записаться

Подписаться: @zadchi_ds


Рынок команд ML

Продолжаем разбирать в какую команду (отдел) сейчас залететь выгоднее. Продолжение поста.

Т-Банк
Второй после Яндекса игрок по уровню DL-я, а по некоторым направлениям уже и спорно, кто первый. Основное ML-ядро это AI-Центр, команда из 600+ человек, которая делает ассистентов и LLM-поиск по всей экосистеме банка. Внутри есть рекомендации, NLP, CV, речь, временные ряды, MLOps/LLMOps и отдельно исследования.

Скоринг / антифрод / CRM по сути это классический табличный ML, но с банковской спецификой: интерпретируемость, регуляторика, долгий цикл выкатки. Из всех табличных направлений скоринг и антифрод — вторая по востребованности история после рекламы, этим занимается каждый банк и финтех. Но надо понимать, что по факту тут будет много бустингов над фичами и мало современного DL.

LLM (Gen-T) - уникальная команда, которая делает T-Lite и T-Pro. T-Pro 2.0 является первой российской открытой моделью с гибридным режимом рассуждений и своим токенизатором под кириллицу. Это полноценный pretrain/SFT/RL-пайплайн на своих кластерах, такой опыт в России можно получить в двух-трех местах. Минус существенный - конкурс сюда сильно выше, чем в среднем по банку.

Речь - свой голосовой ассистент, открытая ASR-модель T-one, команда сильная, но узкая. По смыслу похоже на речевые команды Алисы, масштаб поменьше.
T-Bank AI Research — лаборатория, которая пишет статьи. Регулярно публикуются на топовых конференциях, особенно сильны в RL, оптимизации и робототехнике. В отличие от AIRI, это внутри банка, поэтому с зп и ресурсами заметно лучше, но и ждут, что статьи потом во что-то внедрятся. Если хочется одновременно и статьи, и нормальные деньги — один из лучших вариантов в стране.

В целом культура очень похожа на яндексовскую: много ребят из ФПМИ/ШАД, собесы жесткие (алгоритмы + ML + систем-дизайн), но темп чуть спокойнее, чем в Поиске. Если выбирать табличную команду — реклама Яндекса или скоринг Т-Банка, если DL — Gen-T, речь или Research.

VK
Самая широкая компания по количеству продуктов: ВКонтакте, VK Видео, Клипы, Музыка, Почта, Дзен, RuStore, VK Реклама. Команд много, разброс по уровню тоже большой, поэтому "пойти в VK" — это ни о чем, надо смотреть конкретную команду.

Главная сила VK — рекомендации. Лента, Клипы, Видео, Музыка — это давно не бустинги, а DL-ный recsys на трансформерах и двухбашенных моделях с огромным объемом данных. Если цель именно RecSys, то в России сильнее VK и Яндекса ничего нет, а в VK порог входа ниже. Плюс recsys продается на любом рынке — от e-com до стриминга.

VK Реклама (бывший myTarget) — табличный ML плюс немного DL, по смыслу то же самое, что реклама Яндекса, но масштаб меньше.

LLM — тут к сожалению совсем небольшой прогресс от VK. VK какое-то время делал свои foundation-модели, но, судя по недавним постам людей, которые это направление возглавляли, приоритеты внутри компании поменялись и разработку foundation-моделей сворачивают. Так что за опытом обучения больших моделей сюда сейчас я бы не шел, а вот прикладные вещи (модерация, поиск по видео, антиспам, генерация описаний) остаются.
Из минусов: много легаси, своя инфра, которая местами сильно уступает яндексовской, а уровень и темп очень зависят от команды — в ленте и видео сильные ребята, в маленьких продуктах можно надолго застрять в поддержке. По деньгам, по ощущениям, в среднем ниже Яндекса и Т-Банка.

Кто еще заслуживает внимания

Авито — сильно недооцененное место. Очень сильная DS-культура (A/B-тесты, статистика и ML-system-design на собесах), рекомендации, поиск, модерация, CV по фото объявлений. И собственный LLM-юнит: A-Vibe и A-Vision, дообученные на базе Qwen со своим токенизатором и поддержкой вызова инструментов для агентов, выложены в опенсорс под Apache 2.0. Компания заявила порядка 12 млрд рублей инвестиций в GenAI. По уровню — где-то между Яндексом и VK, по деньгам конкурентно, конкурс средний. Тут есть и табличка, и DL, и продуктовый recsys — хороший баланс.

Ozon / Wildberries — e-com, соответственно поиск, ранжирование, рекомендации, прогноз спроса, логистика. Много табличного ML и классического ranking, DL в основном в поиске и CV по карточкам товаров. Ozon посильнее по инженерной культуре, WB растет быстрее, там больше хаоса, но и больше шансов взять кусок с нуля. Не самый интересный DL, но e-com ranking сейчас нужен вообще везде.

МТС / MTS AI — формально отдельная компания, примерно как AIRI при Сбере. Делают свои LLM (Cotype), речь, много B2B-внедрений. Уровень команд неровный, ресурсов меньше, чем у первой тройки. Как первый опыт — ок, как цель — вряд ли.
Альфа-Банк — табличный ML (скоринг, CRM), но есть небольшая исследовательская группа, которая пишет статьи по event sequences и банковскому recsys. Если хочется в финтех, а в Т-Банк не взяли — нормальный запасной вариант.

Во все эти команды готовят наши курсы МЛ СТАРТ, МЛ ПРО, AI Агенты ПРО, Data Science. Там мы не только готовим к собесам, но и учимся выкатывать модели в прод, проектировать архитектуру и выстраивать карьерную траекторию. Мы настолько уверены в программе и результатах наших студентов, что даем гарантию оффера. Если вы готовы работать по нашей системе — мы доведем вас до цели.
➡ Записаться

Подписаться: @zadachi_ds


‼️АНАЛИТИКИ, ОБЩИЙ СБОР ⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀

1. Как упаковывать свой опыт, чтобы эйчары не пропустили вас?

2. Как проходить собеседования на 10/10?

3. Как без проблем решать продуктовые и бизнес-кейсы?

Рассказывает Аня ➡️ @jazzlitics

Она бывший хэд аналитики нетмонет с опытом в работы в бигтехах и международке. В канале разбирают практические советы и внутрянку.

Вот, что точно можно почитать:

1. Дизайн и анализ А/Б-теста за 40 минут

2. Вся база по статистике за 40 минут

3. Вебинар “Как быть востребованным в РФ и за рубежом"

4. Лайфхаки по поиску валютной удаленки и повышению зп

5. Разборы кейсов с интервью в WB, Авито, Додо и Aviasales

6. Полный гайд по оконным функциям

7. И разборы задач с технички - vol. 8 | vol. 9 | vol. 10 | vol. 11 | vol. 12

Подписывайтесь и читайте ❤️

➡️ @jazzlitics


Ты поступишь в ШАД

Старт набора на наши ШАДовские курсы: без воды и лишней теории, 3 месяца семинаров, пробников и лекций! За результат отвечаем ⭐️пройдешь курсы, но не поступишь в ШАД - вернем деньги⭐️ Программы и подробности:

⏩Алгоритмы
⏩Анализ данных
⏩Линейная алгебра
⏩Теория вероятностей
⏩Дискретная математика
⏩Математический анализ

Можно взять один курс, или комбо по спеццене! Даже все 6 сразу — программа выстроена так, что ты все успеешь. Не веришь — чекай отзывы наших выпускников!

Курсы для тебя, если ты:
🔵Только задумался о подготовке
🔵Уже готовился, но не уверен в себе
🔵Подзабыл математику, но хочешь в ШАД
🔵Хочешь совмещать подготовку с работой
🔵Готовишься к собесам в BigTech, АА и маги

❗️ После конца курса подготовка продолжается
Мы не закрываем доступ после курса. Записи, ДЗ, пробники и мок-собесы остаются навсегда, а куратор ведет тебя до самого отбора в ШАД 2027 года: помогает с анкетой, мотивацией, проводит консультации. Начни готовиться заранее и иди к цели в комфортном темпе.

Только у нас ты получишь:
🔵Онлайн-семинары, лекции, ДЗ и пробники с проверкой
🔵Разбор отбора 2027, саппорт с анкетой и мотивацией
🔵Доступ к закрытой базе знаний и протоколам ШАД
🔵Пробное тестирование, экзамен и собеседование
🔵Сборник всех задач ШАДа для самоподготовки

Для вопросов и записи пиши менджеру: @menshe_treh ▶️


ML_собеседование_Т_Банк_и_Яндекс.pdf
2.3Mb
Слив вопросов с ML-собесов в Т-Банке и Яндексе

Продолжаем грабить бигтехи, чтобы вы реально почувствовали насколько круты наши курсы. Делимся гайдом, который собрали по горячим следам наших выпускников и студентов курсов МЛ старт и МЛ про— тех, кто эти собесы и проходил, и проводил. 112 вопросов, которые реально задают на секциях ML-инженера (стажёр, джун, мидл) в двух бигтехах. По каждому разбор ответа и уточняющие вопросы, которые интервьюер задаст следом. Ещё больше закрытых материалов на наших курсах. Кстати разбор контеста и закрытые материалы на стажировку в Яндекс, Яндекс Intern Offer уже выложены.
➡ Записаться

Разберёмся по блокам, что спрашивают и на чём заваливают.

Алгоритмы. Яндекс даёт две задачи из ограниченного пула — не надо решать все 3600 задач на литкоде, пул практически полностью совпадает с нашим списком. Т-Банк даёт несколько задач попроще, но на скорость (3 задачи на час, можно пользоваться отладчиком). Типичное: two sum, скобочная последовательность, слияние интервалов, бинарный поиск по ответу, число островов.

Классический ML. Т-Банк прямо перечисляет темы в описании: линрег, логрег, SVM, kNN, RF, бустинг, PCA. Яндекс формулирует мягче, но спрашивает то же самое. Вот где валятся чаще всего: «почему L1 зануляет веса, а L2 нет» (нужно про ромб), «чем CatBoost отличается от XGBoost» (ordered boosting, target encoding без утечки — CatBoost делал Яндекс, знать обязательно), «что такое утечка данных — приведите три примера». Без хотя бы базового понимания будет тяжеловато здесь, советую побольше времени заложить здесь на подготовку.

Метрики. Яндекс проверяет отдельным блоком. Классика: «почему accuracy — плохая метрика», «чем log loss отличается от AUC» (AUC — про порядок, log loss — ещё и про калибровку), «как выбрать порог классификации при дисбалансе 1% фрода». Если идёте в поиск или рекомендации — спросят NDCG и MRR.

Deep Learning. На секции ML+Algo в Яндексе дают выбрать тему для углубления: логрег, деревья или нейросети. Берите нейросети — там всё предсказуемо: backprop, dropout, BatchNorm, Adam, подсчёт параметров свёрточного слоя. На логреге завалят выводом формул через MLE, на бустингах — внутренним устройством. Если идёте в CV — будьте готовы объяснить, зачем skip-connections в ResNet и чем one-stage детекция отличается от two-stage. В NLP — self-attention, BERT vs GPT, как устроен RAG и где он ломается.

Еще больше материалов в наших открытых банках собесов.
— Аналитика
— ML & DS
— Бэкенд
— Фронтенд
— Алгоритмы
Обсудить задачи можно в нашей боталке.

Подписаться: @postypashki_old


Полный цикл собесов в Яндекс (МЛ 2026)

Сейчас студенты наших курсов под чутким сопровождением проходят отборы в Яндекс, поэтому продолжаю радовать вас инсайдами и актуальными вопросами. Далее представлен слегка отредактированный текст нашего студента.

Я, как и все мои сокурсники по МИРЭА, пробовал пройти на стажировку в Яндекс. Получилось с третьей попытки, расскажу обо всём по порядку.

Вступительный контест
Задания взял отсюда, просто прорешал заранее и сдал, но зашли только 3 задачи. Кстати разбор стажировки Яндекс и Яндекс Intern Week Offer по МЛ уже выложен на наших курсах МЛ ПРО, ИИ агенты ПРО.
➡️ Записаться

Секция ML & Programming
Так теперь называется МЛ секция. У Яндекса есть видео, как она проходит, у меня было очень похоже. Сначала задача на код: найти в массиве два числа с заданной суммой. Я быстро написал решение через словарь и думал, что на этом всё, но потом ещё минут пятнадцать разбирали частные случаи: пустой массив, одинаковые числа, можно ли взять один элемент дважды. Потом попросили самому придумать тесты. Дальше теория: как обучается градиентный бустинг, чем он отличается от случайного леса, что будет, если деревьев сделать намного больше. И метрики: что показывает ROC-AUC и на что смотреть, когда положительных примеров один на тысячу. На PR-AUC я запутался, но с подсказкой ответил.

Алгоритмическая секция
Две задачи в онлайн-редакторе. Код не запускается, проверяешь его глазами, и обязательно спрашивают сложность. Первая задача: в массиве положительных чисел найти самый короткий подотрезок, сумма которого не меньше заданной. Сначала написал перебор за квадрат, потом с подсказкой переделал на два указателя. Вторая про бинарное дерево: вывести вершины, которые видно, если смотреть на дерево справа. Обе известные, средний уровень с LeetCode. В конце немного поспрашивали про Питон и базы данных, с которыми я работал.

Дальше были собеседования с командами, у меня три.

Собес 1 (Яндекс Лавка)
Самый спокойный из трёх. Спрашивали про опыт и пет-проекты. Я рассказал про кредитный скоринг и рекомендации фильмов, которые взял готовыми и переделал под себя. Ребята рассказали, что часть работы со спросом и остатками у них уже делают агенты на LLM, а стажёру предстоит собирать примеры, где агент ошибся, и проверять, что после правок он не стал хуже. Спросили, как бы я оценивал такого агента. Я предложил, чтобы ответы проверяла другая модель. Спросили про минусы, и я не знал, что такая модель обычно завышает оценки длинным ответам.

Собес 2 (Яндекс Маркет)
Тут было сложнее. Дали кейс: человек первый раз открыл Маркет, истории покупок нет, что ему показывать. Обсудили холодный старт и многоруких бандитов, про это хорошо написано здесь. Потом говорили, как понять, что подборка хорошая, и почему одних кликов мало. Попросили своими словами объяснить NDCG. Дальше были A/B тесты: ошибки первого и второго рода, мощность, сколько дней держать тест. В конце простой SQL запрос: по таблице заказов вывести пользователей, у которых больше трёх заказов за месяц.

Собес 3 (Алиса)
Почти всё время говорили про языковые модели. Как понять, что новая версия модели отвечает лучше старой, если размечать ответы некому. Что будет, если в документ, который читает модель, кто-то спрятал инструкцию для неё (это называется prompt injection). Как посчитать, сколько стоит один ответ модели.

В итоге позвали две команды из трёх, я выбрал Маркет.

Подписаться: @zadachi_ds


❗️ Яндекс открыл Intern Week Offer на стажировку, где всего за неделю ты можешь получить оффер, а не растягивать процесс на месяца.

Залетаем с ноги в Яндекс: регистрация проходит до октября, а задания уже лежат тут.

А чтобы ты точно получил оффер, мы уже сделали разбор контеста и технических этапов, они доступны нашим студентам на наших курсах:

➡️ алгоритмы про ➡️ фронтенд и бэкенд
➡️ бэкенд разработка про➡️ бэкенд
➡️ машинное обучение про ➡️ МЛ
➡️ ИИ-агенты ПРО ➡️ МЛ

Помимо разборов, которые проходят все скрытые тесты на наличие ИИ в решениях, на наших курсах вы получаете:
🔽 Доступ к закрытой базе собесов и тестовых заданий
🔽 Разбор стажировки ДС Авито (на МЛ ПРО и ИИ агенты ПРО)
🔽 Курс по выходу на доход в валюте
🔽 Гарантия оффера
🔽 Рефералка в бигтех после защиты пет-проекта
🔽 mock-собеседования с обратной связью


Успей написать администратору и не откладывай: задания могут скоро поменять!


Почему ты должен попасть на DS-буткемп Авито прямо сейчас

Дедлайн по заявкам до 20 сентября. Поэтому в посте бодро расскажем о буткемпе и работе в DS-направлении Авито. Кстати, разбор теста и остальных этапов выложен на наших курсах МЛ ПРО, ИИ агенты ПРО.
➡️ Записаться

Самый быстрый рост на рынке
Буткемп предлагает возможность вырасти от стажёра до мидла за один год. Здесь важно напомнить, что мидлы в Авито, во-первых, действительно разбирается в своей сфере, а во-вторых, получает 300к+ после вычета.
Думаю, вы понимаете, что выйти на такой уровень зарплаты за год, одновременно получая опыт работы в бигтехе и решая интересные задачи с реальным влиянием на бизнес, очень привлекательно для начинающего специалиста. От такой возможно просто глупо отказываться в начале карьеры.

Рост очень прозрачный и понятный, так как расти вы будете по матрице компетенций, параллельно работая со своим наставником. Благодаря этому вы в любой момент сможете понять, каких знаний и навыков вам не хватает. Сюда же плюсуется обучение во внутренней АА и доступ к записям внешней АА. Всё это поможет быстро прокачать знания до необходимого уровня. Если хорошо потрудиться, к концу буткемпа вполне реально выйти на уровень мидла.

Выделим отдельно несколько моментов, которые стоит знать о буткемпе:
-Очевидно, что к концу буткемпа для вас может не найтись подходящей ставки, даже если вас грейднут на мидла. В таком случае по классической схеме придётся ждать, пока в одной из команд откроется подходящая позиция.
-Во время буткемпа вы считаетесь стажёром, хотя уже через полгода зарплата будет на уровне джуна. Это значит, что вы не являетесь
штатным сотрудником. У вас не будет ДМС, компенсации командировочных расходов и некоторых других плюшек.
- Никаких подводных камней при этом нет, вам будут стабильно платить ЗП и работать с вами как с полноценным сотрудником. Требования к буткемперам разные, но зачастую они все же высокие, поэтому придется поработать.

DS в Авито
Дата-сайентисты, наравне с аналитиками, играют в Авито важную роль, а культура работы с данными здесь, пожалуй, одна из лучших на рынке. ДСер в Авито, по сути, является инженером и владельцем ML-решения полного цикла. Вы будете работать как с аналитиками, так и с проджектами и продактами. Соответственно, у вас будет возможность продвигать свои решения и показывать их влияние на бизнес, благодаря чему можно расти с невероятной скоростью.

С инфрой у Авито всё хорошо, двхшники и разрабы своё дело знают. Также есть собственные ML- и LLM-платформы, которые позволяют сосредоточиться на бизнес-задачах и метриках моделей, а не на тупой рутине.

Обычно работа состоит из четырёх частей: продуктовой постановки, исследования данных и моделей, инженерной реализации, а также проверки эффкта и дальнейшей эксплуатации решения.

По мере роста вы будете получать не просто задачи на реализацию более сложных моделей, а всё более неопределённые задачи. Вам предстоит самостоятельно формулировать подход и метрики, вести проекты, договариваться с соседними командами и отвечать за итоговый продуктовый результат. Поверьте, такой опыт крайне полезен для роста.

Перспективы после буткемпа
Самый частый сценарий после буткемпа выглядит так: ожидание своей мидловой ставки, которое обычно занимает от одного до трёх месяцев, а затем уверенное закрепление в штате.
По статистике буткемперы показывают себя в компании очень хорошо, что, конечно, заставляет задуматься о смысле существования обычного трека, ведь рост от джуна до мидла в Авито может занять до двух лет. Напомним: на буткемпе вы проходите путь от нуля до мидла за один год.

Если не сидится на месте и хочется получить грейд повыше, можно пойти пособеседоваться в другие компании на позиции уровня middle+ или senior. Особенно хорошо это может сработать с one-day-офферами и другими фаст-треками.После буткемпа вы вполне можете позиционировать себя как специалиста, который самостоятельно ведёт проекты и доводит ML-решения до реального бизнес-эффекта. Поэтому собеседования на более высокие грейды в любом случае будут полезны хотя бы для оценки собственного прогресса.

В общем, настоятельно рекомендуем запрыгнуть в этот, возможно, уходящий поезд DS-буткемпа в его нынешнем виде. Это шанс получить один из самых быстрых вариантов роста на рынке и не начинать карьеру с зарплаты в 30 тысяч тугриков.

Подписаться: @postypashki_old


Вопросы с собеса Авито Буткемп ДС

Дедлайн подачи 20 сентября, торопитесь! Разбор же теста уже выложен только на наших курсах МЛ ПРО, ИИ агенты ПРО.
➡️ Записаться

Общие вопросы по опыту

1. Расскажи, чем ты занимаешься? Какие сферы тебе особенно удаются?
2. Можешь подробнее рассказать про задачи, которые ты выполнял?
3. В чат-боте: какая сектора использовалась, какая моделька, и какие этапы обработки запросов?
4. А моделька какая? Почему выбрали вихрь, а не Qwen?
5. Чем вы разворачивали модель? Использовали OEM или что-то другое?
6. У тебя агентная система или просто одна LLM?
7. Как вы учитывали контекст диалога пользователя с LLM?

Архитектура и компоненты RAG-системы
1. Какой эмбеддер вы использовали?
2. Как организован ваш retrieval (BM25, FAISS и т.п.)?
3. Что использовали в качестве реранкера? Дообучали ли вы его?
4. Какие лоссы применялись при обучении эмбеддера и реранкера?
5. Какие метрики вы использовали для оценки качества retrieval и ранжирования?
6. Как замеряли качество генерации LLM?

Оптимизация и ускорение инференса
1. Какая скорость инференса была?
2. Рассчитывали ли вы нагрузку на систему?
3. Какие подходы ты бы использовал для ускорения инференса?
4. Включали ли вы KV cache?
5. Расскажи, как работает квантизация и дистилляция? Чем они отличаются?

Fine-tuning и PEFT
1. Какие методы тюнинга существуют? Чем они отличаются?
2. Что такое LoRA, QLoRA, Prompt Tuning, P-Tuning?
3. Как устроена LoRA и как она встраивается в LLM?
4. Чем отличается QLoRA от обычной LoRA?

Моделирование и системный дизайн (разрешительная документация)
1. Как бы ты решал задачу сопоставления карточки товара и разрешительной документации?
2. Что на выходе должно быть? Что сказать модератору?
3. Что делать, если в разрешительной документации много строк?
4. Как обработать названия и параметры шин?
5. Как бы ты находил маски (форматы) параметров шин?
6. Какой preprocessing ты бы использовал?
7. Как построить pipeline, где маски уже извлечены?
8. Как построить бинарный фильтр для соответствия товарной группы документации?
9. Как бы ты агрегировал финальное решение?

Классическое ML
1. Занимался ли ты классическим ML? Какие задачи решал?
2. Как строится решающее дерево?
3. Какие критерии ветвления и остановки знаешь?
4. Какие методы ансамблирования моделей знаешь?
5. Чем отличается Random Forest от бустинга?
6. Что произойдет, если удалить одно дерево в бустинге и в Random Forest?
7. Что такое теорема Байеса? Как выглядит её формула?

Подписываемся:
@zadachi_ds


Авито МЛ гaйд.pdf
1.5Mb
Полный слив ML-собеса в Avito

Наши выпускники не только сейчас активно проходят собесы, но и уже давно закрепились в штате и проводят собесы. В честь стажировки в Авито (буткемп ДС, дедлайн подачи 20 сентября) сливаем всю техническую секцию. Разбор же тестового задания уже выложен только на наших курсах МЛ ПРО, ИИ агенты ПРО.
➡️ Записаться

Что внутри:

Основы ML (8 задач). Регуляризация, почему на практике не решают линейную регрессию через явную формулу, precision vs recall на реальной задаче модерации объявлений, AUC-ROC вдоль и поперёк, MAE vs MSE на выбросах, модификации градиентного спуска.

Ансамбли (5 задач). Беггинг и почему беггинг над линейными снова даёт линейный, устройство RandomForest, градиентный бустинг и его реализации (oblivious tree в CatBoost, leaf-wise в LightGBM), почему на проде под задержку часто берут GBDT, а не RF, и какие гиперпараметры GBDT крутить в первую очередь.

Computer Vision (3 задачи). Свёртки и пулинг, Inception module и Residual block на пальцах, как выжать скор на Kaggle без переобучения (TTA), и как отвечать на «расскажи последнюю статью, которую читал».

NLP (8 задач). Эмбеддинги от BoW до BERT, отличие encoder и decoder, self-attention и треугольная маска, positional encoding и RoPE, как достать эмбеддинг текста из BERT (CLS, пулинг, SentenceBERT), даст ли BERT разумный эмбеддинг слову «подкрадули» (да, wordpiece), BERT на Question Answering.

Продвинутые темы (2 задачи). Регуляризация нейросетей (batchnorm, dropout и как он работает на инференсе) и открытый кейс про классификацию аккаунта по его окружению — Deep Sets, GAT и почему тут важна инвариантность к порядку.

По каждому вопросу не только правильный ответ, а как его объяснить: закрыть пробелы, сверить формулировки и научиться объяснять идею, а не просто пуляться терминами. Кстати все вопросы закрываются нашим курсом Data Science.

Еще больше материалов в наших открытых банках собесов.
— Аналитика
— ML & DS
— Бэкенд
— Фронтенд
— Алгоритмы
Обсудить задачи можно в нашей боталке.

Подписаться: @zadachi_ds


Стажировка Авито (Data Science Bootcamp)

В посте обсудим основные этапы отбора. Направления: классика, CV, NLP и LLM - при подаче выбирается только одно. Для участия нужно подать заявку до 20 сентября и выполнить тестовое задание. Разбор будет только на наших курсах МЛ ПРО, ИИ агенты ПРО.
➡️ Записаться.

1. Скрининг-тест
Тест по Python, SQL, матеше и ML - около 30 вопросов, из них 2 задачи на код, остальное теория. На каждый вопрос дают около минуты, сворачиваться или переключать вкладки нельзя - если задетектит скрин, об этом напишут и результат не засчитают (но сам тест доходишь до конца). В конце теста ещё пара лёгких задач на код. Пример можно посмотреть тут.

2. Тестовое задание + видеовизитка идут параллельно по дедлайну
Формат тестового зависит от направления:
- построить модель и придумать фичи, чтобы повысить целевую метрику (классика)
- задание в формате хакатона: например, написать ретривал-систему и максимизировать MAP@10 (на NLP было такое)

Видеовизитка - тут типичная запись себя на вебку с ответами на простые вопросы вроде "кто ты", "почему Авито", "почему DS", тоже с лимитом около минуты на ответ. Такое же есть и на стажку от Авито, поэтому ничего нового. Пример можно посмотреть тут, а как готовиться к софт собесам в Авито писали пост.

3. Технический собес
- Иногда ~10 минут обсуждают твоё тестовое, но бывает, что вообще не спрашивают про него.
- Задача на алгоритмы уровня LeetCode (medium). Сливали материалы тут.
- Блок по классическому ML: деревья, ансамбли (бэггинг, бустинг, стекинг), регуляризация, дропаут, метрики, нормализация и т.п.
- Если направление NLP дополнительно спрашивают эмбеддинги, word2vec, трансформеры, TF-IDF и подобное.

4. Финал
В основном это знакомство с командой и рассказ о том, чем предстоит заниматься. Технических вопросов обычно нет, но некоторые слышали, что иногда бывают. В целом классический финал, как например в том же яндексе/авито/тиньке.

При мэтче год стажируешься, заполняешь матрицу компетенций (подтвержение навыков) и в конце буткемпа тебе проводят собесы, по которым принимают решение какой грейд тебе давать - мидл или джуна оставлять. Пример собесов тут.

Подписаться: @postypashki_old


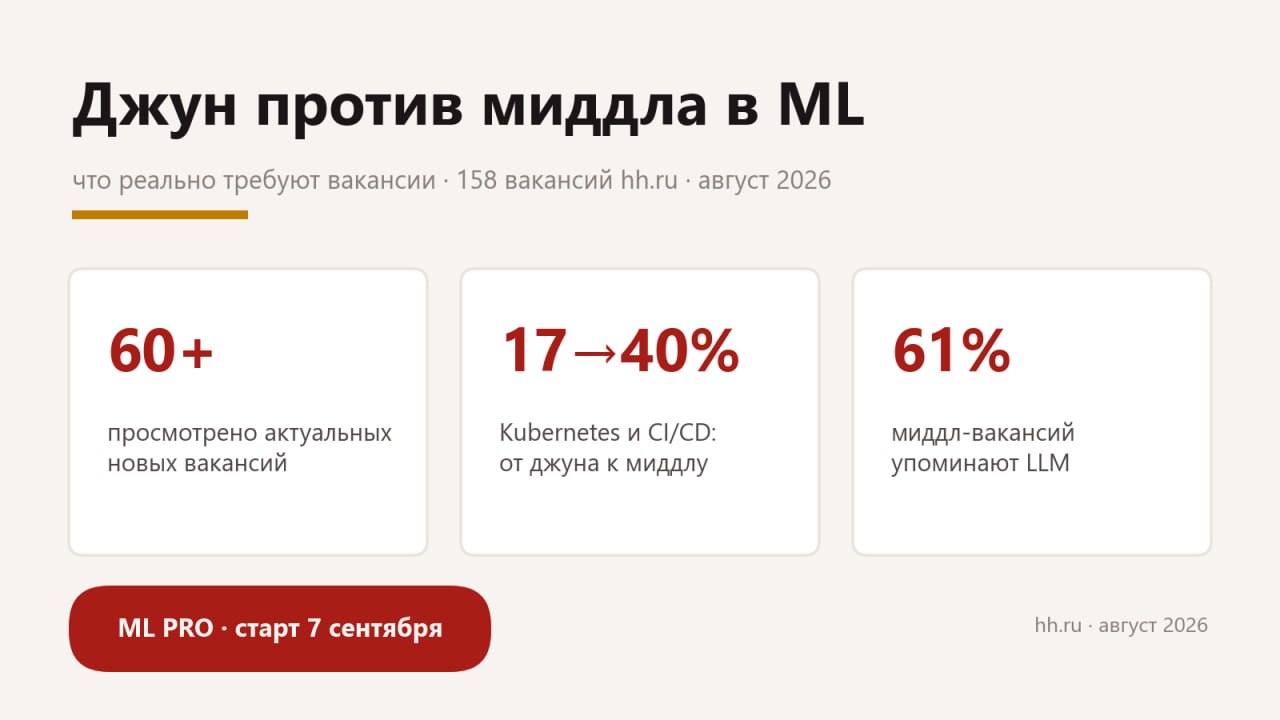
Мы разобрали 160 с лишним вакансий, чтобы понять, чем миддл в ML на самом деле отличается от джуна

Об этом любят рассуждать в комментариях, а вот цифр под рукой обычно ни у кого нет. Мы решили их добыть

Взяли свежие вакансии ML-инженеров на hh.ru: чуть больше 60 джунских и стажёрских и около сотни миддловых, где просят от трёх лет опыта. Для каждого навыка посчитали, в какой доле вакансий он встречается. Все цифры на карточках к посту, здесь только самое интересное.

Начнём с того, что совпадает. Ядро у обоих уровней одно. Python требуют от 88 процентов джунов и 86 процентов миддлов, PyTorch поровну, классический ML у джунов даже чаще. Зато математику у новичков спрашивают почти вдвое активнее: тервер и линал упомянуты в 17 процентах джунских вакансий и только в 10 миддловых. Логика понятная. Пока опыта нет, проверять больше нечего, кроме теории. У стажёра в Яндексе в требованиях алгоритмы и основы ML, про прод ни слова.

А вот дальше списки расходятся, и расходятся по инженерной части. Kubernetes у джунов просят в 17 процентах вакансий, у миддлов в 40. С CI/CD та же картина, 17 и 40. Оптимизация инференса вырастает с 12 до 26 процентов, Kafka с 10 до 21, мониторинг ровно вдвое. Росгосстрах хочет от миддла Docker, Kubernetes, Airflow, MLflow и Grafana одним списком, и СОГАЗ с ним полностью согласен.

Чего мы не ожидали, так это цифр по LLM. Языковые модели, RAG и GenAI упоминаются в 61 проценте миддл-вакансий. Для сравнения, Docker встречается реже. Про «модную приставку к резюме» можно забыть, это уже обычное требование, как когда-то SQL.

Если перевести всё это с языка вакансий на язык рабочего дня, получается примерно так. Джуну обычно достаётся кусок задачи. Почистить данные, собрать фичи, обучить бейзлайн, прогнать десяток экспериментов, принести табличку с метриками, и так по кругу. Пайплайн, куда это встраивается, кто-то уже написал, а что будет с моделью после обучения, решают без него. У миддла задача целиком. Он сам договаривается о постановке с бизнесом, сам заворачивает модель в сервис и вешает мониторинг. Дрейф должен заметить раньше пользователей, переобучить, когда пора, и не уронить при этом прод. Между делом ещё оценивает сроки, ревьюит чужой код и объясняет заказчику, почему метрика выросла, а деньги нет. Вот откуда в его вакансиях Kubernetes с CI/CD: иначе задачу целиком не довезти.

Собеседования устроены под это же. Джуна гоняют по теории: как работает градиентный спуск, чем L1 отличается от L2, почему accuracy врёт на несбалансированных классах, как ловить переобучение. Сверху алгоритмическая секция на Python и довольно часто тестовое на датасете. Пет-проекты смотрят и засчитывают. У миддла теория заканчивается минут через десять, а дальше начинается ML system design. Вот задача, нарисуйте систему от данных до инференса. Где мониторинг, что делаете при дрейфе, как выкатить новую версию без простоя, во сколько это обойдётся. Потом долго ковыряют прошлые проекты: что сломалось в проде, как чинили, что бы сделали иначе. Всё чаще отдельно спрашивают про LLM, как собирали RAG и чем мерили качество. Про три года опыта из требований на собесе вспоминают редко. Вопрос обычно один: сколько раз человек довозил модель до живых пользователей.

Получается, миддла делает не глубокая математика, а привычка доводить модель до прода. Нас это скорее радует: список навыков конечен, и за пару месяцев практики его реально закрыть, если не ходить кругами. Собственно, поэтому наш курс ML PRO устроен так, как устроен: FastAPI и Docker, Kubernetes, CI/CD, MLflow, Airflow, мониторинг с отловом дрейфа и дообучение LLM с выкатом в кластер. В конце блок по карьере: резюме, собесы, поиск вакансий.
➡️ Записаться.

Подписаться: @zadachi_ds


Гайд по МЛ собесам в Яндекс.pdf
378.5Kb
Полный слив собеседований ML в Яндексе

Собрали для вас гайд, по которому в Яндексе сами интервьюеры готовятся вести технические секции на ML‑позиции: от общего MLP до профильных направлений NLP, ASR, CV и RecSys. Внутри разложено буквально всё: что спрашивают, какие задачи дают и по каким критериям ставят грейд. Еще больше материала на наших курсах ПРО. Разбор контеста на стажировку в Яндекс уже выложен!
➡️ Записаться

Как устроена сетка грейдов в файле:
- 14 грейд (hire2) — джун
- 15 грейд (hire3) — мидл
- 16 грейд (hire4) — мидл+
- 17 грейд (hire5) — синьор

Все кандидаты трека ML сначала идут через MLP
Это общая секция на ~60 минут: алгоритмическая задача на код + разговор про теорию ML на примере любимого алгоритма кандидата (логрег, нейронки или ансамбли деревьев). В файле выписано 31 вопрос теории: от того, почему в логрег логарифмируют правдоподобие, до того, как посчитать CTC‑лосс для пустого референса, ну и конечно разбор по каждому критерию: что нужно, чтобы не улететь в no‑hire.

После MLP кандидатов 15 грейда и выше ведут в MLS
Профильную секцию по одному из четырёх направлений:

• NLP: опыт кандидата + задача на пунктуацию/капитализацию + профильная (поиск багов в трансформере или пайплайн суммаризации)
• ASR: теория (архитектуры, лоссы CTC/RNNT, метрики WER/CER) + практическая задача end‑of‑utterance в реальном времени
• CV: практическая задача в реальном времени, самая частая - «типичные грабли»: дают кривую архитектуру и просят найти всё, что в ней не так
• RecSys: дизайн рекомендательной системы с нуля (по образу Ютуба) + профильная задача про кандидатогенерацию или прод‑проблемы

Отдельно стоит обратить на логи интервью с таймкодами, от кандидата, который не смог объяснить, что такое лосс в логреге, до кандидата, которого взяли сразу на 16+ грейд. По этим логам хорошо видно, где именно люди сыпятся и какие уточняющие вопросы задаёт интервьюер, чтобы докопаться до сути.

Если готовитесь именно по ML‑треку, то начните с MLP‑блока, там закрывается процентов 70 типичных вопросов по метрикам, переобучению и статзначимости, а дальше уже углубляйтесь в своё направление.

Подписаться: @postypashki_old


AI-агенты: что это за профессия, сколько платят и как туда попасть

Анализ от нашего преподавателя курса ИИ агенты ПРО (АIOps инженер WB).

1. Почему все вдруг захотели агентов
Всё началось с чатботов, и довольно быстро компании упёрлись в их потолок: бот умеет отвечать на вопросы, и на этом всё. Спросить статус заказа можно, а попросить найти заказ в базе, проверить оплату и оформить возврат уже нет. Агент как раз про второе. Он сам решает, куда посмотреть, какой инструмент дёрнуть, что перепроверить и когда пора остановиться. Если чатбот это справочная, то агент скорее стажёр, которому можно отдать задачу целиком и уйти на обед.

Как только это заработало не только в демках, за агентами пришли все, у кого много рутины. Поддержка хочет, чтобы агент сам лазил в базу заказов. Юристам нужно, чтобы он сверял договор с судебной практикой. В разработке он уже чинит issue и открывает pull request, а в аналитике превращает вопрос на человеческом языке в SQL и график. И нанимают под это давно не только Сбер с Яндексом. Из свежего: строительный стартап, медиахолдинг, исследовательский институт AIRI, Rambler.

2. Сколько платят
Цифры ниже из живых вакансий, а не из опросов. На входе 100–120 тысяч: столько предлагает ELEMENT джуну AI/ML-инженеру, причём опыт с LLM там принимают «хотя бы на уровне пет-проектов». С опытом год-три уже 150–300, это вилка того самого строительного стартапа. Старший разработчик агентов для Алисы стоит 253–508.

Чтобы было с чем сравнить: джун-аналитик данных, по данным hh, начинает с 81–109 тысяч в Москве и с 50–70 в регионах (источник). А зарплаты аналитиков в целом за полгода прибавили 5%, то есть не догнали даже инфляцию (ист). Агентные позиции стартуют примерно с тех же денег, что и московская аналитика, но дальше растут в разы быстрее. И толпы на входе пока нет.

3. Кто может этим заниматься
Порог входа здесь ниже, чем в классический ML. Градиентный бустинг наизусть и полгода матстата не понадобятся. Понадобится уверенный Python, понимание того, как устроены API, и терпение много экспериментировать, потому что с первого раза агент не работает почти никогда.

Поэтому в профессию приходят с разных сторон. Бэкендеры, для которых агент это просто ещё один сервис, только с необычной начинкой. Дата-сайентисты, уставшие двигать метрику в третьем знаке после запятой. Джуны после курсов: на классическом рынке им тесно, а тут пока свободно, дикий запад. Бывает, приходят аналитики, которые начали с промптов, потом втянулись и написали первый tool call. Из математики пригодится ровно одно: посчитать метрики качества так, чтобы не обмануть самого себя.

4. Что учить
Тут важен порядок, и большинство его нарушает. Первые недели стоит провести на чистом Python с LLM API напрямую, без единого фреймворка: собрать цикл ReAct руками, разобраться с tool calling и structured output. Кто сразу начинает с LangChain, потом не может понять, что именно у него сломалось, потому что никогда не видел, как оно устроено без обёрток. Дальше память и RAG: эмбеддинги, векторные базы, chunking. Потом уже фреймворки вроде LangGraph и smolagents, мульти-агентные схемы, MCP. И обязательно evaluation: датасет, LLM-судья, метрики. Это самая недооценённая тема во всей области. Под неё уже открывают отдельные позиции, а умеют её единицы.

Чего учить точно не надо, так это зоопарк из сорока фреймворков. Внутри они устроены одинаково, и кто один раз написал агента руками, разберётся в любом из них за вечер.

5. Что спрашивают на собесах
Вопросы уже устоялись, набор примерно такой. Как агент выбирает инструмент и что будет, если он зациклится на одном вызове. Чем ваш RAG лучше наивного и как вы это померили. Что такое prompt injection и что случится, если инструкцию спрятать в документ, который агент читает. Как сравнить две версии промпта не на глазок. И сколько стоит один прогон вашего агента в рублях.

Обратите внимание: ни одного вопроса в духе «напишите промпт».
Спрашивают про инженерию вокруг модели, и только про неё. Ответ «я собрал чатбота по туториалу» здесь не работает. А вот «вот репозиторий, вот метрики до и после» закрывает половину собеседования.

6. Что делать на работе
Промпты занимают процентов десять времени, а если писать агента с нуля, то и того меньше, один-два процента. Всё остальное выглядит куда прозаичнее. Читаешь трейсы и пытаешься понять, почему на конкретном запросе агент свернул не туда. Собираешь датасеты из реальных провалов. Гоняешь eval-пайплайн после каждого изменения, потому что поправил одно и незаметно сломал три. Режешь стоимость: кэширование, роутинг на дешёвые модели, батчи. Ставишь guardrails и проверяешь, что клиентский агент не сольёт системный промпт первому же шутнику. В общем, обычная инженерия. Просто в центре у неё недетерминированная штука, и от этого она заметно интереснее.

7. Что будет через год-два
Кое-что выглядит почти неизбежным. Обёртки вокруг API перестанут быть отдельной работой: простого агента соберёт кто угодно, а платить будут за надёжность и качество, то есть за evals и observability. Стандарты вроде MCP сделают инструменты взаимозаменяемыми, и выиграют те, кто понимает архитектуру, а не конкретный фреймворк. Ну и требования к джунам продолжат расти: то, что сегодня плюс в резюме, через год станет гигиеническим минимумом.

Сейчас спрос обгоняет предложение, и джуна с одним хорошим агентным проектом забирают быстро. Такие окна на рынке живут года два, потом закрываются.
Если хотите пройти этот путь не в одиночку: советую наш курс по AI-агентам. Шесть недель, от ReAct-агента на чистом Python до eval-пайплайна и деплоя.
➡️ Записаться.

Подписаться: @zadachi_ds


Товарищи, Поступашкам нужны контент мейкеры в основной канал по DS/ML и другим дисциплинам. Если вы творческая личность, интересующейся алгоритмами (или другим), вам нравится писать посты/ придумывать идеи для контента, то обязательно пишите @vice22821. Оплата сдельная, ориентировочно за один пост от 2 тыс до 15 тыс рублей.

Обязательно делитесь с ребятами, которым это может быть интересно.


Стажировка в Яндексе одна из лучших возможностей для старта в МЛ:

• МНОГО СВОБОДНЫХ ЖЕНЩИН
• специалисты высокого класса
• зарплаты в среднем выше рынка
• современный стек и проекты
• хорошо выстроены процессы
• корпоративная культура

Для участия нужно подать анкету заполнить анкету и зарешать контест. Разбор контеста уже выложен на нашем курсе мл про, аи агенты про.
➡ Записаться.

Как заполнять анкеты смотрим этот ролик. После контеста вас ждет один алгособес на 2 литкод задачи medium и один технический собес: алгосы + ML. И наконец собеседования с командами. На моем опыте максимально, сколько может быть собесов с командой - 9.

Финальные собесы
Если команда точно понимает, что им нужен стажёр закрыть пару дыр и после он не нужен, то собес больше про твой опыт, почему Яндекс, как планируешь совмещать с учебой, а что будешь делать, если стажку не продлим/не возьмём в штат. Такие больше на метч с командой и посмотреть не будешь ли ты ныть, что на стажке будешь заниматься скучной фигней, расскажут какой есть пул задач и спросят, что из этого интересно. Обычно такое в продуктовые команды.

Если команде нужен специалист, которого они хотят растить, то собес посерьезней из разряда: МЛ систем дизайн, ML special и тд. Пример нашего выпускника можно посмотреть здесь.

Конкретнее все зависит от того, кто собесит: chill guy или факер. Выбирайте команду с умом, ее можно поменять.

Штат
Можно сразу на финале спросить, а будут ли места в штате. Конечно обмануть могут, но за вопрос денег не берут и пусть сила вам подскажет.

После стажировки есть несколько вариантов:
1. Если плохой отзыв от команды и говорят «уходи», то нужно заново проходить все собесы на стажера
2. Могут сказать, что ты не очень и иди на стажировку снова (без собесов, только финалы)
3. Можешь пойти в штат:
а) ты классный - можешь пойти к нам на миддла (но нужно опять пройти АА, потом финалы), если не пройдешь, то возьмут на джуна
б) ты не дотягиваешь до миддла - ты джун и если команда не готова взять джуна, то нужно идти искать, кто может взять к себе джуна самому
в) можно искать, кто готов взять к себе миддла/джуна и врубать свои навыки социальной инженерии на максимум

При идеальном мэтче, вы в Яндексе - поздравляю!

Подписаться: @zadachi_ds


Стажировка в Т-банк одна из лучших возможностей для старта в МЛ:

• специалисты высокого класса
• зарплаты в среднем выше рынка
• современный стек и проекты
• хорошо выстроены процессы
• корпоративная культура

Для участия нужно подать анкету заполнить анкету до 6 сентября и выполнить экзамен. Разбор программирования уже выложен на нашем курсе мл про, аи агенты.
➡️ Записаться.

Как заполнять анкеты смотрим этот ролик. Вашу анкету оценивают рекрутеры, команды. Если вы им понравитесь, вас пригласят на финальное собеседование.

На собесе может быть все, что угодно на усмотрение интервьюера: могут быть даже математические задачи на логику в духе тюремных загадок. Обязателен лайвкодинг с задачами, которые часто подбирают под ваше направление. Метрики, общая суть линейных моделей, регуляризация, описать общий цикл обучения модели. Примеры собесов в Т-банк можно посмотреть в нашем канале @zadachi_ds по поиску ключевых слов "Т-банк"/"Тинькофф". Технические вопросы сильно зависят от команды. Иногда собеседование может пройти в формате "вайбчека" без технических вопросов, но это скорее исключение. Короче все, что есть в нашей программе курсов мл старт, мл про и дата сайнс.

Обычно финальный собес один на полтора часа. Если прям очень хорошо о себя завили в анкете и хорошо показали на собесе - команда может дать хороший отзыв и тогда вам могут предложить еще одно собеседование, но такое бывает редко. Дополнительный финальный собес можно получить, если податься на донабор, который проходит обычно спустя месяц основного набора.

При идеальном мэтче, вы в Т-банке - поздравляю!

Подписаться: @zadachi_ds


Реальное МЛ собеседование на стажировку в Т-банк

Наш студент сделал расшифровку записи собеса, делимся с вами! Кстати, решение экзамена уже выложено на нашем курсе мл про, ии агенты про и алгоритмы про.
➡️ Записаться.

1. «Расскажи, как устроено дерево решений?»

Дерево решений – это модель, которая не использует градиентный спуск (как нейронки или логистическая регрессия). Вместо этого оно строит разбиения данных по принципу «жадного» перебора. На каждом шаге мы смотрим все признаки, все возможные пороги и выбираем то разбиение, которое даёт максимальный прирост чистоты (Information Gain).

А функции потерь у дерева в классическом понимании нет – это частая ловушка на собесах, когда интервьюер спрашивает: «А какая у дерева функция потерь?» Правильный ответ: «Её нет, мы максимизируем информационный выигрыш».

Критерии остановки: глубина, минимальное число объектов в листе или минимальное улучшение.
Сложность построения (если мы сортируем признаки): O(N·M·log N), где N – объектов, M – признаков. Это спрашивали, так что запомните.

2. «Как работать с категориальными признаками?»

• One‑hot encoding – для каждого уникального значения создаём отдельный столбец (1/0). Подходит, если значений не слишком много (иначе раздуваем данные).
• Target encoding – заменяем категорию на среднее значение целевой переменной для этой категории. Это круто, потому что учитывает влияние на ответ. Именно его по умолчанию использует CatBoost.
• Frequency encoding – заменяем на частоту встречаемости.

Но есть нюанс: некоторые модели умеют работать с категориями напрямую, без всякого кодирования (например, тот же CatBoost или LightGBM с параметром categorical_feature). Так что либо кодируем, либо оставляем как есть, если модель поддерживает.
Если сомневаетесь – проверьте оба варианта на валидации и выберите лучший.

3. «Расскажи про случайный лес: обучение, свойства, важность признаков»
Этот вопрос тянет за собой несколько подвопросов.

Обучение леса:
• Мы строим много деревьев, каждое на бэггинге – берём случайную подвыборку данных с повторением и случайное подмножество признаков. Это снижает дисперсию (переобучение), поэтому деревья в лесу можно делать глубокими – bias и так низкий, а дисперсия усредняется.
• Важность признаков в лесу считается двумя способами:
— по количеству разбиений (сплитов) с участием этого признака,
— по суммарному уменьшению impurity (например, Gini) при сплитах по этому признаку, усреднённому по всем деревьям.

Также есть универсальные методы, которые работают с любой моделью: permutation importance (перемешиваем признак и смотрим, как падает качество), а также библиотеки SHAP и ELI5.

4. «А теперь бустинг – в чём его отличие от леса?»
Здесь нужно чётко разделить.

• Бустинг – это последовательное построение деревьев, где каждое следующее дерево учится на ошибках предыдущего. Он нацелен на снижение смещения (bias), поэтому деревья в бустинге берут неглубокими (обычно глубина 3–6) – иначе они слишком сложные и переобучаются.
• Ключевое отличие от леса: в лесу деревья независимы, их можно удалять без особого ущерба (усреднение сглаживает). В бустинге же порядок критичен – самое важное первое дерево, если его убрать, вся композиция рухнет.

5. «Почему бессмысленно строить бустинг поверх линейных моделей?»

Потому что сумма линейных моделей – снова линейная модель. Если мы последовательно добавляем линейные алгоритмы, общая функция остаётся линейной, и мы не получаем никакого выигрыша в сложности. Только если мы добавляем нелинейные преобразования – но тогда это уже не «чистый» бустинг. Поэтому в качестве базовых алгоритмов для бустинга всегда берут нелинейные модели (деревья).

5. Метрики классификации
Тут был целый блок вопросов. Precision, Recall, F1, ROC‑AUC – стандартный набор.

• Почему F1 – это среднее гармоническое, а не арифметическое?
Потому что если одна из метрик (Precision или Recall) равна нулю, то среднее гармоническое даёт 0 – а это честно, модель никуда не годится. Среднее арифметическое дало бы 0.5, что вводило бы в заблуждение. А среднее геометрическое тоже даёт 0, но оно всегда выше гармонического, поэтому F1 – более пессимистичный и строгий показатель. Нам важна строгость.

ROC‑AUC – это вероятность того, что модель поставит случайный положительный объект выше случайного отрицательного. Простыми словами: качество ранжирования. Если заказчик не в теме, я объясняю так: «Мы смотрим, насколько хорошо модель отделяет единицы от нулей при любом пороге».

Для многоклассовой классификации есть два вида усреднения:
• макро‑усреднение: сначала считаем метрику для каждого класса отдельно, потом берём среднее. Используем, если важен каждый класс (например, редкие болезни).
• микро‑усреднение: считаем общую метрику по всем объектам сразу. Используем, если важен общий результат (например, качество на всех клиентах). При дисбалансе классов эти показатели могут сильно отличаться.

6. Практическая задачка
Интервьюер дал таблицу с предсказаниями, отсортированными по убыванию вероятности, и попросил посчитать ROC‑AUC. Я, честно говоря, поленился считать, но объяснил принцип: нужно для каждого порога построить точки (FPR, TPR) и взять площадь под кривой. По отсортированным данным это легко делается через сумму рангов положительных объектов. Формулу я там не приводил, но суть понял.

7. Ошибка в коде
Показали кусок кода обучения модели и спросили: «Что здесь не так?»
А там забыли zero_grad() перед вызовом step() в PyTorch – градиенты накапливаются, и модель обучается криво. Это частая ошибка джунов. Проверяйте всегда!
Вот такие вопросы были. Как видите, ничего запредельного – но нужно чётко понимать теорию и уметь объяснять на пальцах.

Еще больше вопрос в нашем открытом банке собесов и тестовых заданий: смотрите на сайте.

Подписаться: @zadachi_ds


ИИ-инженеры зарабатывают 300к/наносек!

В вебинаре разобрали, что сегодня ждут от начинающего АI-специалиста: какие темы проверяют на технических интервью, как выглядят реальные кейсы и почему сейчас это самый простой способ вката в МЛ. Смотрим! Смотрим!

https://www.youtube.com/watch?v=0TiWWZwt43Y

И да: в конце записи спрятан промокод на мощную скидку.

20 ta oxirgi post ko‘rsatilgan.