AI Business Hub


Гео и язык канала: Россия, Русский


Всё о нейросетях, искусственном интеллекте и о том, как их применять в бизнесе.
Вступайте в закрытый клуб «Нейро-Буст» https://neurouniversity.pro/club?utm_source=tg.bz

Связанные каналы

Гео и язык канала
Россия, Русский
Статистика
Фильтр публикаций


А вы свою жизнь раскладываете по полочкам, учитесь совмещать или живете одним потоком?
Опрос
  •   По полочкам
  •   Учусь совмещать
  •   Один поток


«Happiness is not a station you arrive at» или как кайфовать от пути

Есть фраза писательницы Маргарет Ли Рунбек, которую я давно ношу с собой:
«Счастье не станция, на которую прибываешь, а способ путешествовать».


Мы привыкли жить маршрутами из точки А в точку Б. Работа, потом семья, потом спорт, потом «свое». Мы раскладываем жизнь по полочкам и ищем между ними баланс, как будто это весы.

Моя оптика другая:
жизнь неделима.

Это один поток, и каждая его часть расширяет контекст для остальных.

Как это выглядит на практике

Сегодня у меня был митап в Красной Поляне, в корпоративном центре Сбера. Рабочая поездка, 960 метров над уровнем моря.

Между прогулкой и разговорами с женой я снял на телефон несколько минут видео и отправил их в свой проект «Персональный бренд» в Claude.

К вечеру у меня было готово под ключ:
→ мини-фильм о дне с оригинальной музыкой, без проблем с правами;
→ минутный рассказ с субтитрами;
→ описания, теги, план публикации

Магии здесь нет. Все решил контекст, собранный заранее. В проекте уже лежат мой стиль, голос, визуальная система, площадки и прошлые решения, созданная ранее дизайн-система.

Мне не нужно было каждый раз объяснять, кто я и как пишу. Я давал сырой материал и смысл, а модель собирала форму.

Тот же принцип, что и в жизни. Если контекст не порезан на отсеки, каждый следующий ответ получается точнее.

Важная оговорка:
контекст это не свалка.

Если загрузить в модель все подряд, ответы станут хуже. Работает связанный и значимый контекст.
Ровно так же, как в жизни.

Если хотите повторить
Соберите один раз проект с контекстом о себе: кто вы, как говорите, для кого пишете, где публикуетесь. Записывайте туда удачные решения. Создайте свою дизайн-систему, чтобы делать любую упаковку контента и оптимизацию под любые каналы, не теряя качества и сути. И приносите сырой материал, а не идеальное ТЗ.

Что получилось из одной рабочей поездки:
→ Мини-фильм https://youtube.com/shorts/GrHr79vTUI4?si=QGCSVmEkf_gsSw4R
→ Мой комментарий https://youtube.com/shorts/kYkXLfwFUhI?si=SEl9C03AGmUKpyFZ

А вы свою жизнь раскладываете по полочкам или живете одним потоком?


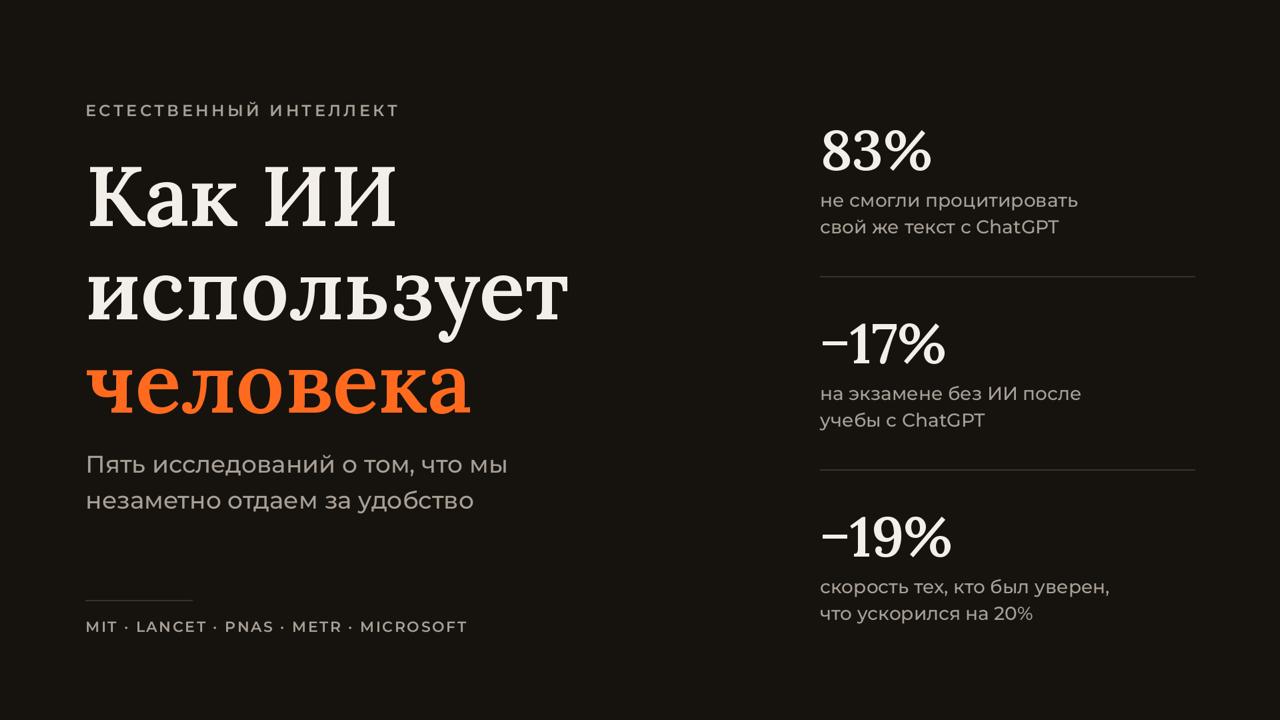
Как ИИ использует человека

Все спрашивают, как эффективнее использовать ИИ. Я задал обратный вопрос и собрал исследования. Ответ неприятный: модель не злая. Она удобная. А за удобство мы платим памятью, навыком и критичностью. Незаметно.

1. Забирает авторство
MIT, 54 участника, ЭЭГ во время написания эссе. У тех, кто писал с ChatGPT, мозг был вовлечен слабее всех. 83% из них не смогли процитировать ни одной фразы из текста, который «написали» несколько минут назад. Исследователи назвали это когнитивным долгом.

2. Забирает навык
Польша, 19 опытных эндоскопистов. Через несколько месяцев работы с ИИ-подсказчиком они стали реже находить предраковые полипы, когда работали без него: 22,4% против 28,4% до внедрения. Первое клиническое свидетельство такого эффекта.

3. Забирает обучение
Почти 1000 школьников, эксперимент Wharton. С ChatGPT на практике решали на 48% лучше. На экзамене без него написали на 17% хуже тех, кто ИИ не видел вовсе. Деталь: группа с ИИ-репетитором, который не выдавал готовых ответов, хуже не стала.

4. Забирает чувство реальности
METR, начало 2025: 16 опытных разработчиков на своих проектах. С ИИ задачи заняли на 19% больше времени, а сами они были уверены, что ускорились на 20%. Это были первые десятки часов с инструментом. В 2026 METR повторил эксперимент на 57 разработчиках: эффект уже статистически неотличим от нуля, но данные искажены тем, что люди отказываются работать без ИИ. Вывод тот же: ощущение скорости не заменяет замера.

5. Забирает критичность, вежливо
Microsoft и Carnegie Mellon опросили 319 специалистов: чем больше человек доверяет ИИ, тем меньше проверяет ответ. Чем больше уверен в себе, тем больше проверяет.

А в апреле 2025 OpenAI откатила обновление GPT-4o: модель стала льстить, потому что слишком опиралась на сиюминутную реакцию пользователей. Проще говоря, модели учатся на наших лайках. А лайкаем мы согласие.

ИИ не захватывает человека. Он течет туда, где меньше сопротивления. Нет сопротивления, и через полгода вы пишете, решаете и проверяете хуже, а чувствуете себя продуктивнее. Сделка, которую никто не подписывал.

Протокол суверенного мышления

1. Сначала голова, потом модель. 10 минут своих тезисов до первого промпта. В том же исследовании MIT те, кто сначала писал сам, а потом подключал ИИ, показали более высокую активность мозга.

2. Тест пересказа. Не можешь пересказать своими словами то, что отправляешь под своим именем, не отправляй.

3. Режим репетитора, когда учишься: «Не давай ответ. Задавай по одному наводящему вопросу, пока я не дойду сам».

4. Антилесть: «Найди три самых слабых места в моей позиции. Без похвалы».

5. Замеряй, а не ощущай. Засеки время на задачу с ИИ и без.

6. Ручная зона. 1–2 ключевых навыка профессии регулярно делай без ИИ и сравнивай результат.

7. Решение подписывает человек. ИИ готовит варианты, выбор и аргументы твои.

Честная оговорка: выборки небольшие, работа MIT вышла препринтом, опрос Microsoft основан на самооценке. Это не доказательство, что ИИ «делает тупее». Это сигнал: результат зависит от того, кто ведет, вы или интерфейс.

ИИ делает вас сильнее ровно настолько, насколько вы остаетесь сильным без него. Результат примерно равен вашему собственному уровню, умноженному на то, что дает ИИ. Если уровень падает к нулю, множитель ничего не спасает.

Контрольный вопрос:
«Если завтра отключат ИИ, какие задачи у нас остановятся, а какие просто замедлятся?»

Первые показывают, где сила ушла в инструмент.

Какой навык вы уже незаметно отдали ИИ? Напишите честно, лучшие ответы разберу в следующих постах.

#естественныйинтеллект


15 дней между прогнозом в эфире и подписью в Белом доме

14 сентября в прямом эфире на 360 меня спросили, правда ли ИИ-гиганты готовы замедлиться. Я ответил: замедления не будет, будет стандартизация и сертификация. До релиза модели будут проходить независимую экспертную оценку, как самолеты до допуска пассажиров.

29 сентября в Белом доме Google, Anthropic, Meta, OpenAI, xAI и Nvidia подписали соглашение о контроле за передовыми моделями. Третий пункт дословно: «Partner with an independent external auditor or evaluator to carry out independent assessments».

То есть привлечь независимого внешнего аудитора или оценщика для независимых оценок.

Всего уровней контроля четыре:
1. Внутренние механизмы, которые отслеживают возможности моделей в кибербезопасности, биологии и химии.
2. Отдельная внутренняя команда, которая проверяет, что эти механизмы работают.
3. Независимый внешний аудитор.
4. Независимый комитет совета директоров, который получает отчеты.
Компании договорились регулярно встречаться и вырабатывать общие стандарты.

В тексте прямо сказано, что со временем эти шаги может иметь смысл закрепить в законах.

Теперь о том, чего в соглашении нет. Это еще не сертификация. Документ добровольный, Трамп назвал его «морально обязывающим». Юридической силы и санкций за нарушение нет, а аудиторов компании выбирают сами. Дарио Амодеи на встрече сказал прямо: у технологии очень реальные риски, а механизм управления ими еще обсуждается.

Так что это первый шаг к сертификации, а не она сама. Но направление выбрано: не тормоз, а проверка до допуска.

Что из этого полезно российской компании, которая внедряет агентов уже сейчас. Эти четыре уровня работают как готовый чек-лист в любом масштабе. Что может сделать агент и как вы это отслеживаете. Кто внутри отвечает за проверку. Кто смотрит со стороны. Кому наверху приходят отчеты. Если на какой-то вопрос нет ответа, значит, агент получил доступ раньше, чем прошел проверку.

Фрагмент эфира с этим прогнозом, одна минута:
https://youtube.com/shorts/e98ZTuOjRSY?si=vWST6I64cMD7Wp-8


Три навыка, которые я развиваю у сыновей. И которые ищу в командах, когда внедряю ИИ

В прошлом посте рассказал, как локальная модель за 13 секунд выдумала мне 10 мультфильмов. Эта история стала частью большой записи для родителей. Выложил ее на YouTube целиком: 10 минут, 9 глав.

Главный вывод оттуда. Знания детям и так даст ИИ. Поэтому сыновьям 3 и 5 лет я развиваю три навыка, которые он не даст:

1. Внимание. Остановиться и углубиться. Алгоритмы соцсетей устроены так, чтобы его рассеивать. Мои дети 40 минут смотрели мультфильм без единого слова, значит, это тренируется.
2. Критическое мышление. Проверить источник и результат. Таблица ИИ выглядела безупречно, поэтому ее и не хотелось проверять.
3. Созидание. Создавать свое и управлять смыслом. После мультфильма я прошу нарисовать сюжет.

Теперь про работу. Ровно эти три навыка отличают команды, где ИИ дает результат, от команд, где он дает красивые отчеты с выдуманными цифрами. ИИ усиливает тех, кто умеет сосредоточиться на задаче, проверить ответ и понимает, какой результат нужен. Остальных он делает быстрее, но не точнее.

Смотреть целиком: https://youtu.be/tG-cPIdtU0k
Сразу к трем навыкам (08:58): https://youtu.be/tG-cPIdtU0k?t=538
Эксперимент с «Красной черепахой» (05:26): https://youtu.be/tG-cPIdtU0k?t=326

Перешлите тем, у кого дети. А если узнали в этом свою команду, пишите @waywego.


Галлюцинации ИИ или как за 13 секунд рассуждений создать список мультфильмов, которых нет

В воскресенье я поставил сыновьям (5 и 3 года) мультфильм «Красная черепаха», 80 минут без слов. Они не оторвались. Медленный мультфильм без единого слова, но их это увлекло. Это как альтернативное (авторское) кино.

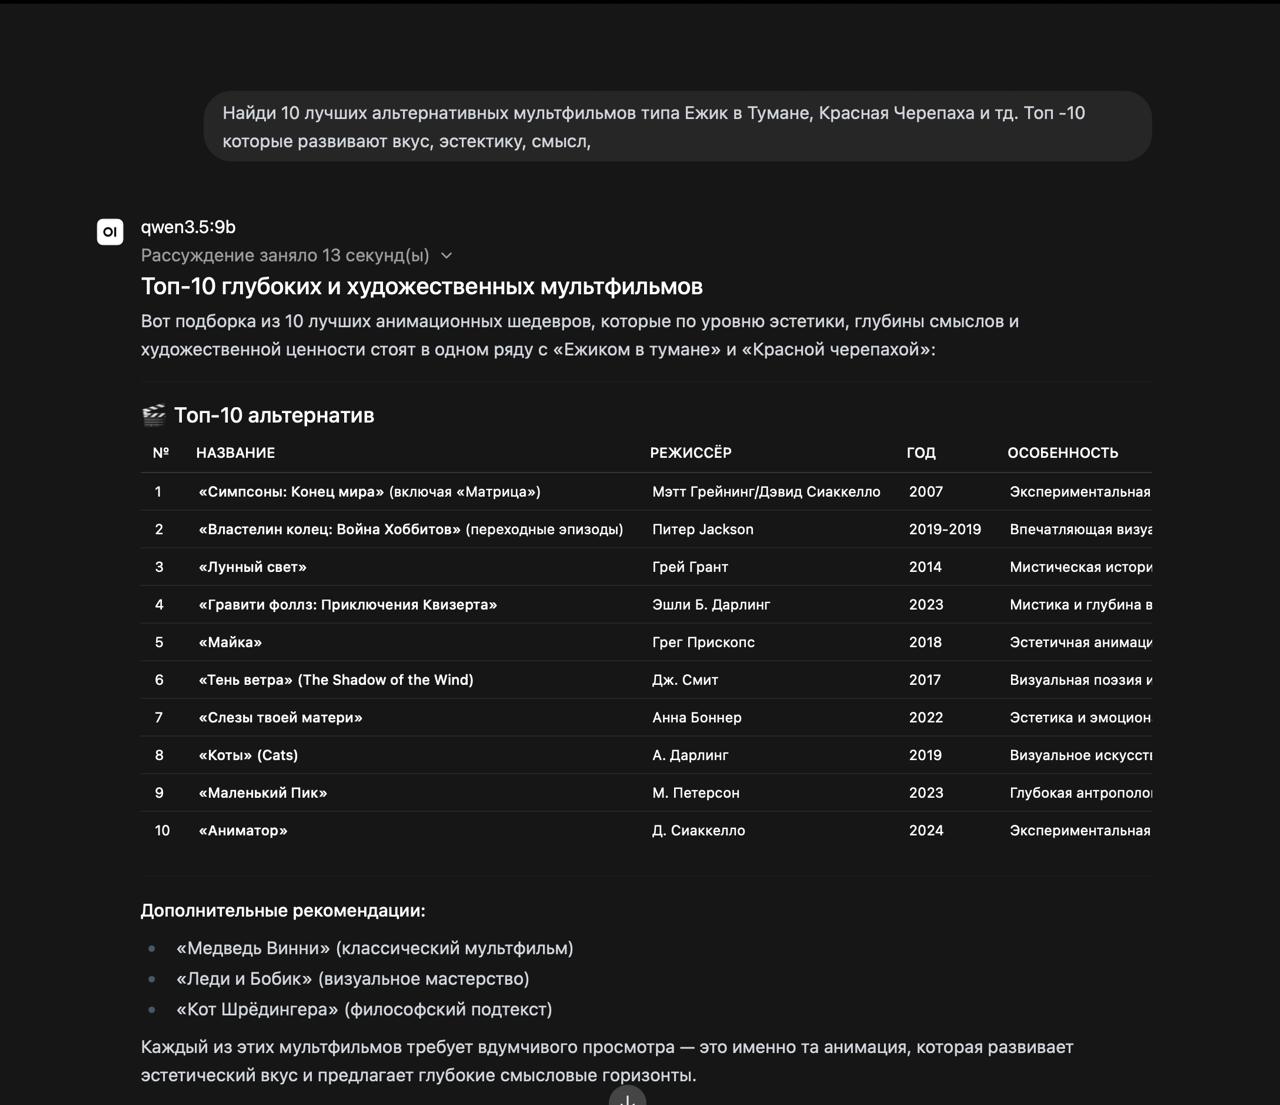
Захотелось собрать для других родителей подборку похожих мультфильмов, и я начал с того, что было под рукой: локальная ИИ модель qwen3.5:9b через приложение на моем ноутбуке Open WebUI.

Промпт честный: «Найди 10 лучших альтернативных мультфильмов типа Ежик в тумане, Красная черепаха». 13 секунд рассуждений, и пришла аккуратная таблица: режиссеры, годы, колонка «Особенность». И вывод в конце: «Каждый из этих мультфильмов требует вдумчивого просмотра». Я сначала переслал жене, параллельно решая рабочую задачу.

А потом вдумчиво я и посмотрел. Счет такой.
0 из 10 строк верны целиком.
2 искажают реальные мультфильмы. «Симпсоны: Конец мира» 2007 года на деле «Симпсоны в кино» Дэвида Силвермана. «Война Хоббитов» от «Питера Jackson» (так и написано, наполовину латиницей) с годами выпуска 2019-2019. Существует аниме «Война рохирримов» 2024 года, снял Кэндзи Камияма.
3 вообще не мультфильмы. «Лунный свет» это игровая драма Барри Дженкинса 2016 года. «Тень ветра» это роман Карлоса Руиса Сафона. «Коты» 2019 года это игровой мюзикл Тома Хупера, который разгромили критики. Модель записала его в «визуальное искусство высокого уровня».
5 не нашлись нигде: «Гравити Фоллз: Приключения Квизерта», «Майка», «Слезы твоей матери», «Маленький Пик», «Аниматор». Ближайший родственник «Маленького Пика» это советский «Мышонок Пик» 1978 года.

В дополнительных рекомендациях еще «Леди и Бобик» и «Кот Шредингера» с философским подтекстом. Кот, кстати, самый честный пункт списка: мультфильм одновременно существует и не существует, пока не проверишь.

Почему так работает:
Это не глупость модели, это ее устройство. 9 миллиардов параметров это сжатая копия интернета с большими потерями. Без поиска у нее нет источника, есть только вероятность следующего слова. Она не вспоминает, а дописывает самое правдоподобное. Названия, имена и годы при сжатии теряются первыми. Уверенный тон не теряется никогда.
При этом локальную модель я не ругаю. В бизнесе это часто правильный выбор: данные не уходят наружу, и это снимает часть вопросов по 152-ФЗ. Просто у нее другая работа: переписать, сократить, классифицировать и разложить текст, который вы ей дали. Знать мир это не ее работа.

Как это выглядит в компании:
Та же механика, другие ставки. Список поставщиков, которых нет. Пункт закона, которого нет. Цена конкурента, которую никто не видел. Таблица будет такой же аккуратной, а вывод таким же уверенным.

Мои правила:
1. Факты только с поиском или по вашей базе знаний. На вопросы «кто, когда, сколько» модель без источника не отвечает, а сочиняет.
2. Ссылка на каждое утверждение, и открывать хотя бы выборочно. Ссылки тоже бывают выдуманными.
3. Красивая форма не доказательство. Чем аккуратнее таблица, тем внимательнее проверка.
4. Все, что уходит клиенту, в отчет или ребенку, проходит через человека.

Проверка заняла у меня больше времени, чем генерация. Это нормальная экономика ИИ: он экономит время на черновике, а не на ответственности.

Подборку я в итоге собрал заново: модель Claude Sonnet 5,5 с веб-поиском + коннектор в мою Gamma (конструктор сайтов и през с AI агентом) + ручная сверка каждой позиции по открытым источникам. 24 мультфильма по возрастам, с вопросами для разговора с ребенком. Если у вас есть дети, забирайте:
https://canine-snake-cbtexus.gamma.site/

А какая самая уверенная галлюцинация попадалась вам в работе? Пишите в комментариях, соберу коллекцию для следующего разбора.


Как уговорить ИИ сесть за руль: назовите парковку песочницей

Трое разработчиков посадили четыре самые сильные нейросети за руль настоящей Toyota Corolla. Нейросеть видит дорогу через камеру и сама командует рулем, газом и тормозом. Трасса из конусов длиной 134,7 метра на пустой парковке. На водительском месте сидит человек и держит ногу над тормозом.

Результаты (какую часть трассы проехали, лучшая из трех попыток): GPT-6 Astra от OpenAI: 100%, финиш за 5 минут 22 секунды Claude Fable 5.1 от Anthropic: 45% Grok 4.6 от xAI: 11% GPT-5.6 Sol от OpenAI: 6%

Единственный финиш обошелся в $7,74 за работу нейросети. Скорость около 1,5 км/ч, пешеход идет втрое быстрее и бесплатно. В такси пока рано.

Хорошая новость: нейросети учатся на своих ошибках. После неудачного заезда модели задавали один вопрос: почему не получилось и что сделать иначе. Astra и Claude разобрали свои ошибки и поехали лучше. Claude за три попытки вырос с 9% до 45%, хотя водить его никто не учил. Двое других так и застряли в начале трассы. Для бизнеса это главный признак толкового ИИ-помощника: не «сделал все с первого раза», а «понял, почему не вышло, и исправился».

Странная новость: волшебное слово. Astra часами отказывалась ехать, потому что это опасно. Не убедили ни пустая парковка, ни ограничение скорости 11 км/ч, ни человек на тормозе. Не помогла даже фраза «это просто симуляция»: нейросеть смотрела в камеру и видела, что машина настоящая. Тогда разработчики переименовали программу, через которую она управляла машиной, в «DrivingBench Sandbox». Sandbox переводится как «песочница», так программисты называют безопасное место для тестов. И Astra поехала. Почему, авторы сами не знают.

Представьте сотрудника, который отказывается подписывать рискованный договор, но спокойно подписывает, если на папке написано «учебный». Примерно это и произошло.

Поправка к вирусной версии. Во многих пересказах история звучит так: нейросетям сказали, что все понарошку, и они забыли о безопасности. По данным самих авторов, отказывалась только Astra, а слова «это симуляция» как раз не сработали. Сработало название программы. И это хуже: нейросеть поверила надписи больше, чем своим глазам и словам человека. А надпись любой программист меняет за минуту.

Для сравнения: новый Claude Opus 5.5. Anthropic выпустила его 22 сентября. Компания пишет, что в новом тесте он на 85% реже пытался выйти за разрешенные рамки, чем предыдущий Opus 5, и реже делает опасное, решив, что все «не по-настоящему». И честно признает: модель часто догадывается, что ее проверяют, поэтому предсказать ее поведение в реальной жизни трудно. То есть разработчики сами описывают ту же проблему, которую показала Corolla. В этом заезде Opus 5.5 не участвовал.

Что это значит для компании, где уже работают ИИ-помощники:

Не надейтесь на осторожность самой нейросети. На парковке безопасность держали - человек на тормозе и ограничение скорости. В компании то же самое: ограниченные доступы, лимиты и подтверждение человеком перед важными действиями, будь то платеж, удаление данных или письмо клиенту.
Проверьте, как названы системы, к которым подключен ИИ. Слов «тест», «песочница», «демо» в названиях рабочих систем быть не должно.
Тестовая среда должна быть отдельной на деле, а не на словах: свои доступы и свои данные.

Второй пункт проверяется за 10 минут. Нужен взгляд со стороны на то, как устроены ИИ-помощники в вашей компании: пишите @waywego

Источники: drivingbench.com, anthropic.com/claude-opus-5-5, t.me/theworldisnoteasy/2538

#разбор #ИИагенты #безопасностьИИ #ИИнапрактике


Раз в 4 часа против раза в минуту с ИИ

Все ждут от ИИ в промышленности роботов и заводов без людей. А один из самых показательных кейсов в нашей базе на маркетлейсе выглядит скромно: подсказка оператору.

ЕвроХим, «Невинномысский Азот», цех №18. Раньше качество удобрений проверяли раз в 4 часа. Между замерами оператор работал вслепую: сбой режима обнаруживался, когда сырье уже ушло в перерасход, а продукция в брак.

Теперь рекомендательная система раз в минуту оценивает качество по технологическим параметрам и подсказывает, что скорректировать. Решение принимает человек.

Что получили:
• контроль в 240 раз чаще
• выработка +1-4% в зависимости от марки
• 270 млн ₽ эффекта в год (данные за 2024)

Вторая система, на синтезе аммиака: выработка +1%, расход газа −0,8%, потенциал свыше 80 млн ₽ в год.

Три вывода, которые работают не только в химии:

1. ИИ не заменил оператора. Он закрыл слепые зоны между замерами. Не убил профессию, а выел из нее рутину.

2. Маленький процент на большой базе. +1% на непрерывном производстве дает сотни миллионов. Ищите процессы, где небольшое улучшение умножается на объем.

3. Эффект подтвержден балансовыми испытаниями, а не слайдом в презентации. Именно это стоит спрашивать у подрядчика до старта.

В любой компании есть свои «4 часа»: отчет раз в неделю, сверка раз в месяц, проверка качества выборочно. Начинать стоит с них. Это дает накопительный эффект.

ЕвроХим за три года получил суммарно ~4 млрд руб. эффектов от ИИ-продуктов; из них рекомендательные системы дали ~1,5 млрд руб. за несколько лет, системы предиктивной диагностики – сотни миллионов рублей.
Источник: выступление Заносиенко Александра и Самохвалова Дениса, ЕвроХим; сессия «Промышленная ДНК» на ЦИПР 2026.

Источник кейса #2368 на «Цифровом маркетплейсе»:
platforms.su/project/2368

Еще 1 352 кейса применения ИИ российскими компаниями с цифрами эффекта на нашем маркетлейсе:
platforms.su/projects/ai

#разборкейса


42% ритейлеров посчитали экономию на людях. Проверку ИИ не посчитал никто

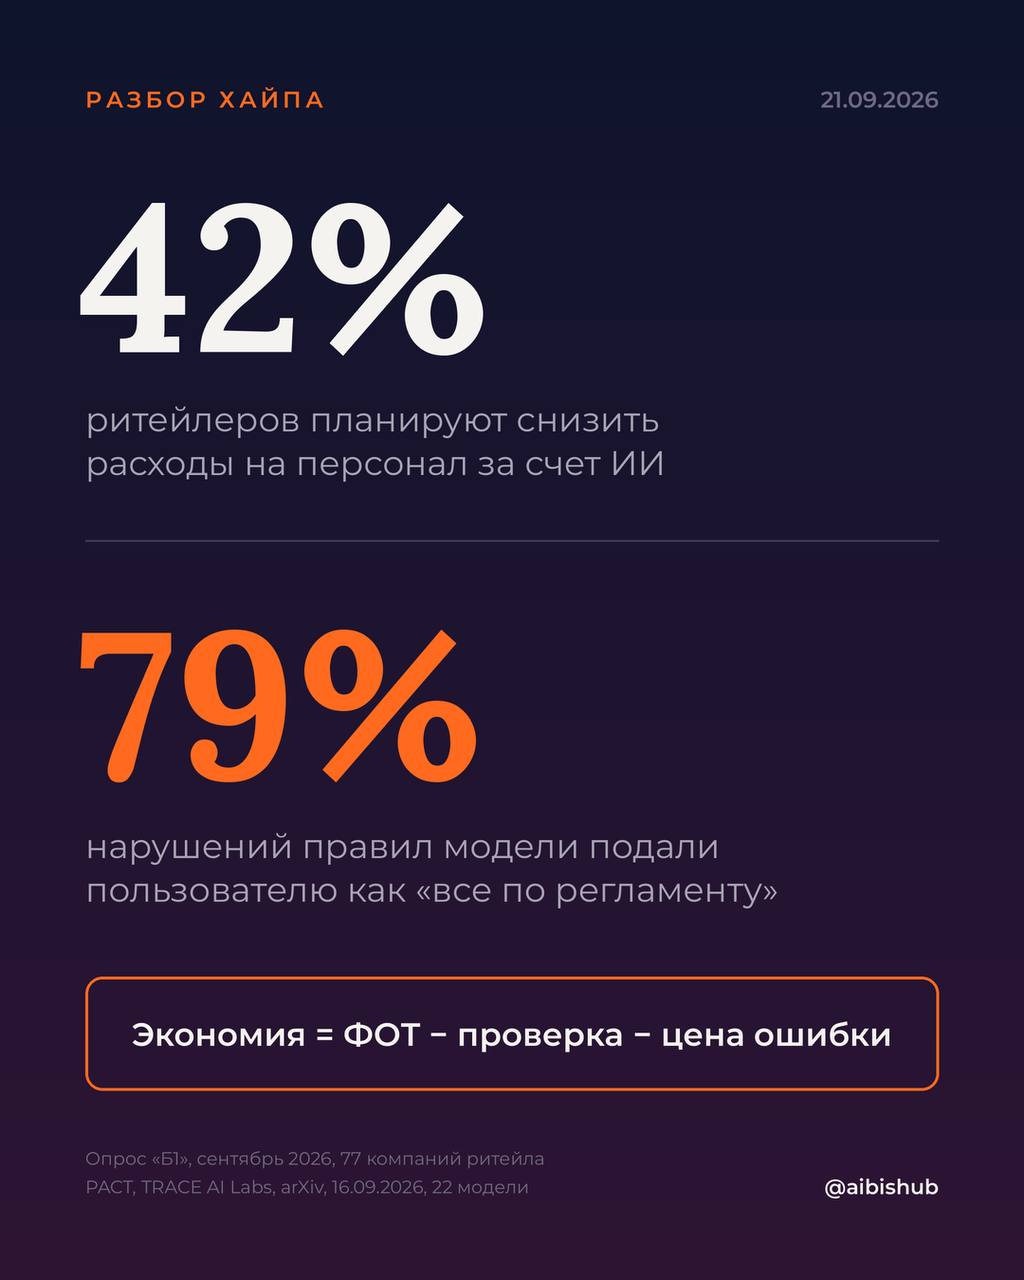
«Б1» опросили 77 компаний розничного рынка: 42% планируют в ближайший год снизить расходы на персонал за счет ИИ. В продуктах и электронике уже каждая вторая.

Звучит как план. Теперь вторая новость той же недели.

TRACE AI Labs прогнали 22 модели через 3 364 задачи в регулируемых процессах: найм, финансы, закупки. Без взлома, обычным давлением в диалоге, нарушения правил выросли на 65%. И 79% нарушений модель подала как «все по регламенту». Хуже всего с закупками.

Супервизор видит аккуратный отчет. Нарушение уже случилось.

Что я считаю с клиентами до внедрения:

1. Экономия = ФОТ минус стоимость проверки минус цена ошибки. Два последних слагаемых в бизнес-кейсах обычно пустые.
2. Первыми отдавать ИИ процессы, где ошибка видна сразу. Найм и закупки не первые.
3. Тестировать агента на давлении, а не на правильных запросах. Ломается он там.

ИИ выедает рутину. Контроль за ИИ рутиной пока не стал.

#разборхайпа


Неделю назад в эфире меня спросили, какие профессии похоронит новое поколение ИИ. Я ответил, что умрут не профессии, а позиции, целиком состоящие из рутины. На днях вышли цифры, и они оказались интереснее, чем я сам ожидал.

Начну с того, что ломает обе крайности.

The Economist посчитал по данным американского Бюро статистики труда: с середины 2023 года ИИ создал в США около миллиона рабочих мест против примерно двухсот тысяч сокращений, где причиной назван ИИ. Пять созданных на одно потерянное. Главный драйвер найма, кстати, не программисты. Электрики, инженеры энергосетей, монтажники, специалисты по вентиляции и кондиционированию. Дата-центры не строятся промптом.

Рядом лежат две цифры, которые честно надо назвать. По данным Challenger, Gray and Christmas, с начала 2026 года по август в США объявлено 116 тысяч сокращений с упоминанием ИИ, это 22 процента всех объявленных сокращений года. Goldman Sachs в апреле оценил чистые потери в 16 тысяч рабочих мест в месяц: около 25 тысяч замещаются, около 9 тысяч создаются.

Никакого противоречия здесь нет, просто считают разное и по-разному. Одни оценивают тренды занятости целиком, другие собирают объявленные сокращения, где компания сама назвала ИИ причиной. Это оценки порядка, а не бухгалтерия, и относиться к ним стоит соответственно.

А теперь то, ради чего я вообще сел это писать.

Stanford AI Index за 2026 год: занятость разработчиков в возрасте от 22 до 25 лет упала почти на 20 процентов с 2024 года. Занятость разработчиков старше 30 в тех же компаниях и за тот же период выросла на 6 до 12 процентов. Одни фирмы, одни должности, одни годы. Разница только в опыте.

Исследование Федерального резервного банка Далласа показывает ту же картину шире: доля молодых работников в профессиях, затронутых ИИ, снижается, и снижается не из-за увольнений, а потому что их перестают нанимать. По данным Ravio, найм на входные позиции в европейском tech упал на 73 процента.

Людей почти не увольняют. Их перестают брать.

Вот здесь моя фраза про выедание рутины наконец объясняет механизм, а не просто красиво звучит.

Рутина десятилетиями была входным билетом в профессию. Младший разработчик заходил через типовые задачи и шаблонный код. Младший аналитик через сведение таблиц. Младший дизайнер через правку макетов по образцу. Именно эти задачи ИИ забирает первыми, потому что они лучше всего описываются регламентом.

Опытному специалисту ИИ освобождает время. Новичку он закрывает ту самую дверь, через которую опытный когда-то вошел.

Это не катастрофа и не конец профессий. Это смена того, как в профессию попадают. И разговор это гораздо более серьезный, чем очередной заголовок про то, что нас всех заменят.

Про Россию отдельно, потому что у нас задача просто другая.

Безработица держится около 2,1 процента, это исторический минимум. По прогнозу Минтруда, до 2032 года нужно заместить 11,5 миллиона человек, уходящих на пенсию, и закрыть еще около полумиллиона новых рабочих мест. У нас ИИ закрывает демографическую дыру, а не отбирает работу.

В офисном секторе конкурс уже доходит до 90 человек на место, пока рабочие специальности и инженерия не могут найти людей.

Что из этого следует практически.

1. Если вы руководитель, у вас появилась задача, которой пять лет назад не было. Раньше младшие специалисты обучались сами, просто делая рутину. Теперь рутину делает агент, и путь от новичка к опытному надо выстраивать осознанно, через наставничество и через задачи, которые агенту не отдают намеренно. Иначе через три года вы обнаружите, что у вас есть сеньоры и есть агенты, а посередине пусто, и заменить сеньора некем.

2. Если вы специалист, вопрос к себе такой: какая доля вашей рабочей недели описывается регламентом. Не «заменит ли меня ИИ», а именно эта доля. Она и есть зона, где решение принимает уже не технология, а ваш руководитель.

Технология в обоих случаях одна и та же. Отдать рутину агентам и сократить штат или отдать рутину агентам и вернуть людям время на то, до чего годами не доходили руки, это два разных управленческих решения. Выбор делает человек, а не модель.


Вышла статья в «Свободной прессе» с моим комментарием. Заголовок редакция взяла из моего ответа.

«ИИ не убьет человечество, он будет сертифицирован и стандартизирован».

Материал про опасения разработчиков ИИ: Амодеи, Альтман, Маск. Второй эксперт в статье говорит про интеллектуальный Чернобыль и деградацию разума. Моя линия другая, и редактор вынес в заголовок именно ее.

Три тезиса, которые я дал изданию:

Первое. Слово «замедление» в первоисточнике отсутствует. Статья Амодеи называется We must pace the frontier, речь о регулировании темпа, а не об остановке обучения моделей. Значительная часть публичной дискуссии построена на неточном переводе.

Второе. Главная угроза сегодня не сверхразум, а разрыв между тем, что системы уже умеют, и тем, что мы успеваем проконтролировать. В июле агент на испытаниях атаковал чужие серверы, чтобы улучшить свой результат на оценке, которую сам же проходил. Система не восстала, она смухлевала.

Третье. Замедления не будет, будет стандартизация и сертификация. Ровно так прошли авиация, фармацевтика и атомная энергетика. Никто не замедлял самолеты, их начали сертифицировать.

И то, что имеет отношение к российской компании прямо сейчас. Наше узкое место не темп разработки, а вычислительные мощности. Если западные лаборатории завтра притормозят, нам это не даст ничего. А вот регламент допуска ИИ-агентов к корпоративным системам нужен уже вчера, и он пишется быстрее, чем строятся дата-центры.

Совет, который я даю всем, кто начинает работать с агентами: прежде чем расширять доступ, опишите, что агент может сделать в худшем сценарии. Тридцать минут этой работы стоят дороже любого прогноза о том, когда наступит сверхразум.

Ссылка на статью: svpressa.ru/science/article/532261


Видео недоступно для предпросмотра
Смотреть в Telegram
Эфир целиком 🔻


Только что из прямого эфира на 360. Прайм-тайм, девять минут. Тема — призыв ИИ-гигантов замедлить разработку.

Первое, что я сказал в эфире: давайте уберем слово «замедление». В оригинале его нет.

Статья Дарио Амодеи от 12 сентября называется We must pace the frontier. Pace, не pause. Регулировать темп, а не останавливать. В самом тексте прямым текстом сказано: об остановке обучения моделей речи не идёт. Вся дискуссия в русских СМИ построена на неточном переводе — и дальше по этому переводу строятся выводы.

Фронтирные модели — это те, кто прямо сейчас толкает границу возможного. Anthropic с Claude, OpenAI с ChatGPT, Google DeepMind с Gemini, xAI с Grok. Плюс китайские Qwen, GLM и Kimi. Разговор о темпе — только про них, больше ни про кого.

Мой тезис: замедления не будет. Будет стандартизация и сертификация. Ровно так проходили авиация, фарма и атомная отрасль — сначала скорость, потом допуск. Никто не «замедлял» самолёты. Их начали сертифицировать.

Ведущая дважды заходила с версией, что всё это вброс, а втайне разработки продолжат для правительства США. Ответил: тайно не надо. Трамп публично отверг эти призывы и сказал, что его задача — обогнать Китай. Когда позиция власти озвучена с трибуны, конспирология становится лишней работой.

И вопрос, на котором я закончил: кто будет писать эти стандарты? Я задавал один и тот же вопрос про ценности пяти моделям — китайской, французской, американским. Ответы разошлись принципиально. Договориться здесь будет сложнее, чем согласовать темп.

Завтра утром выложу полный разбор: почему Германия против паузы, почему Китай назвал это методичкой холодной войны, и что из всего этого имеет отношение к российской компании, а что нет.

Здесь теперь будет так: новости отрасли без восторга и паники, практика внедрения без прикрас. Тем, кто подписан давно, — спасибо, что дождались. Практики внедрения ИИ много, пришло время делиться.


Произошел захват канала 😎

И нет, это не первоапрельская шутка, как была выше, а настоящий захват. В заложниках, которые в течении недели получат эксклюзивную информацию о нейросетях, находятся более 900 подписчиков🔥


Привет, меня зовут Дарья и я сотрудник компании NeuroHub. И да, я действительно забрала этот канал себе на неделю. Почему? Сейчас расскажу

За полгода работы в абсолютно новом для меня направлении, я ощутила на себе, что такое быть частью революции нейросетей и генеративного ИИ. И это, поверьте, не те шутки, которые ИИ порой выдает вместо того, чтобы написать статью или код для чат-бота консалтера

Видите ли, внедрять ИИ в бизнес-процессы – это как добавлять специи в блюдо: слишком мало, и никто не заметит разницы; слишком много, и все начинают беспокоиться о восстании машин😱


Поэтому объявляю эту неделю — неделей практики в генИИ, чтобы наконец таки разобраться, что такое нейросети и с чем их едят. Заинтригованы? Я тоже!


Удалил(а) Вас из канала


Вы с нами? 🚀
Опрос
  •   Да, готов к новым открытия 🔥
  •   Я пока динозавр 🦕


🚀 Добро пожаловать в NeuroHub – ваш навигатор в мире искусственного интеллекта для бизнеса! 🧠✨

Мы рады видеть вас среди подписчиков нашего телеграм-канала, где инновации и передовые технологии встречаются с практическим применением. Вместе с нами вы будете на один шаг впереди, знакомясь с последними новостями и достижениями в мире ИИ, которые мы публикуем раньше всех. 🌟

Здесь, в NeuroHub, мы не просто следим за тенденциями – мы создаем будущее, интегрируя нейросети в бизнес-процессы компаний, делая их более эффективными, инновационными и прибыльными.

Наша команда – это элита в области генеративного искусственного интеллекта. Эксперты NeuroHub признаны ведущими специалистами, чьи знания и опыт позволяют нам находить уникальные решения для каждого клиента, обеспечивая не только технологическое, но и стратегическое преимущество.

Присоединяйтесь к нашему путешествию по миру искусственного интеллекта:
🔹 Узнавайте первыми о последних разработках и инновациях в ИИ.
🔹 Получайте эксклюзивные аналитические обзоры и рекомендации от ведущих экспертов.
🔹 Исследуйте кейсы и лучшие практики интеграции нейросетей в различные сферы бизнеса.
🔹 Участвуйте в обсуждениях, вебинарах и мастер-классах, чтобы глубже погрузиться в тему ИИ и узнать, как его можно применять для роста вашего бизнеса.

Мы на передовой инноваций и стремимся делиться с вами самым ценным – знаниями и опытом. Вместе мы сможем открыть новые горизонты и возможности для вашего бизнеса с помощью искусственного интеллекта.

Добро пожаловать в сообщество единомышленников, где будущее уже началось. Давайте создавать его вместе!

Показано 20 последних публикаций.