Рекомендательная [RecSys Channel]


Channel's geo and language: Russia, Russian
Category: Technologies


Канал про рекомендательные системы от ml-специалистов Яндекса. Делимся опытом, обсуждаем новые подходы и интересные статьи.
Вопросы и предложения > @yandex_ml_brand

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


OneRanker: Unified Generation and Ranking with One Model in Industrial Advertising Recommendation [1/3]

Сегодня приступаем к разбору статьи о том, как объединить генерацию кандидатов и ранжирование в одной модели. Начнём с проблематики и первого шага фреймворка OneRanker.

У современных рекомендательных подходов есть несколько минусов:

• Конфликт интереса пользователя и ценности для бизнеса. Генерация кандидатов опирается на клики и конверсии в истории пользователя, но системе важно учитывать и ценность объектов для бизнеса (например, для рекламы это eCPM). Если напрямую обучать генератор на обеих целях, они тянут общее представление в разные стороны: ухудшается и охват интересов, и отбор ценных объектов. Если же учитывать ценность только при ранжировании, лучшие по этому критерию кандидаты могут отсеяться раньше, чем начнётся ранжирование.

• Нечувствительность к кандидату (target-agnostic). При генерации представление пользователя одинаково для разных кандидатов. Поэтому модель не может выделить в истории именно те события, которые важны для оценки конкретного объекта.

• Разрыв между этапами. Отдельные генератор и ранжировщик могут повторно обрабатывать одну историю и учить разные представления.

Чтобы решить эти проблемы, авторы предлагают интегрировать генерацию в ранжирование на архитектурном уровне. Так появился фреймворк OneRanker. Он состоит из трёх шагов.

Шаг 1. Основа генерации

OneRanker опирается на предыдущую работу Tencent — GPR. История пользователя представлена последовательностью разнородных токенов: пользователя (U), контента (C), контекста (X) и объектов (I). Декодер на основе HSTU обрабатывает эту последовательность, а авторегрессионный механизм multi-token prediction (MTP) позволяет за один проход модели параллельно строить несколько полных цепочек семантических ID.

Что происходит на втором шаге фреймворка, подробно разберём в следующем посте.

@RecSysChannel
Разбор подготовил ❣ Артём Ваншулин


WHALE: A Scalable Unified Model for Recommendation with Wukong-HSTU Architecture

Сегодня разбираем статью от Meta*. Это практическая работа о том, как в большом сервисе коротких видео повысить качество модели на этапе финального ранжирования. О жёстких ограничениях латенси тоже не забываем.

Главный вопрос — куда направить дополнительный вычислительный бюджет в рантайме. Варианты такие:

- на моделирование взаимодействий признаков,
- на моделирование последовательности действий пользователя,
- на то и другое.

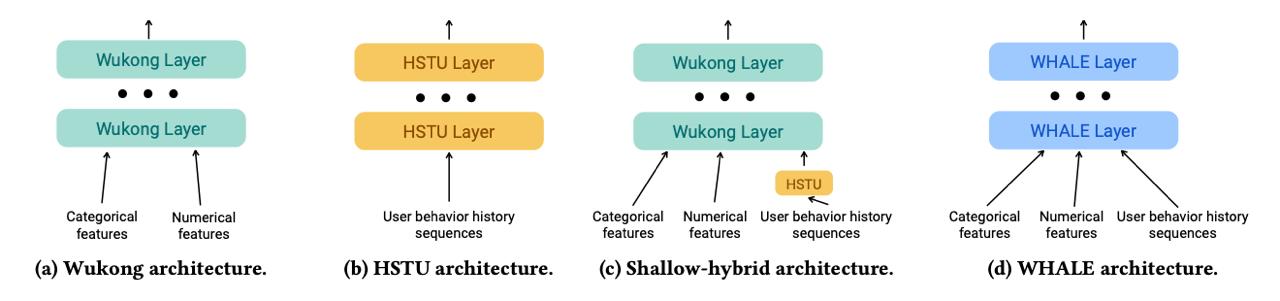
Авторы выбрали третий вариант и предложили WHALE — архитектуру из двух параллельных веток с модулем фьюзинга:

1) Wukong-модуль работает со стандартными числовыми фичами: счётчиками и предиктами нижестоящих моделей.
2) HSTU-модуль обрабатывает исходную пользовательскую историю до 15 тысяч событий.

На каждом слое Wukong через cross-attention обращается к состояниям HSTU и вытаскивает информацию, релевантную конкретному кандидату. Получившееся представление передаётся на вход следующего слоя, там всё повторяется.

Информация идёт только из истории в Wukong, но не обратно, поэтому ветвь вычисления HSTU не зависит от кандидата. Таким образом длинную историю пользователя можно посчитать один раз и переиспользовать KV-cache для всех кандидатов.

В экспериментах авторы проверили, что вообще выгоднее масштабировать (вопрос, заданный в начале). Их основная оффлайн-метрика — Normalized Entropy (NE) — показывает улучшение logloss-модели относительно оптимальной константы. При сопоставимом бюджете на вычисления увеличение только Wukong дало всего до +0,06% NE, что близко к уровню шума. Масштабирование HSTU даёт +0,73%, а масштабирование сразу обеих ветвей в WHALE — уже +1,39%.

Отдельно проаблейтили раннее связывание через attention-механизм. Если cross-attention заменить обычным mean-пулингом, результат получается хуже на 0,23% NE. Почти весь выигрыш — именно от выборочного извлечения информации из несжатой истории.

Также WHALE проверили в двухнедельном A/B-тесте на срезе рекомендаций некоторой неназванной соцсети. По основной онлайн-метрике авторов получили +0,113% при снижении inference QPS на 5%.

Главный вывод, который тут подтвердили — дополнительный компьют в финальном ранжировании выгоднее тратить на длинную пользовательскую историю и её взаимодействие с кандидатом по глубине сети. Принципиально новой идеи здесь, кажется, нет. Но зато авторы взяли сильные бейзлайны, собрали из них нафаршированную модель и довели её до успеха в онлайне.

@RecSysChannel
Разбор подготовил ❣ Александр Плошкин

___
Компания Meta признана экстремистской; её деятельность в России запрещена.

998 1 14 2 22

Generating Long Semantic IDs in Parallel for Recommendation

Генеративные модели с Semantic ID обычно используют короткие ID, например из четырёх токенов. Делают так, потому что авторегрессионная генерация длинных даёт высокую задержку и большой расход памяти. Но с короткими тоже есть проблема — они ощутимо ограничивают выразительность представления объектов.

В статье RPG предложили отказаться от авторегрессионной генерации и предсказывать все токены Semantic ID параллельно. Благодаря этому можно использовать длинные Semantic ID — до 64 токенов, и это ключевой вклад работы.

Но для параллельной генерации не очень подходят обычные Semantic ID на основе RQ. В RQ каждый следующий токен кодирует остаток после предыдущего, поэтому токены последовательно зависят друг от друга, а первые оказываются важнее последних. Вместо RQ авторы используют OPQ, который сначала преобразует item-вектор, а затем делит его на отдельно квантуемые подпространства. Поэтому токены получаются более независимыми и сбалансированными.

На обучении используется multi-token prediction loss. Модель параллельно предсказывает токены, а не сами товары, и для каждой позиции Semantic ID задан конкретный таргетный токен. Хотя генерация параллельная, позиции ID фиксированы — эквивалентность между разными комбинациями токенов на обучении не учитывается.

На инференсе возникает другая проблема. Независимо предсказанные токены могут сложиться в комбинацию, которой нет ни у одного реального айтема. Чтобы решить это, авторы используют graph-constrained decoding. Вершины графа соответствуют валидным Semantic ID реальных айтемов, а рёбра связывают похожие ID. Поиск проходит по этому графу и не требует полного перебора каталога.

Согласно приведённым результатам, RPG занимает первое место в 15 из 16 сравнений среди бейзлайнов. А по метрике NDCG@10 показывает в среднем относительный прирост 12,6% по сравнению с сильнейшим бейзлайном.

При этом в эксперименте на датасете Sports runtime GPU memory примерно в 25 раз ниже, а инференс почти в 15 раз быстрее относительно TIGER. При фиксированных параметрах декодирования время инференса и используемая GPU-память не зависят напрямую от числа айтемов. Однако полное хранилище, включая decoding graph и отображение айтемов в токены, растёт вместе с каталогом.

Отдельно авторы анализируют выразительность Semantic ID на энкодерах sentence-t5-base и text-embedding-3-large. Получается интересное: сильный энкодер сам по себе не гарантирует прирост. TIGER с коротким ID может потерять часть информации из хорошего эмбеддинга, тогда как RPG с длинным OPQ-ID лучше её сохраняет.

Абляции, которые в работе довольно подробные и убедительные, подтверждают, что отдельные части подхода работают именно вместе. При этом в целом статья пока выглядит скорее как исследование, чем как готовое продакшн-решение, потому что эксперименты проведены только на публичных Amazon-датасетах, production latency benchmark отсутствует, а обновление графа при изменении каталога не исследовано.

@RecSysChannel
Разбор подготовила ❣ Варвара Родионова


Три статьи на стыке LLM и Recsys

Сегодня делимся сразу тремя работами о том, как LLM встраивают в разные части рекомендательных и шопинговых систем.

Building a Production Shopping Agent at Scale

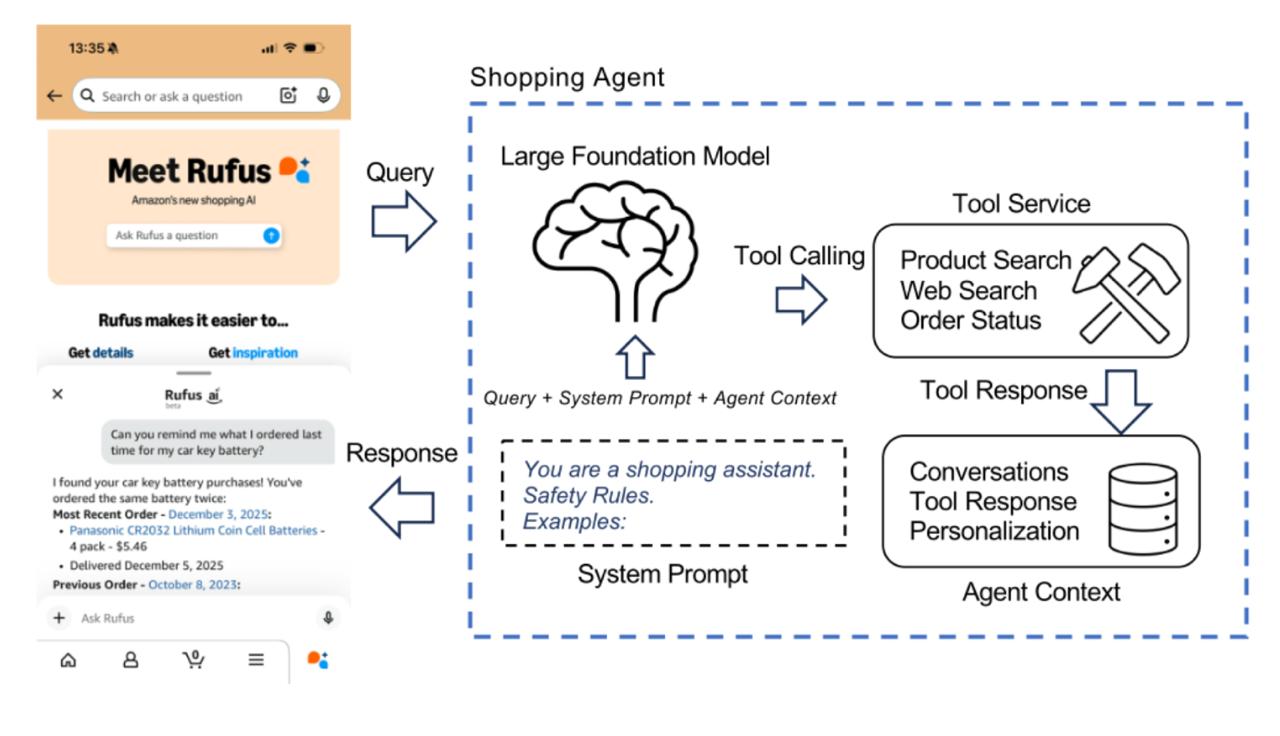
Amazon делятся опытом внедрения их шопингового агента Rufus. Здесь LLM — оркестратор: она принимает запрос пользователя, контекст диалога и релевантные пользовательские фичи и по ним понимает, в какие тулы нужно сходить, чтобы удовлетворить интент. По результатам работы тулов модель формирует окончательный ответ пользователю.

Агент работает в нескольких сценариях: 1) помогает с Product Discovery, когда пользователь ещё не знает конкретный товар; 2) отвечает на вопросы о конкретных товарах; 3) обращается к профилю пользователя, например смотрит прошлые покупки и текущие заказы, и может сам добавлять товары в корзину.

Авторы показывают несколько приёмов для ускорения цепочки.

• Отбирают только релевантные события из истории пользователя и сокращают историю диалога, чтобы не засорять контекст и уменьшать время до первого токена.
• Оптимизируют промпты, делая более стабильные и переиспользуемые префиксы, чтобы не пересчитывать одинаковое состояние агента.
• Делают вызовы тулов строже и по возможности параллелят, чтобы быстрее выдавать результат пользователю.

Можно улучшать каждый компонент по отдельности, но просадить общий пользовательский опыт. Чтобы такого не было, авторы предлагают смотреть на систему end-to-end: насколько удачной была работа агента, устроил ли результат пользователя и насколько дорогим и долгим оказался весь пайплайн.

Probe-Then-Plan: Environment-Aware Planning

Авторы из JD решают задачу сложных пользовательских запросов. Здесь «сложные» — не те, что требуют сложного ризонинга, а те, которые понятны человеку, но плохо переводятся на язык каталога. Например, пользователь хочет подобрать что-то «к зелёной рубашке»: человеку понятно, что речь скорее о брюках, джинсах или обуви, а простой поиск может выдать ещё больше рубашек.

Авторы замечают, что часто достаточно один раз посмотреть на выдачу, чтобы понять, как исправить запрос. Поэтому сначала смотрят, что по исходному запросу выдаёт продакшен-стек. Небольшой Qwen определяет, всё ли с выдачей хорошо, слишком ли она маленькая или товаров много, но они не соответствуют запросу, и при необходимости предлагает план исправления. Модель дистиллируют из большой LLM, а затем дообучают с RL на бизнес-цели.

Даже маленькая модель даёт заметное замедление, поэтому 80% простых запросов оставляют текущему продуктовому стеку, а 20% сложных отправляют через новый пайплайн.

В офлайне подход заметно лучше слепого переписывания запроса. По качеству он уступает ReAct, зато сильно выигрывает по времени. В онлайне всё конвертируется в GMV.

RecGPT-Mobile

Здесь on-device LLM используют, чтобы быстро понять изменения интента в рекомендательной ленте.

Допустим, пользователь внезапно начинает чаще кликать по компактным рюкзакам и добавлять их в избранное. Специальный модуль замечает изменение поведения и триггерит систему. Из залогированных на устройстве релевантных событий формируется промпт для on-device LLM, которая генерирует query под новый интент. Он отправляется в облако, где большая продовая система возвращает релевантные товары и обновляет ленту.

Чтобы всё это работало на устройстве, используют Qwen3-0.6B с квантизацией, берут не всю историю, а только полезный контекст и запускают систему не на каждый случайный клик, а только когда поведение действительно меняется.

В экспериментах LoRA обходит полный тюнинг модели, а квантизация теряет не так много качества. В месячном A/B-тесте получили +2,5% GMV на четырёх поверхностях.

@RecSysChannel
Разбор подготовила ❣ Екатерина Дмитриева


GRank: Towards Target-Aware and Streamlined Industrial Retrieval with a Generate-Rank Framework

Сегодня разбираем статью о том, как построить ретривал для миллиардов айтемов, сохранить target-aware-ность, уложиться в жесткий latency budget и при этом обойтись без сложных индексов.

В классическом ретривале из миллиардов кандидатов нужно быстро вернуть тысячи или десятки тысяч айтемов, которые дальше пойдут в ранжирование. Поэтому часто используются двубашенные подходы: отдельно получаем юзерный эмбеддинг, отдельно — эмбеддинги айтемов, а дальше считаем какую-то простую функцию вроде dot product и ищем «ближайшие» к юзеру айтемы.

У такого подхода сильно ограничена выразительная способность, ведь эмбеддинги юзеров и айтемов взаимодействуют только через выбранную простую функцию, но никак иначе.

При этом хочется добавить target-aware-ность в архитектуру через более плотное взаимодействие конкретного кандидата с юзером. Например, если хотим понять, насколько юзеру релевантна компьютерная мышь, то можно посмотреть на историю его действий, увидеть что-то о ноутбуках и обратить внимание именно на это. То есть, хочется «перевзвешивать» историю юзера относительно конкретного таргета.

На ретривал-стадии так сделать не получится из-за того, что кандидатов слишком много и обработать их надо быстро. Можно строить сложные индексы на основе деревьев или графов, но их тяжело поддерживать, они замедляют инференс и становится труднее контролировать latency.

В работе предлагается от всего этого уйти и разбить ретривал на две стадии:

1) Генератор, который должен очень быстро вернуть чуть больше кандидатов, чем в итоге нужно. В продовом сетапе авторов он достаёт 2000 айтемов, количество которые потом сужаются до 500. При этом сам генератор на инференсе остается обычной двубашенной моделью.

2) Преранкер, который представляет собой target-aware-подход уже на маленьком наборе кандидатов через cross-attention, после чего выдает более выразительные скоры релевантности.

Самая интересная часть статьи — о том, как учится генератор.

Обычно мы берём юзерный эмбед после трансформера, считаем dot product с айтемом и учим модель отличать позитив от негативов. В GRank к этому добавляют вспомогательную target-aware-задачу.

Берут те же таргет и негативы, подставляют их в историю, прогоняют через трансформер с ранним связыванием и считают лосс по полученным скорам — генератор одновременно учится на обеих задачах.

На инференсе эта target-aware-компонента никак не используется, и мы получаем классический быстрый двухбашенный подход.

По аблейшенам эта компонента выглядит самой важной частью системы — если взять просто генератор, то жертвуем качеством; если добавить только ранкер, метрики лучше, но всё равно проседают относительно полного GRank. А когда к генератору добавляют target-aware-компоненту в лоссе, получается самый большой прирост.

По экспериментам авторы докладывают о двузначных приростах в Recall и NDCG, причём не только на своём датасете. При этом по пропускной способности GRank остаётся примерно на уровне предыдущего двубашенного решения, а подходы со сложными индексами проседают.

@RecSysChannel
Разбор подготовил ❣ Никита Степанов


OneReason Technical Report [2/2]

В первой части разобрали, как устроен OneReason-Bench и почему авторы вообще вводят многоступенчатый ризонинг вместо next-item prediction. Теперь посмотрим, как модель учат работать с itemic-токенами и почему претрейн оказался здесь так важен.

На претрейне модель прежде всего учат воспринимать историю пользователя и связывать семантические ID с текстом. Каждый айтем представляют четырьмя токенами: токеном домена и тремя семантическими ID. От завершающего токена из OpenOneRec отказались, чтобы сократить представление айтема и оставить больше контекста.

Данные для претрейна делят на четыре уровня гранулярности:

🔴на уровне токенов модель учат связывать с текстом отдельные itemic-токены, их префиксы и полные токеновые последовательности;
🔴на уровне айтемов — генерировать описания, восстанавливать itemic-токены по тексту и отвечать на вопросы о свойствах контента;
🔴на уровне отношений — понимать связи и переходы между айтемами через естественно-языковые объяснения;
🔴на уровне пользователя — работать с доменно сгруппированными и хронологически перемешанными историями, моделируя кросс-доменные связи и эволюцию интересов.

То есть претрейн не сводят к одному next-item objective. Обучающая смесь одновременно охватывает задачи от семантики отдельных токенов до моделирования полной пользовательской истории.

Около 28,4% токенов претрейна приходится на данные общего назначения: 26,85% составляют текстовые корпуса, а ещё 1,59% — мультимодальные. Они нужны, чтобы во время специализации на рекомендациях модель сохраняла общие reasoning- и instruction-following-способности. С такой смесью итоговая модель остаётся близка к исходному Qwen3-8B на общих LLM-бенчмарках.

Сам претрейн проходит в три этапа.

1) Сначала при замороженном бэкбоне обучают только новые эмбеддинги и соответствующие веса LM-головы для itemic-токенов.

2) Затем размораживают все параметры и продолжают обучение с меньшим learning rate.

3) На последнем этапе максимальную длину отдельных примеров увеличивают с 4K до 32K токенов, чтобы модель научилась обрабатывать полные пользовательские истории.

OneReason обгоняет рекомендательные бейзлайны и почти не просаживается на LLM-бенчмарках — в отличие от Open OneRec, которая заметно теряла в языковых способностях. При этом модель, обученная получать качество за счёт рассуждений, становится лучше и в режиме без ризонинга.

Аблейшны показывают, что добавление каждого следующего уровня гранулярности улучшает качество, а лучший результат даёт весь претрейн-рецепт целиком.

@RecSysChannel
Разбор подготовил ❣ Илья Мурзин


OneReason Technical Report [1/2]

Сегодня разбираем хайповый техрепорт от Kuaishou на 108 страниц, в котором авторы научились получать существенный профит от ризонинг-моделей в рекомендациях.

В предыдущих статьях — OneRec-Think и OpenOneRec — модели уже могли генерировать человекочитаемые рассуждения на естественном языке, но thinking-режим не давал стабильного прироста и иногда даже ухудшал рекомендации. В OneReason авторы предлагают полный рецепт, объединяющий улучшенное восприятие itemic-токенов, структурированный CoT и доменный RL. В результате reasoning trace наконец начинает помогать предсказанию, а общие способности модели в основном сохраняются.

В этом разборе сосредоточимся преимущественно на первой части рецепта: устройстве бенчмарков, токенизации и многоуровневом претрейне, который создаёт семантический фундамент для последующего ризонинга.

Авторы предлагают не предсказывать следующий айтем напрямую по шумной истории пользователя. Сначала модель строит структурированный reasoning trace в три этапа. На этапе Persona Abstraction она сжимает историю в компактный профиль устойчивых предпочтений. Затем Interest Expansion выделяет несколько возможных направлений интереса, подтверждённых поведением пользователя. Наконец, Transition Inference сравнивает эти гипотезы с учётом силы и свежести сигналов, их временной связности и соответствия целевому домену. После этого модель генерирует itemic-токены следующего айтема.

Способности модели авторы оценивают на четырёх последовательных уровнях:

R0 — связывать itemic-токены с их текстовой семантикой и отвечать на вопросы о свойствах айтемов;
R1 — выводить отношения и возможные переходы между айтемами на основе их семантики;
R2 — рассматривать историю пользователя как временную последовательность и восстанавливать эволюцию его интересов;
R3 — объединять предыдущие способности для next-item prediction.

Для каждого уровня в едином OneReason-Bench предусмотрен свой набор диагностических задач. Финальное качество рекомендаций измеряют в двух сетапах: 

🔴single-domain, где модель видит историю только из целевого домена,
🔴cross-domain, где получает взаимодействия пользователя из всех четырёх доменов, но предсказывает айтем из конкретного. Кросс-доменная история обычно даёт небольшой прирост, но для холодных пользователей помогает больше.

Чтобы модель вообще смогла строить такие рассуждения, сначала её пришлось научить понимать сами itemic-токены и пользовательские истории. Об этом поговорим во второй части.

@RecSysChannel
Разбор подготовил ❣ Илья Мурзин


InterFormer: Effective Heterogeneous Interaction Learning for CTR Prediction

Сегодня разбираем статью InterFormer об архитектуре под задачу CTR-prediction на гетерогенных данных: статичных признаках пользователя/айтема и поведенческих последовательностях.

Авторы выделяют две проблемы существующих подходов:  

1. слабое взаимодействие между sequence- и non-sequence-фичами;  
2. агрессивное раннее сжатие последовательностей через pooling/summary, из-за чего теряется много информации.

Ключевой вклад — модуль InterFormer, который обрабатывает разные типы признаков отдельно, но на каждом слое обменивает между ними сжатые представления:

🔴Interaction Arch — работает с non-sequence-фичами: user profile, item features, context. Ко входу добавляется summary последовательности, а в качестве бекбона можно использовать разные interaction-модули, например DCNv2 или DHEN.

🔴Sequence Arch — моделирует историю пользователя. Здесь sequence-эмбеддинги обновляются с учётом summary от non-sequence-фичей: сначала через personalized FFN, затем через multi-head attention.

🔴Cross Arch — слой обмена между двумя ветками. Non-sequence-признаки сжимаются через gated selection, а sequence-информация суммаризуется через комбинацию CLS-, PMA- и recent-tokens. Эти summary передаются в соседнюю ветку на следующем слое.

Идея в том, чтобы не «схлопывать» все признаки в один вектор слишком рано, а делать «двунаправленный обмен»: sequence помогает non-sequence-части, а non-sequence-контекст помогает sequence-моделированию.

Для задачи CTR используется стандартная бинарная кросс-энтропия.

Из публичных: AmazonElectronics (3M), TaobaoAds (25M), KuaiVideo (137M). Также авторы используют крупный внутренний датасет Meta* на 70B семплов.

На публичных датасетах InterFormer даёт лучшие результаты среди бейзлайнов. На внутреннем датасете Meta авторы показывают +0,15% NE, +24% QPS, а в pilot launch +0,6% uplift по по основным продуктовым метрикам.

Ablation studies подтверждают, что:

🔴bidirectional interaction лучше однонаправленного обмена;
🔴selective aggregation лучше раннего pooling/MLP/MHA-сжатия;
🔴удаление PMA, recent tokens, gating, PFFN или MHA ухудшает качество.

Главное достоинство InterFormer — имплементация идеи с двунаправленным взаимодействием между статичными признаками и последовательностями без агрессивного раннего сжатия. Однако архитектура получилась довольно сложной и тяжелой для распараллеливания, приросты на публичных датасетах небольшие, а самые интересные production-результаты получены на закрытых данных Meta.

@RecSysChannel
Разбор подготовил ❣ Никита Степанов
___
Компания Meta признана экстремистской; её деятельность в России запрещена.


Forward from: ML Underhood
Выкатили Sona Technical Report — о модели, которая заменила весь рекомендательный стек Яндекс Музыки

В этом месяце у службы рекомендательных технологий Яндекса произошли сразу два больших релиза.

Сначала показали вторую версию Gryphon — unified-архитектуры, которая объединяет в себе кандидатогенерацию и ранжирование. Это альтернативный OneRec подход к построению рекомендательных end-to-end-моделей.

А сегодня представили Sona — итог целого года работы команды, в результате которого удалось заменить весь стек рекомендаций Яндекс Музыки на единую модель. Внутри репорта — много деталей об архитектуре, инфраструктуре, многочисленные аблейшны. Это лучшее внедрение трансформеров в истории А/B-тестов в Яндекс Музыке.

Три основные вещи, благодаря которым это получилось.

1. Масштабируемая архитектура

Encoder-decoder, обучающийся хронологически на задачу Next Token Prediction без единой ручной фичи. Одной из самых сложных частей было сделать рецепт токенизации, который бы обеспечивал рост качества при росте словаря и числа токенов на документ.

2. Единая модель кандидатогенерации и ранжирования

OneRec ранжирует кандидатов отдельной моделью, причём с использованием ручных фич. Мы же стремились к совместному рецепту обучения и инференса. Проблема в том, что задача ранжирования слишком спарсовая и модель просто не обучается выполнять её достаточно хорошо. Решение — сжать год данных в ранжирующую модель, обучающуюся авторегрессивно, дистиллировать эти знания в совместную модель.

3. Инфраструктура обучения и инференса

Любые большие изменения в ML приводят к настолько же большим изменениям в инфраструктуре. Нам пришлось фактически построить новый движок рекомендаций с нуля. Очень важной компонентой стало онлайн-обучение: end-to-end-путь события от возникновения до обновления модели в инференсе укладывается в 1 час в 99% случаев.

Чтобы лучше понять, что именно в модели поменялось между двумя А/B-тестами — который показывали в Gryphon-v2 и который репортим в Sona, — посмотрите табличку с масштабированием слоёв ранжирующего модуля и контекста и компрессией истории (картинка №2).

По сравнению же с текущей продакшен-системой в Sona получили статзначимый рост главных метрик:

🔴+4,53% Active Users — основной метрики эксперимента;
🔴+6,30% Total Listening Time — общего времени прослушивания;
🔴+11,42% Likes — количества лайков.

Причём это прирост поверх улучшений от предыдущих внедрений, которые оставались в контрольной выборке в продакшне.

Рост Active Users оказался в 2,35 раза выше прироста, который ранее дала Argus — самая сильная модель, использовавшаяся на этой поверхности до Sona.

Главный результат работы — получили одну совместно обучаемую модель, которая заменяет собой многоступенчатый рекомендательный каскад и при этом повышает качество рекомендаций на реальном пользовательском трафике.

Подробнее о том, как всё устроено и как к этому пришли, руководитель службы рекомендательных технологий Николай Савушкин расскажет на Practical ML Conf.

ML Underhood


State of Routing in Model Serving at Netflix

В наши дни большинство рекомендательных сервисов используют ML-модели: от линейных и градиентного бустинга до развесистых нейросетей. Если в продукте появляется первая поверхность для подключения продвинутых рекомендательных технологий, то самое простое — внедрить нужную модель в бэкенд сервиса.

Однако после запуска всё только начинается. Нужно как-то обновлять модели, тестировать новые архитектуры, подключать новые рекомендательные сценарии и при этом не упереться в ограничения железа.

Сегодня разбираем пост, в котором описана инфраструктура для инференса ML-моделей в Netflix. Посмотрим, как они решают эти вопросы в рамках своей платформы Switchboard.

Ключевые принципы платформы:

🔴Сотни типов моделей и десятки поверхностей для их использования (персонализированные рекомендации фильмов, антифрод).

🔴Суммарно ~1M RPS.

🔴В API есть абстракция Objective — идентификатор поверхности, для которой нужно посчитать ML-модель.

🔴В продуктовом коде один раз пишется интеграция с платформой, а в запросе передаётся информация о текущем Objective и текущем «контексте» (например, UserId, CountryId, DeviceId).

В Netflix используют более широкое понятие serving: кроме самого инференса модели, оно включает получение данных из внешних сервисов по идентификаторам из «контекста», расчёт фичей поверх входных данных, которые идут на вход в инференс, запуск модели и пост-обработку результатов.

🔴Продуктовый код «не знает», что у ML-моделей бывает версионирование, изменение архитектуры и постоянные A/B-эксперименты. Не знает, какие данные реально будут использованы при вычислении.

🔴ML-инженеры проводят эксперименты через Switchboard и могут с помощью динамических конфигов выбирать, какие модели будут обслуживать разные Objective.

🔴Инженеры Switchboard имеют контракты по SLA для нужных Objective и скрывают шардирование ML-моделей по различным кластерам, переливание трафика между моделями, A/B-эксперименты и миграции.

Но есть три критичные проблемы:

1. Switchboard становится единой точкой отказа — любой сбой на уровне входной прокси может задеть много ML-сценариев.

2. Появляется просадка по latency (~10–20 мс): дополнительный сетевой хоп, обработка входного payload'а (парсинг всего запроса для определения Objective и параметров, необходимых для управления трафиком) и нарезка A/B-экспериментов (тоже через внешний сервис).

3. «Шумные соседи»: клиенты могут неожиданно повысить нагрузку и неявно помешать запросам других клиентов.

Тогда в Netflix решают аккуратно избавиться от единой прокси в Switchboard. Но при этом важно не потерять классные свойства и абстракции, которые уже устоялись. Нужно, чтобы в клиенте появилась вся информация, которой владеет Switchboard, для определения, куда именно проксировать запрос.

Логику Switchboard делят на два компонента, которые скрыли в более умном клиенте на стороне продуктового кода:

1. Появляется отдельный легковесный сервис Lightbulb, в который клиенту надо отправить нужные «контекстные» данные и получить информацию, какую модель (routingKey) надо считать (по сути, нарезка трафика для необходимых кейсов).

2. Локально поднимается Envoy-прокси, куда независимо доставляют маппинги, на каких хостах какие ML-модели живут (routingKey → hosts).

Со стороны клиента остаётся пробросить routingKey в хедерах запроса в локальный Envoy, который согласно своим маппингам сделает запрос в нужный хост.

В итоге удалось избавиться от единой прокси и дополнительного сетевого хопа, а также от лишнего парсинга запроса на стороне Switchboard в пользу легковесных запросов в Lightbulb. И сохранить все продуктовые свойства платформы тоже удалось.

Ребята из Netflix репортят это как заслуженный успех, но часть деталей в статье не раскрыта и, скорее всего, требует отдельной проработки. Например, не сказано, что происходит в случае сбоев Lightbulb, который по сути стал новой единой точкой отказа и как происходит расселение ML-моделей по хостам. Поэтому ждём от Netflix постов с новыми деталями.

@RecSysChannel
Разбор подготовил ❣ Александр Михеев


Работы о рексистемах на SIGIR 2026

На прошлой неделе в Мельбурне прошла конференция по исследованиям и разработке информационного поиска. Наша коллега Екатерина Дмитриева побывала в Австралии и рассказала о трёх работах, которые отражают основные тренды SIGIR.

Ключевая мысль — генеративный ретривал остаётся очень актуальным направлением в исследованиях, но при этом пока в индустрии не готовы полноценно заменять им всю каскадную систему. Поэтому более классические работы по улучшению ранжирующих моделей всё ещё важны.

HyFormer: Revisiting the Roles of Sequence Modeling and Feature Interaction in CTR Prediction

Одна из таких классических работ. Авторы из ByteDance предлагает CTR-модель, в которой обработка пользовательской истории и ручных фичей объединена в многоуровневой архитектуре.

Основная фишка модели — использование специальных Global Tokens, которые изначально строятся из смеси непоследовательных признаков и агрегированных представлений истории для связи двух источников сигналов.

Эти токены в каждом HyFormer-блоке проходят две стадии:

1) в Query Decoding используются как queries для cross-attention к layer-wise K/V истории;
2) в Query Boosting смешиваются с признаками пользователя, контекста и кандидата через лёгкий MLP-Mixer.

После обеих стадий обновлённые Global Tokens передаются в следующий HyFormer-блок.

В отличие от более устоявшейся архитектуры — как, например, LONGER + RankMixer — HyFormer связывает историю и остальные признаки на всей глубине модели, а не только после её сжатия. По сравнению же с MTGR и OneTrans, она раздельно обрабатывает разные последовательности и использует небольшое число Global Tokens вместо общего дорогого self-attention.

GenRec: A Preference-Oriented Generative Framework for Large-Scale Recommendation

Работа команды JD.com о генеративном кандгене в ленте на главной странице JD App, где decoder-only-модель напрямую генерирует Semantic IDs товаров из всего каталога.

Главная особенность GenRec — Page-wise NTP, при котором вместо обучения на одном следующем товаре модель предсказывает сразу все взаимодействия внутри страницы: заказы, клики и показы товаров. Так авторы борются с проблемой Point-wise NTP, где одному контексту соответствуют несколько разных таргетов, и одновременно получают более плотный обучающий сигнал.

Помимо Page-wise NTP, предложены ещё два улучшения. Token Merger объединяет токены Semantic ID товара в один вектор, примерно вдвое сокращая историю, а к стандартному GRPO добавляется NLL-регуляризация, не позволяя генерации слишком далеко уйти от реальных пользовательских взаимодействий.

OxygenREC: An Instruction-Following Generative Framework for E-commerce Recommendation

Ещё одна работа команды JD.com о генеративных рекомендациях, но уже сразу в нескольких сценариях JD App: от главной и товарных лент до корзины и чекаута.

Работа следует принципу Fast-Slow Thinking: near-line LLM анализирует профиль, контекст, запросы и историю пользователя, формируя кэшируемые Contextual Reasoning Instructions. Во время обучения представления инструкций сближаются с таргетными товарами через Query-to-Item loss, а во время инференса используются для отбора наиболее релевантных событий из долгосрочной истории.

Чтобы одну модель можно было использовать на разных поверхностях, на этапе постобучения MCTS отдельно для каждого сценария исследует последовательности Semantic IDs. А Joint Pareto Optimization совместно обучает общую policy, балансируя цели разных сценариев.

#YaSIGIR26

@RecSysChannel
Интересное увидела ❣ Екатерина Дмитриева


TurboQuant: Redefining AI efficiency with extreme compression

Обсудим небольшую статью от Google о новом способе квантования векторов для сжатия KV-кэшей. Она зафорсилась после публикации и обросла множеством домыслов. Сейчас, когда ажиотаж схлынул, попробуем разобраться, в чём её суть.

В отличие от классических подходов для сжатия KV-кэшей в статье рассматривают задачу квантизации векторов в общем виде. По сути, её свели к независимой квантизации отдельных компонент вектора.

Методов квантизации вещественных чисел много, но почему этого недостаточно?

При восстановлении векторов после квантизации важно получить не вектора в первоначальном виде, а сохранить свойства относительно их конфигурации в пространстве. В частности, хочется минимизировать ошибку нормы вектора и скалярного произведения между парами векторов до квантизации и после восстановления.

Как задачу квантизации вектора свести к независимой квантизации его отдельных компонент?

Наши вектора будут иметь равномерное распределение на единичном n-мерном шаре. Из этого следует, что при больших размерностях векторов каждая компонента распределена «почти нормально», а между собой они «нескореллированы и почти независимы». Предположения сильные, но сводят задачу к независимой квантизации отдельных компонент, где каждая хорошо распределена.

Для квантизации с учётом желаемых свойств авторы предлагают подход TurboQuant. Он состоит из двух алгоритмов, применяющихся к каждой компоненте вектора:

1) Минимизация дисторшена (норма разницы вектора в исходном виде и после восстановления) за счёт того, что каждая компонента распределена «почти нормально». По сути используется известный подход «квантование с порогами», где оптимальные «пороги» можно посчитать заранее и закодировать нужным количеством бит.

2) Несмотря на минимизацию дисторшена, в отдельных компонентах будет накапливаться ошибка восстановления. Это влияет на скалярные произведения между векторами — будут получаться смещённые значения. Для минимизации таких ошибок отдельно кодируют 1 битом «поправку» к каждой компоненте при помощи ранее разработанного алгоритма. И получают теоретическую гарантию, что оценка скалярного произведения не будет смещённой.

Это уже описано в статьях. Главное же новшество работы в том, что удалось объединить известные методы и теоретически обосновать, что такая комбинация даёт нужные свойства с минимизацией ошибок.

Для оценки TurboQuant авторы попробовали разные типы задач (сжатие KV-кешей для LLM, приближенный поиск векторов), где было заявлено, что алгоритм показал приемлемое качество при простой реализации с точки зрения вычислений.

На примере рассмотрим, как проверяли способы квантизации KV-кэшей для Llama-3.1-8B-Instruct на тесте Needle-In-A-Haystack. Для проверки модель должна восстанавливать скрытое предложение из последовательности с длинным контекстом. Способы квантизации, перечисленные на иллюстрации, справились хуже, а алгоритм TurboQuant без проблем прошёл его с учётом 4x сжатия. Эти результаты подтвердили теоретические выкладки: при квантовании методом TurboQuant нет существенных просадок по качеству.

Неужели всё так хорошо и TurboQuant — новый стандарт в индустрии? Есть нюансы:

🔴Для достижения специального распределения векторов требуется, чтобы они были отномированы и умножены на случайную матрицу. Это может быть непрактичным с точки зрения вычислений для некоторых приложений.

🔴Авторы заявляют что TurboQuant сжимает KV-кеши в 8 раз. Но в качестве бейзлайна берется формат fp32. Хотя в индустрии квантование в 4 или 8 бит — уже стандарт.

🔴Методы сжатия KV-кешей, связанные с изменением архитектуры моделей, позволяют ценой качества сжать их сильнее и получить приросты несравнимые с квантизацией отдельных компонент вектора.

Революция пока не произошла, хоть после поста в блоге Google и наблюдалась просадка рыночных котировок производителей полупроводников. Но, возможно, авторы смогут эти подходы усилить — и стоит ждать новых практических результатов.

@RecSysChannel
Разбор подготовил ❣ Александр Михеев


Тренды рекомендательных систем на ICML 2026 [2/2]

Продолжаем разбор докладов о рекомендациях с воркшопа The Generative Turn in Search and Recommendation.

OneReason: From Scaling to Reasoning in Recommender Systems

Доклад о том, как из OneRec V1/V2 многократно пытались сделать reasoning-модель, но получилось далеко не с первой попытки — рассуждающая модель оказалась хуже.

Выделяют четыре аспекта рассуждений — R0-R3: понимание товаров (разумеется, речь о Semantic ID), взаимоотношения/связи товаров, развитие интересов, рекомендации. На базе этих задач собирают претрейн, и он хуже не-думающего варианта.

Далее с помощью GRPO учат четырёх экспертов по доменам (Ad/Video/Product/Live — от 7% до 19% профита относительно универсального mix-варианта) и с помощью rejection sampling поверх mix-RL-варианта дистиллируют их в одну модель, в которой думающая версия наконец-то побеждает.

При этом, если верить слайдам, думающая модель применяется не в реальном времени (чтобы победить задержки и вычислительную сложность) и в параллель с не-reasoning-версией.

Towards Generative Recommender in Facebook Marketplace Jobs

В этом докладе во многом идёт рассуждение о Semantic ID. Выносится понятная мысль, что они позволяют сократить контекст на 50X с одной стороны, и увеличить глубину истории до 1K+ с другой. К тому же оперировать токенами модели всё-таки привычнее.

Авторы утверждают, что в их задаче — Jobs — это критично: описания длинные, элементы обновляются слишком часто, документы холодные, сигналы разреженные.

Как и в докладе Shopify, обучение состоит из отображения товаров в Semantic ID — RQ-KMeans/RQ-VAE, их выравнивания и Multitask-SFT, при этом без RL, что несколько конфликтует с другими докладами.

Касательно SID: авторы замечают, что они весьма lossy, то есть, теряют много информации. Умное добавление текста к SID может помочь, не сильно теряя выигрыш от скорости — всё ещё X20 к полнотекстовому варианту.

Как и в первом докладе, утверждается, что запущенный вариант — поточечное LLM-ранжирование + традиционная value model поверх неё, что позволяет сохранить гибкость в решении: например, крутить свежесть в выдаче понятным образом.

Осмысление

В целом, можно было бы сказать, что RecSys движется от каскадных рекомендательных систем к генеративным рекомендациям, да вот в первом докладе было переранжирование, а в последнем — вообще pointwise-ранжирование.

Можно было бы сказать, что всё движется в сторону advanced RL-подходов, да вот снова в двух других докладах им не уделили внимания.

Что можно утверждать наверняка: методы из NLP, как и 10 лет назад, продолжают проникать в RecSys, и эта тенденция не планирует останавливаться. А с появлением разного рода «товарных» чатов интеграция будет заметно глубже.

P. S. У нас тоже был постер о рекомендациях. Правда, довольно нишевых.

#YaICML2026

@RecSysChannel
Разбор подготовил ❣ Кирилл Шевкунов
___
Компания Meta признана экстремистской; её деятельность в России запрещена.


Тренды рекомендательных систем на ICML 2026 [1/2]

В этом году о рекомендациях много говорили на тематическом воркшопе The Generative Turn in Search and Recommendation. Сегодня разберём доклады оттуда.

Meta GR2: Advancing LLM-Based Recommendation System through Reasoning

Unified RecSys with RL end-to-end optimization. Делают модель, переранжирующую список кандидатов — что отличает их от чисто генеративных рекомендаций. Механизм примерно следующий:

Шаг 0. Большая текстовая reasoning-модель получает на вход контекст и список кандидатов. А на выходе возвращает итоговый порядок — качественно и дорого в плане инференса. Далее стоимость будет падать при относительном сохранении качества.

Шаг 1. Mid-train: обучение студента, где товары обозначены Semantic ID — спецтокенами, обозначающими подсклеенные айтемы, полученные через RQ-VAE. Как делать это хорошо — отдельный разговор. Используют и рекомендательные задачи (следующий товар, суммаризация интересов пользователя и т.п.), и некие general-domain data.

Шаг 2. RL post-training, on-policy distillation, etc. Разных техник описано много. Cодержательно, что авторы заявляют -3% качества к проду у zero-shot, +5% у SFT, +18% у итогового решения. То есть, основной профит прячется здесь.

Шаг 3. Дистилляция reasoning в low-think/no-think — всё ещё экономят токены.

Шаг 4. Инфраструктурные улучшения — собирают X'ы ускорения за счёт плясок вокруг CUDA graph pre-fill, KV cache, prompt compression. Полный список не влез даже в исходную презентацию.

В итоге со всеми ухищрениями получают маленькие — 0.6B и 1.7B — модельки с вполне катабельными таймингами. Имхо, приятное свойство доклада — опциональность шагов. Это хороший план действий.

Generative Catalog Search. Building Shopify’s Generative Product Search

Относительно обычный генеративный подход — SID-LLM. Но интересным показалось не это, а их бейзлайн — прошлый прод. Там указан Generative Query Rewriting + Hybrid Retrieval (lexical matching + embedding-based retrieval).

Далее утверждается, что чисто генеративная часть ухудшала метрики на 10%, а будучи замешанной в параллель с их прошлым способом поиска товаров, наоборот, подрастила на 2%.

Связано ли это с тем, что бейзлайн был сильнее, или с тем, что последний шаг на Model Training Stages — SFT, непонятно. Впрочем, внедрить Generative Query Rewriting явно проще, чем полноценные генеративные рекомендации, раз уж он есть у Shopify — значит, в нём есть толк.

Ground Truth for the Generative Turn: Human Judgment at Scale for Search and Recommendation

Учитывая, в скольких разных местах используются разные вариации на тему LLM-as-a-judge, несложно догадаться, что в докладе замешана Toloka.

Несколько обрывочно говорят о том, почему люди всё-таки нужны, и что одной только информации о кликах-покупках не хватит. Еë недостаточно, например, для оценки всяких рассуждений и рефразов. Рассказывают о своих экспертах: нашли 5000 оценщиков с подтверждёнными покупками на целевом US/Canada-рынке, отсеяли 90% по качеству, через 14 недель устаканились на уровне в 315 человек.

Далее заметили, что в большинстве категорий люди оценивают покупки из своей категории заметно строже, что должно растить качество разметки. При этом переучивать и сводить строгих/слабых разметчиков у авторов не получилось, разброс строгости остаётся прежним на протяжении недель.

Выделяют пять слоёв контроля разметки:

1. Контрольные задания — выкинуть 90% самых слабых.
2. Технические проверки — всё, что верифицируемо.
3. LLM-проверки или LLM-критик, который подсвечивает ключевое, но не принимает решения за человека.
4. Кворум — ловит шум отдельных разметчиков.
5. Проверка заказчиком.

В целом, из своего опыта замечу, что заказывать людям хорошую разметку очень дорого, а плохая разметка в целом уже не нужна.

#YaICML2026

@RecSysChannel
Разбор подготовил ❣ Кирилл Шевкунов
___
Компания Meta признана экстремистской; её деятельность в России запрещена.


Поточечное ранжирование vs генеративное: три работы с ICML 2026

Прямо сейчас в Южной Корее идёт ICML — одно из самых масштабных событий в мире машинного обучения. Почти все бигтехи рассказывают похожую историю: обычное поточечное ранжирование постепенно пытаются заменить генеративным.

Вместо моделей в духе HSTU, предсказывающих CTR для каждого кандидата по истории пользователя, всё чаще обсуждают модели, которые генерируют порядок, объяснение или идентификаторы объектов напрямую. А затем — дообучаются через RL на симуляторе, оценивающем финальное ранжирование.

Вот три примера таких моделей, которые обсуждали на ICML.

Meta GR2: Advancing LLM-Based Recommendation System through Reasoning

Команда Meta представила GR2 — генеративный реранкер для финального этапа рекомендательной воронки. Сначала отдельная кандидатогенерация отбирает около 100 кандидатов, затем генеративная модель переранжирует их.

Для обучения строят симулятор, который оценивает итоговое ранжирование, а потом оптимизируют модель через RL по этому сигналу. Основной упор делают на рассуждениях модели: по эмпирическим результатам, именно этот блок даёт большой прирост качества.

Основной интерес работы в том, что кандидатогенерация реализована отдельно от ранжирования. Это не подход в духе OneRec, где модель пытается сама генерировать объекты из огромного пространства, а более практичная схема: сначала привычно отобрали кандидатов, потом генеративно улучшили финальный порядок. Для рекламных систем такой вариант звучит особенно реалистично.

OneReason: from Scaling to Reasoning in recommender systems

OneReason — более общий подход: здесь нет отдельной кандидатогенерации, модель должна сама работать с объектами и генерировать рекомендации.

Интересно, что простое добавление рассуждений сначала сильно портило качество, и значительная часть работы посвящена тому, как это исправить. Авторы подробно разбирают, как привязывать идентификаторы объектов к их смысловому описанию, как учить модель рассуждать над историей пользователя и как не потерять качество при переходе от обычного скоринга к генерации.

В этом главное отличие от GR2: там генеративный реранкер встраивается в уже готовую воронку, а здесь пытаются построить более общую генеративную модель рекомендаций.

Generative Catalog Search

Shopify рассказали про генеративный поиск по каталогу для e-commerce. По сути, они движутся в ту же сторону, что и старшие коллеги: уходят от поточечной оценки кандидатов к оптимизации итоговой выдачи через RL.

До явного рассуждения модели они пока не дошли, но сам переход от pointwise к обучению на сигнале качества финального ранжирования уже дал заметный прирост. В такой постановке это особенно естественно для интернет-магазинов, где важно не просто оценить каждый товар отдельно, а собрать хорошую выдачу под запрос пользователя.

Общий тренд

Индустрия движется от каскадных рекомендательных систем к генеративным рекомендациям, а от прямого обучения на сигналах из прода — к RL на моделях, которые оценивают качество финальной выдачи.

Пока самые практичные варианты выглядят как надстройка над существующим пайплайном: кандидатогенерация происходит отдельно, а генеративная модель улучшает финальное ранжирование. Мы в Яндекс Рекламе тоже собираемся пробовать такие подходы.

#YaICML2026

@RecSysChannel
Разбор подготовил ❣ Максим Кузин
___
Компания Meta признана экстремистской; её деятельность в России запрещена.


Closing the Online-Offline Gap: A Scalable Framework for Composed Model Evaluation

В рекомендательных системах итоговый скор обычно считается не одной моделью, а композицией нескольких предсказаний. Например, одна модель предсказывает вероятность клика, другая — конверсии после клика, третья — конверсии без клика. Затем эти значения объединяются в итоговый eCVR — оценённую вероятность конверсии, которая используется в ранжировании.

Проблема в том, что модели часто обучают и оценивают изолированно: по AUC, logloss, Normalized Entropy и другим офлайн-метрикам на собственном целевом событии. Но в продакшене предсказание модели — это только один компонент итогового скора. Поэтому улучшение локальной офлайн-метрики не всегда означает улучшение онлайн-метрик.

Meta* предлагает фреймворк iPCF — Intelligent Prediction Composition Framework. Его идея в том, чтобы оценивать новую модель не отдельно, а внутри той продакшн-композиции, в которой она реально используется. Для этого в логи добавляют предсказания всех моделей, участвовавших в итоговом скоре, идентификатор версии конфигурации ранжирования, информацию о том, куда какие предсказания подставлялись в композиционное дерево, и фактические метки: клик, конверсия и т.д.

Сама логика вычисления итогового скора хранится как версионированная конфигурация. Поэтому для исторического показа можно восстановить формулу, по которой тогда считался итоговый скор.

При оценке кандидата iPCF воспроизводит исторические запросы. В старую продакшн-композицию подставляют предсказания новой модели, а предсказания остальных моделей и бизнес-логику оставляют такими, какими они были в логах.

В результате получают симулированный итоговый eCVR — оценку итогового скора, если бы в тот момент вместо старой модели использовалась новая.

После этого офлайн-метрику считают уже не по локальному выходу модели, а по пересчитанному итоговому скору. Так можно сравнить базовый eCVR и симулированный eCVR кандидата, получить iPCF NE или другую iPCF-метрику и оценить офлайн-прирост кандидата.

Смысл в том, что iPCF измеряет не просто качество модели на её собственном целевом событии, а влияние замены этой модели на итоговый ранжирующий скор.

В экспериментах авторы проверяют, насколько хорошо офлайн-прирост предсказывает настоящий онлайн-прирост из A/B-тестов. Для этого используют простую линейную калибровку: предсказанный онлайн-прирост считают пропорциональным офлайн-приросту. Затем сравнивают предсказанный и реальный онлайн-прирост через L1-ошибку.

При использовании iPCF-метрики вместо обычной офлайн-метрики L1-ошибка снизилась на двух группах моделей: на M1 — примерно на 18%, на M2 — примерно на 2,8%. То есть iPCF в этих экспериментах лучше согласовывал офлайн-оценку с онлайн-результатами.

@RecSysChannel
Разбор подготовил ❣ Влад Аверков
___
Компания Meta признана экстремистской; её деятельность в России запрещена.


Gryphon: A Unified Architecture for Semantic-ID Generation and Item-Level Scoring in Industrial Recommendations

Разбираем статью о гибридной генеративно-ранжирующей модели в рекомендациях Яндекс Музыки. О ней на Data Fest рассказала Дарья Тихонович, руководитель Яндекс RND-команды, которая разрабатывает новые рекомендательные технологии.

Генеративные рекомендации на базе Semantic IDs позволяют применять подход next token prediction к огромным каталогам, где невозможно напрямую выбирать следующий объект из миллионов вариантов. Вместо того чтобы предсказывать конкретный трек сразу, модель генерирует его поэтапно через последовательность семантических токенов. Например, сначала определяет жанр (русский рок), затем исполнителя («Сплин»), а потом конкретную композицию («Летучий Голландец»).

Такие токены получают с помощью иерархической кластеризации контентных эмбеддингов объектов, где каждый уровень уточняет описание айтема. В результате каждый объект представлен компактным Semantic ID, а генеративная модель (например, TIGER от Google) предсказывает не сам объект, а последовательность его семантических токенов, благодаря чему возможно обучение и использование рексистем на многомиллионных каталогах.

Но у генеративных рекомендательных моделей есть ряд проблем:

🔴Коллизии Semantic IDs — разные айтемы могут получать одинаковые семантические идентификаторы, из-за чего модель не различает их.
🔴Слой разрешения коллизий не масштабируется — работает офлайн, но не подходит для динамического каталога, который постоянно пополняется.
🔴Без разрешения коллизий падает качество — при удалении этого слоя качество может снижаться в разы.
🔴Нужно расширять пространство токенов — для лучшей уникализации нужны более крупные кодбуки и больше семантических токенов.
🔴Копятся ошибки генерации — ошибка в раннем токене ведёт к неверной оценке всей траектории.
🔴Потолок качества при длинных Semantic ID — увеличение числа токенов увеличивает уникализацию, но перестаёт улучшать качество рекомендаций.

Gryphon: генерация + ранжирование в одной модели

Gryphon — гибридная архитектура, которая объединяет генерацию кандидатов и их ранжирование. В основе encoder-decoder: по истории пользователя модель через beam search генерирует набор Semantic IDs. Чтобы избежать накопления ошибок при генерации (Semantic Drift), в beam search используется PRM (Process Reward Model), которая оценивает траектории генерации и помогает выбирать только релевантные пути для продолжения.

После генерации все Semantic IDs отображаются в общем пуле айтемов-кандидатов, релевантность которых оценивается через ORM (Output Reward Model). В результате, генеративная часть отвечает за кандидатогенерацию на уровне Semantic ID, а ORM — за финальное ранжирование айтемов. PRM и ORM — это легковесные модули на основе cross-attention, которые переиспользуют выходы энкодера генеративной модели, и поэтому лишь незначительно растят общее количество параметров и стоимость инференса.

При обучении ORM на задачу next-item-prediction в офлайне Gryphon показал +20% прироста Recal@1000 относительно Argus. Более того, модель опередила по качеству полный softmax по каталогу Яндекс Музыки.

В A/B-тестах Gryphon полностью заменил стек кандидатогенерации и преранжирования Яндекс.Музыки (15+ моделей), сократив число кандидатов для финального ранкера с 3000 до 1000 без потери качества. В сравнении с генеративным бейзлайном модель дала +3,6% команд Like, сохранила продуктовые метрики и увеличила разнообразие рекомендаций.

Модель работает в рантайме и регулярно дообучается. Семантический индекс строится на мультимодальных эмбеддингах (аудио, текст, метаданные), полученных с помощью Qwen 2.5 Omni и дополнительно обученных на коллаборативном InfoNCE-лоссе.

Теперь у нас есть архитектура, которая объединяет генерацию и ранжирование и уже показывает качество значительно выше классических кандидатогенераторов и полного softmax. Сейчас Gryphon активно развивается в экспериментах с end-to-end-рекомендациями и кросс-доменными генеративными моделями Яндекса.

@RecSysChannel
Разбор подготовила ❣ Дарья Тихонович


GenRec: A Preference-Oriented Generative Framework for Large-Scale Recommendation

Разбираем статью от команды JD App — крупного китайского маркетплейса. Работа небольшая, но в ней есть несколько интересных идей на тему генеративных рекомендаций.

Обычный Next Item Prediction плохо соответствует тому, как пользователь в действительности взаимодействует со страницей. Юзер видит набор товаров, кликает, покупает, скроллит — и порядок этих действий не всегда отражает реальные намерения. Также есть проблемы логирования: события могут записываться не в том порядке, в котором пользователь их совершал.

Авторы предлагают перейти от Next Item Prediction к Page-Wise Next Token Prediction. Вместо того чтобы обучаться на отдельных действиях, модель рассматривает сразу всю страницу и все действия пользователя на ней. Действия сортируются по важности: покупки, клики, показы. Дальше модель делает один forward pass и суммирует лог-пробы всех действий. За счёт этого сигнал становится плотнее, а проблема неконсистентности между действиями и их логированием уменьшается.

Вторая часть работы посвящена сжатию длинных последовательностей. Каждый айтем представляют тремя семантическими id, поэтому без сжатия вычислительные затраты значительны. Чтобы сократить длину последовательности, используют Token Merger: конкатенируют три семантических токена и пропускают через линейную проекцию, получая один токен вместо трёх. Между семантиками одного айтема остаются разделительные токены, поэтому последовательность уменьшается не в три, а в два раза без сильной просадки качества.

Сами семантики получают через мультимодальный Qwen2.5-VL, добавляют коллаборативный сигнал и затем применяют residual quantization с K-means, получая три кодбука семантических токенов.

Третья часть — алайнмент через модификацию GRPO. Авторы используют preference model, которая оценивает айтемы из роллаутов и выдаёт реворд. Это нужно потому, что реальные пользовательские сигналы вроде кликов слишком спарсовые. Но при этом preference model может давать высокие скоры нерелевантным айтемам, поэтому добавляют gating-механизм, который зануляет реворд для нерелевантных пользователю рекомендаций.

Если пользователь действительно кликал или покупал айтемы из роллаута, его реворд дополнительно повышается — таким объектам назначают максимальный скор внутри группы. Дальше эти реворды используют в обычной формуле GRPO для подсчёта advantage. Вместо KL-регуляризации используют NLL-регуляризацию.

Основной прирост качества даёт именно Page-Wise-NTP. Когда сравнивают с LC-Rec на одинаковом backbone (Qwen2.5-3B) метрики выше. Token merger немного ухудшает качество, что логично — часть информации теряется при сжатии семантик.

Интересный момент при скейлинге. При переходе от 1,5B к 3B качество сильно выросло, а дальше — почти нет. Авторы связывают это с тем, что для генеративных рекомендаций важнее глубина модели, чем увеличение hidden size.

В онлайне получились большие приросты: около +9,5% по кликам и +8,7% по транзакциям. В аблейшнах видно, что основной вклад в RL-части даёт gating-механизм: без него reward alignment работает заметно хуже и больше галлюцинаций с невалидными айтемами.

@RecSysChannel
Разбор подготовила ❣ Вероника Иванова

18 last posts shown.