Марат пишет про науку (в основном)


Гео и язык канала: Россия, Русский
Категория: Познавательное


Кидаю сюда ссылки на свои тексты, рассуждаю про физику, искусственный интеллект и их связь с видеоиграми и масскультурой
@zumrus

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Статистика
Фильтр публикаций


Что ни день, то новое соприкосновения мира видеоигр и машинного обучения.
 
На этот раз в Factorio собрали языковую модель. Не большую — параметров «всего» 6,4 миллиона, но уже больше, чем у аналогичного проекта в Minecraft. Контекстное окно крошечное — 256 символов, однако для недлинных вопросов хватает, отвечает же модель со скоростью в среднем 1 символ в 7 секунд.
 
Factorio — это симулятор строительства про космического Робинзона Крузо, который, попав на необитаемую планету должен построить себе новый корабль. Игру иногда называют «Minecraft для повзрослевших инженеров» из-за того, что акцент в ней смещён с выживания и творчества на инженерное строительство и автоматизацию. Поэтому там, естественно, есть различные арифметические и логические блоки — комбинаторы. Именно на них и был собрать трансформер.
 
Автор проекта под ником RomOSTiny предварительно обучил свою модель, и она может отвечать на вопросы о Factorio, сочинять короткие истории и шутить на английском языке. Он выложил на GitHub сохранения мира с собранной там моделью, для запуска требуется Factorio 2.0 с дополнением Space Age. Больше подробностей — в видео на его YouTube-канале.


Я постоянно твержу, что видеоигры могут быть полезны для науки. Раньше я употреблял фразу «нераскрытый потенциал», но сейчас так не говорю — в наши дни исследователи активно используют их. В фокусе моего внимания обычно то, что связано с каким-то из направлений машинного обучения: то датасет собрали для компьютерного зрения, то использовали внутриигровую среду как симулятор для ИИ-агента, а то вообще сами игры начали отрисовывать с помощью нейросетей.

Недавно появился повод снова поговорить про эту тему, и он связан с одной старой, но очень популярной в среде компьютерных наук игрой под названием NetHack. Это пошаговый RPG-рогалик 1987 года с аскетичной графикой, но с довольно сложными правилами и процедурно генерируемыми локациями. Игра трудна, словно наша жизнь, и поэтому тестировать на ней ИИ-агентов — хорошая идея.

Фишка в том, что пока не существует бота, который бы регулярно проходил NetHack в автономном режиме (разовые успехи, однако, есть). Создать такого агента, кажется, не под силу в одиночку. И даже множество команд, работающих над одной проблемой разрозненно, скорее всего, будут наступать на одни и те же грабли.

По этой причине мой коллега по AIRI Владислав Куренков запустил открытое сообщество NetHackers, для организации такой распределённой науки. Цель сообщества — создание программы, способной самостоятельно и систематически проходить NetHack. Понятно, что сам факт прохождения игры — не ценность. Ценность здесь — идеи и алгоритмы, которые могут быть полезны всему миру в самых разных областях.

Больше об игре, сообществе и философии проекта сам Владислав рассказывает в тексте, который мы выпустили сегодня на Хабре AIRI. Если вы разрабатываете ИИ‑агентов, занимаетесь планированием или пишете игровых ботов, вас будут рады видеть в NetHackers.


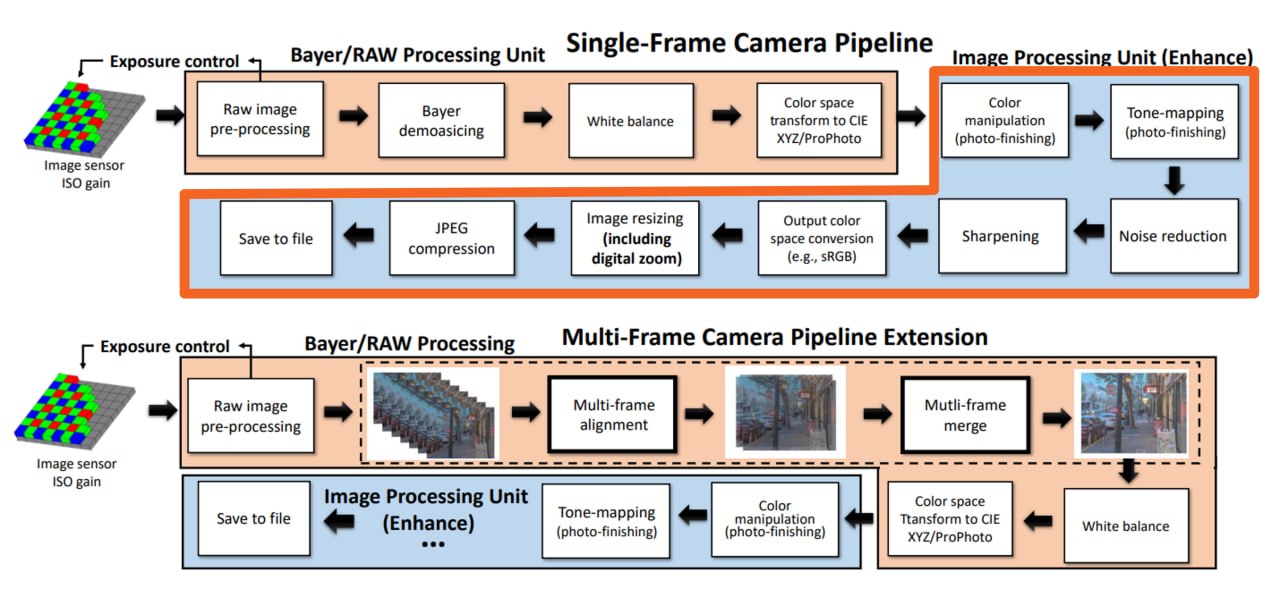
А тем временем у нас на Хабре вышла новая статья-конспект лекций по вычислительной фотографии от руководителя одноимённой команды в AIRI и заведующий сектором репродукции и синтеза цвета ИППИ РАН Егора Ершова. Она завершает рассказ про типичный конвейер обработки изображений в современных цифровых камерах: от нажатия на спуск до сохранения в памяти устройства.

Если предыдущие две статьи рассказывали про аппаратное преобразование визуального сигнала, то новый текст объясняет, что происходит с картинкой на программном уровне: наложение фильтров, шумоподавление (да, снова), перевод в нужное цветовое пространство и упаковку в JPEG.


На днях в Сан-Франциско прошёл необычный заезд. Четверке ИИ-агентов на базе топовых коммерческих моделей GPT-6 Astra, Claude Fable 5.1, Grok 4.6 и GPT-5.6 Sol дали по очереди поуправлять тойотой и поставили задачу проехать 130 метров с несколькими поворотами по пустынной парковке. Справилась только свежая модель от OpenAI, да и та со второй попытки.

С точки зрения современных систем автономного вождения это детский сад — индустрия проходила такое много лет назад. И все же, для фронтирных моделей общего назначения на базе LLM прошедший заезд знаменует собой определенный прогресс. О том, что это за прогресс и стоит ли ожидать автопилотов на базе моделей GPT, разбираюсь в свежем блоге для N + 1. Не обошлось в тексте и без так любимых мною видеоигр, некоторые из которых GPT-6 Astra прошла впервые в истории автономных ИИ-ботов.


Чем больше я пишу про искусственный интеллект, тем сильнее меня одолевают приятные чувства, когда появляется возможность вернутся к корням и порассказывать про физику. Сегодня именно такой случай.

Я иногда говорю студентам: возьмите учебник по общей физике, какой-нибудь том, откройте оглавление. Будьте уверены — каждый параграф можно расширить каким-нибудь свежим научным знанием, добытым за последние 10-15 лет. Лучше всего это заметно в оптике, которая обогатилась метаматералами, металинзами, неклассическим светом и многим другим.

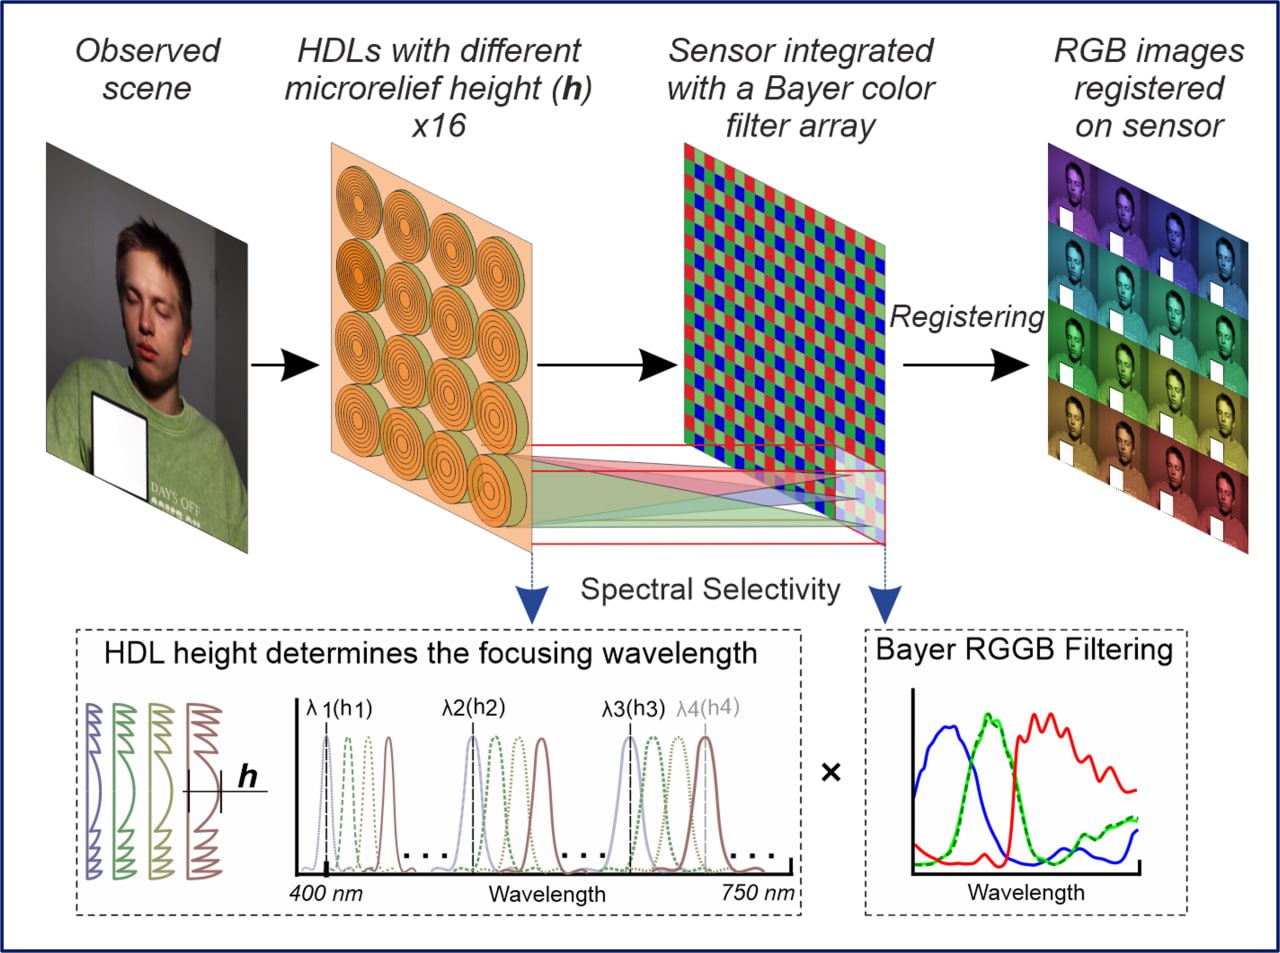
Тем отраднее мне, как оптику по специальности, было работать над последней статьёй в блог AIRI для Хабра. Она о том, как несколько наших сотрудников с коллегами из других университетов предложили простой и быстрый способ превратить обычную камеру в гиперспектральную — то есть такую, которая в каждом пикселе собирает не три числа в RGB-векторе, а полноценный спектр видимого диапазона, можно сказать, функцию.

Главный секрет успеха — объектив в виде массива из 16 гармонических дифракционных линз и нейросети, которая конвертирует получающуюся в фокальной плоскости мозаику в трёхмерный массив спектральных данных. По сути, такой оптический адаптер превращает камеру в спектрограф со всеми её преимуществами в виде мгновенности фотографирования, нужно лишь после обработать снимок специальной моделью.

О том, как это работает и чем лучше альтернативных подходов, читайте в свежей статье.


Видео недоступно для предпросмотра
Смотреть в Telegram
Не математикой единой гудит нынче техносфера, но ещё и виртуальными мухами.
 
Кратко: в начале сентября Google Research и HHMI Janelia опубликовали MaleCNS v1.0 — полную синаптическую карту взрослого мозга самца-дрозофилы на 166 тысяч нейронов. Это не первый такой проект, до этого в 2024 году увидел свет аналогичный датасет FlyWire для самки на 140 тысяч нейронов. Но на этот раз исследователи отсканировали всю ЦНС мухи, включающую брюшную нервную цепочку, где расположены моторные центры управления крыльями и ногами. По сути, это первый в истории завершенный взрослый коннектом сложного модельного организма, способного к навигации, обучению и социальному поведению.
 
Понятное дело, что главная цель была чисто научная — сравнить работу мозга самка и самки, и этому посвящена свежа статья в Cell. Но всё, что попало в интернет, как мы все прекрасно знаем, рискует стать смысловой единицей в суровой постироничной реальности цифровой эпохи.
 
Новый датасет не стал исключением, благо его создатели здорово подготовили инжерно и упаковали под стандартный инструментарий современных программистов и датасайентистов. Это открыло ящик Пандоры, и за неделю муху научили водить машину, играть в видеоигры, собирать кубик Рубика, торговать на бирже, управлять самолётом, пить пиво, смотреть тик-ток и тому подобное (в виртуальных средах, конечно). Перечислять всё бессмысленно — пока я пишу эти строки, наверняка в соцсетях вирусится очередной кейс, краше предыдущих.
 
В описанных выше вариантах муха — это и есть геймер, её обучали правилам через условные рефлексы. А есть проекты, где мушиную модель хотят поселить в Minecraft, чтобы, наоборот, поведение внутриигрового моба было максимально натуральным. На момент написания этой статьи майнкрафтовская муха лишь разрабатывается, и оценить его можно лишь по видео. Но в X я наткнулся на вот такую простенькую игру, в которой нужно раскидывать по квартире мусор, чтобы как можно больше мушек покинуло дом. Хоть и стормозами, но поиграть можно прямо в браузере.


Последние сутки в моей инфосфере только и разговоров о том, что новая модель от OpenAI решила одну из математических Задач тысячелетия…
 
Вообще-то, большими и малыми победами искусственного интеллекта в математике за последние полгода уже никого не удивишь. Но Задачи тысячелетия — это совсем другой уровень, ибо их решение неизбежно продвинет целые области. Неспроста на каждую Институтом Клэя выставлен приз — 1 миллион долларов.
 
На этот раз машина — а, точнее, рой из 10000 ИИ-агентов — кажется, смогли найти условия, при которых нарушается гладкость решений уравнений Навье — Стокса. Я пишу «кажется», потому что впереди долгая процедура верификации доказательства экспертным сообществом, но публика настроена весьма оптимистично. К сожалению, в этой истории не обошлось и без споров об авторстве.
 
Обо всём этом можно прочитать в разборе по горячим следам, который буквально только что вышел на N + 1. Подготовили его мои коллеги из AIRI, ну а я им немного помог.


Сегодня наконец-то дошла до сайта вторая часть разбора про Deus Ex для N + 1, прошу любить и жаловать.

Текст вышел лёгкий, в нём я перечисляю различные технологии, ищу научные источники, из которых команда разработчиков черпала свои идеи, и кратко их сопоставляю. Если первая часть целиком строилась вокруг роли нейроинтерфейсов в лоре приквелов Deus Ex, а потому по тематике не покидала нейронауки, то здесь мы затронем область новых материалов, нанотехнологии и даже геоинженерию.

Конечно, ко дню рождения обеих игр успеть не получилось, пусть тогда этот пост ознаменует грядущий Всемирный день видеоигр, который празднуют 29 августа.


Сегодняшняя дата — 23 августа — знаковая для поклонников франшизы Deus Ex. 10 лет назад вышла последняя полноценная игра серии, Mankind Divided, а 15 лет назад — её предшественница Human Revolution. Deus Ex отличает трансмедийность: зародившаяся в ААА-видеоиграх, эта киберпанковая история со временем обросла книгами, комиксами и мобильными релизами. Не самая популярная траектория в современном попкультурном мире, с ходу на ум приходит только Mass Effect, к которой я также отношусь трепетно.
 
Помимо прочего, Deus Ex и Mass Effect роднит и бережное отношение к научным аспектам показываемых миров. В случае с Mass Effect в этом можно убедиться, если прочитать мои разборы тамошней физики и искусственного интеллекта. Но и другие отрасли науки и техники вроде ксенобиологии или ракетостроения в Mass Effect тоже показаны довольно хорошо.
 
Deus Ex я только начал разбирать. Весной вышел текст про нейроинтерфейсы, а его вторая часть уже написана и находится в редактуре (увы, к юбилею не успели), там погорим про другие технологии.
 
Но праздник немного грустный: история, через которую проходит герой последних игр, была оборвана на полуслове со множеством намёков, а разработка игры, которая должна была бы дать нам все ответы, была свёрнута по корпоративным причинам. Отсутствие определённости породили среди фанатов множество теорий о происходящем. Обзору одной из них посвящён текст, который я написал к десятилетию Mankind Divided.


Недавно в Усть-Лабинске прошла летняя школа по искусственному интеллекту AIRI, я анонсировал её некоторое время назад. Отбор там был суровый, и, возможно, прошли не все, кто хотел, в том числе и среди тех, кто читает мой канал.

Но если вам было интересно, как прошла школа, приглашаю вас прочитать свежий хабр, написанный двумя её участниками, кстати говоря, физиком и биофизиком. Из текста можно узнать, как применять методы ИИ в смежных областях, а также зарядиться мотивацией к подаче заявки в следующем году.


Трансформеры, лежащие в основе LLM, создают текст токен за токеном (авторегрессионно). Но это не единственный путь.

Последние год-два (совсем недавно по меркам изобретения трансформеров) начал активно изучаться подход, где генерация токенов происходит параллельно — с помощью диффузии, той самой, которая рисует нам картинки и видео. Теоретически это даёт кратное ускорение, а также позволяет заполнять пропуски в тексте.

Сейчас уже прошло достаточно времени, чтобы порассуждать о работоспособности нового метода. Это сделали исследователи из AIRI вместе с коллегами из Sber AI, написав большой разбор на основе собственного опыта взаимодействия с dLLM. Этот текст на днях вышел в нашем блоге на Хабре.


В ИИ-мире сейчас только и говорят, что про агентов…
 
Когда LLM только появились, все поняли, что с их помощью можно решать массу вопросов в режиме «вопрос — ответ». Например, можно попросить написать какой-то код, попробовать выполнить его и, если возникнут ошибки, попросить исправить. Такой подход, напомню, называется вайбкодинг, я про него подробно рассказывал в большом материале.
 
Но довольно быстро люди поняли, что труд обращения к LLM тоже можно автоматизировать с помощью LLM. Так мир пришёл к идее автономных агентов, которые сами ставят себе подзадачи, пока не достигнут поставленной человеком цели.
 
Сегодня разработчики оптимизируют не только самих агентов, а но и обвязку их разными опциями, оркестрацию, циклы работы и всё такие прочее. А можно ли автоматизировать и саму эту оптимизацию?
 
Мой коллега по AIRI Антон Разжигаев ответил на этот вопрос утвердительно. Знакомьтесь, Уроборос — агент, который постоянно переписывает себя в автономном цикле эволюции. В отличие от прочих подобных проектов, которые в основном обрастают инструментами, он меняет собственное ядро.
 
Антон запустил Уробороса в феврале и рассказывал о его успехах у себя в канале. Сейчас же он доэволюционировал то состояния, в котором он бьёт Codex и Claude Code на нескольких важных бенчмарках. Вчера мы выпустили текст в нашем блоге на Хабре, где Антон подробно рассказывает историю создания и устройство своего агента. Хорошая новость, что агент открытый, и его может использовать любой желающий (при наличии ресурсов, конечно).


Сейчас будет небольшой LLM-ликбез.
 
При рассказе про очередную ИИ-модель я периодически упоминают такое понятие как длина контекстного окна или, проще, контекст. В общем и целом, под ним понимают общий бюджет промпта, который мы подаём на вход модели. В зависимости от модели это может быть не только текст, но и изображения, документы и иные типы данных.
 
Перед входом контекст токенизуется — разбивается на последовательность дискретных сущностей из словаря модели. Поэтому контекст принято измерять в токенах. Но это всё же некоторое, хоть и приемлемое в большинстве случаев упрощение.
 
Корректнее говорить, что контекст состоит из элементов последовательности, которые состоят из столбцов специальной матрицы, кодирующей представление токенов — эмбеддингов. В большинстве текстовых языковых моделей один эмбеддинг соответствует одному токену.
 
Мои коллеги по AIRI в прошлом году показали, что этот принцип можно нарушить — и закодировали в один эмбеддинг-вектор аж целых 1568 токенов. Результат впечатляющий, поскольку, в теории, позволяет оптимизировать контекст, хотя главным в той работе было всё же исследовать архитектурные пределы сжатия в LLM.
 
А совсем недавно коллеги из другой команды AIRI доказали, что при такой плотной упаковке теряется семантическая осмысленность, и объяснили этот механизм. Обо всём этом мы с ними на днях выпустили статью для нашего блога.


Сегодня пост на стыке физики, дифуров и ИИ (но не про контрпример к гипотезе якобиана, нет).
 
Те, кто читает меня достаточно долго, знают, что мне нравятся штуки под названием физически-информированные нейросети (Physics‑Informed Neural Networks или просто PINN). Если очень упрощать, это такие нейронки, которые при обучении тяготеют не только к тренировочным данным, но и к руками заданному физическому дифференциальному уравнению. С одной стороны, это позволяет обходиться меньшими датасетами и добиваться большей точности решения уравнения, чем голый data-driven подход. С другой — PINN считает сильно быстрее, чем FEM или FDTD, что для типовых рутинных расчётов очень хорошо.
 
PINN — это ярчайший пример подхода, известного как Science-Informed Machine Learning (сами переведёте), когда априорные знания о вашей науки формируют саму архитектуру модели. Но буквально кодировать уравнения — не единственный подход.
 
Те, кто имел удовольствие учить у себя на физмат-факультетах курсы вроде «Методы математической физики», знают, что, к примеру, уравнения колебания струны не обязательно решать в лоб дискретизацией. Ответ можно искать в виде разложения в ряд Фурье, сводя задачу к алгебраической проблеме.
 
Описанный выше приём — простейший пример спектрального подхода к решению дифференциальных уравнений в частных производных. В его рамках мы ищем решение в виде суммы некоторых базисных функций, вообще говоря, не обязательно гармонических. В 2024 вышла статья, где этот могучий метод адаптировали под научное информирование моделей. Так увидели свет SINN — спектрально информированные нейросети.
 
А вчера мы с Тянчи Ю, первым автором той статьи, а также младшим научным сотрудником в AIRI, выпустили для нашего блога на Хабре текст о том, как они с соавторами усовершенствовали SINN.


Две недели назад у меня вышел текст про нейродвижки, то есть модели, которые отрисовывают геймплей игры без обращения к её ресурсам, а лишь на базе обучения на многих часах видео. На момент написания материала существовала уже целая куча примеров таких моделей, что всех и не перечислить. А вот нейроигр с мультиплеером я тогда насчитал всего две.

Теперь же их число пополнила нейроверсия Rocket League, аркадной гоночной игра в жанре футбола, довольно популярная в своём сегменте. Работает на диффузионном трансформере, принимает на вход только управление и несколько кадров, правда, контекст модели всего 4 секунды — больше деталей в блоге исследователей. Примечательно, что к команде разработчиков присоединились сотрудники компании Epic Games, которая издаёт игру. Это говорит о том, что крупные игроки геймдева всё же держат руку на пульсе в истории с нейродвижками.

Ну и конечно, есть демка — играем с рандомами. Если есть желание попробовать, советую не тянуть. По опыту, приобретённому в ходе написания материала, могу сказать, что публично доступные демки долго "не живут".


Сегодня посчастливилось принять участие в научном семинаре «Нанооптика, фотоника и когерентная спектроскопия – 2026», который прошёл в Казанском физтехе. Семинар, фактически, является конференцией, с тезисами и индексируемым сборником. Доклад был устный, и на нём я изложил последние наработки нашей маленькой команды (теоретические) по поводу поиска следов электромагнитной массы электрона в фотонных кристаллах.

Подробнее о самой работе расскажу как-нибудь позднее, когда выйдет статья. Для меня сегодняшнее мероприятие важно тем, что это, оказывается, мой первый конференционный орал за довольно долгое время.

Я, вообще, со студенческих лет предпочитал устные доклады постерным, и делал их много и часто на самых разных конфах. Но с определённого момента я начал доверять доклады магистрантам и аспирантам нашей группы, а затем жизнь сделала поворот, и наука вовсе отошла на второй план. Так что нынешнее выступление можно назвать в некотором роде камбэком 💪


С момента, когда в 2024 году исследователи показали нейросеть, отрисовывающую DOOM без единого обращения к файлам с ресурсами игры, мне стало интересно, как будет развиваться эта технология. С тех пор я периодически рассказывал в канале о новостях из этой области, но долго не решался садиться за полноценный разбор, потому что тема действительно непростая.

И всё же это случилось, и текст вышел сегодня на N + 1. Из него вы узнаете, как устроены такие модели, какие игры успели воспроизвести на нейросетях и даже найдёте ссылки, чтобы поиграть самим (в том числе мультиплеер для игры с друзьями).


Недавно мы вместе с ведущим научным сотрудником AIRI Константином Ушениным выпустили на Хабре статью про победу его команды на хакатоне по созданию ИИ‑ассистента для планирования синтеза в лаборатории органической химии. В тексте много технических деталей, касающихся разработки, управления проектами и создания ИИ-систем, но цепляет он не этим.

Хакатон, если кто не знает, — это соревнование, в ходе которого командам нужно создать продукт (ну, или хотя бы прототип) в условиях жесточайшего дедлайна. При таких обстоятельствах недостаточно одних хард-скиллов, нужны ещё пресловутые «софты» и умение правильно взаимодействовать с сокомандниками.

История Константина очень похожа на фильмы про ограбления: сбор команды, трезвая оценка возможностей, планирование «на берегу». И, как это обычно бывает в таких сюжетах, по началу план работает хорошо, но ближе к кульминации начинаются проблемы — конфликты коммитов, перегрузки сервера и даже хакерская атака на проект за 15 минут до его защиты. Но в конечном итоге наши герои вышли победителями.

В общем, текст вышел очень остросюжетным и поучительным. Рекомендую к прочтению даже людям, далёким от разработки.


Бояться восстания машин от роботов в том виде, в котором они сегодня существуют, не стоит. Проблема не в том, что роботы не умеют стрелять или самостоятельно подзаряжать свои батареи. Проблема в их забывчивости.

Раскрою мысль. Сегодня на роль «мозгов» для разных робототехнических устройств стало модным брать так называемые VLA-модели (Vision‑Language‑Action), которые представляют собой архитектуру трансформер — да, ту самую, что в LLM. Это здорово работает, когда вся нужная информация для робота доступна прямо сейчас: объект виден, инструкция дана, и тот должен немедленно совершить действие.

Но в тот момент, когда нужная информация роботу больше не доступна (нужный предмет лежит в ящике, который сейчас закрыт, или цель объявили ранее), приходится полагаться память робота, которая в трансформерах живёт в контекстном окне: всё, что робот видел, слышал и чувствовал, должно быть упаковано туда. Трудность в том, что механизм внимания имеет квадратичную сложность по длине последовательности, а значит долгосрочная память для робота будет обходиться слишком дорого, если пытаться наивно увеличивать размер контекста.

Решить эту проблему могли бы новые архитектурные решения. Одно из них придумали и опубликовали мои коллеги из команды «Воплощенные агенты» AIRI. Подробнее о нём рассказывает свежая статья в институтском блоге на Хабре.


В фантастике нам часто показывают искусственный интеллект, сравнимый с человеческим, который расположен внутри робота или синтетического тела. Сам вопрос о создании такого типа интеллекта, похоже, разрешится в ближайшие годы. Но даже если он и будет возможен, то на текущем технологическом этапе размер датацентров для его обслуживания будет сопоставим с целым городом — в робота такое точно не засунуть.

Причина в том, что нужный эффект достигается главным образом за счёт масштабирования размеров моделей и количества данных. Но ведь веса — это, по сути, упакованная информация, если угодно, эрудированность и энциклопедичность. Интеллект же чаще проявляется в способности рассуждать и анализировать. А что, если попытаться сохранить умственные навыки модели без балласта в виде ненужных знаний? В конце концов, необходимую информацию можно подавать ситуативно в контекст.

Рассуждая таким образом, мои коллеги из AIRI создали семейство компактных языковых моделей под названием Optimal Cognitive Core (OCC) — SLM в противовес LLM. Пока они решали только задачу контекстных ответов на вопросы. При размере 0.6 и 1.7 млрд параметров, соответственно, OCC-модели отвечают на равных или лучше моделей общего назначения, которые в 2–6 раз больше, а по верности контексту показывают лучший результат среди моделей до 32 млрд. Сегодня про эту разработку вышла статья у нас на Хабре.

Конечно, это пока не общий интеллект, скорее proof-of-concept того, что компактная модель может работать так же, а то и лучше своих эрудированных собратьев. В перспективе этот подход сможет существенно снизить требования по железу к сильному ИИ, включая пресловутую проблему с энергией.

Показано 20 последних публикаций.