HighLoad++


Kanal geosi va tili: Rossiya, Ruscha


Официальный канал крупнейшей конференции по инженерии больших и сложных систем
HighLoad++ 2026 пройдет 30 ноября и 1 декабря в Москве: https://highload.ru/moscow/2026
Общаемся в чатике https://t.me/HighLoadTalks

Bog‘liq kanallar  |  O‘xshash kanallar
Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Бывает, когда проще начать заново 😁

🥲 — да, было
👍 — пока всё норм
🗿 — в репозиторий не пускаю

#хроникиITбудней


Одного сгенерированного кода мало. Агенту нужно передать контекст под конкретную задачу, результат проверить, а затраты — посчитать. При работе с существующим продуктом добавляется ещё один вопрос: как использовать AI, не создавая новое легаси и не теряя качество?

На HighLoad++ 2026 со всем этим будем разбираться в направлении «AI в SDLC». В программе уже есть доклады про устройство Software Factory, inner и outer harness, управление контекстом, переход к AI-first-разработке, экономику внедрения, тесты, code review, evals и границы делегирования агентам.

Будем говорить не только о том, что получилось, но и о том, что ломалось при масштабировании, где ошибались агенты и что командам пришлось менять.

Программа ещё формируется, принятая часть на сайте ⬅️


Одной модели недостаточно, когда агент должен не просто отвечать, а выполнять действия. Нужны инструменты, доступы, проверка результата и ограничения. При использовании AI-агентов и ассистентов возникает ещё одна задача — сохранить контроль над корпоративными данными.

Как построить рабочую инфраструктуру, собрать GraphRAG на одной GPU и безопасно использовать AI-инструменты в разработке?

С этими задачами приходите на доклады:

→ Маверик: 100 000 обращений за 2 месяца — как построить агентную платформу, которая доводит 90% задач до результата без человека. Виталий Лукин (X5 Tech).
Доклад поможет спроектировать путь агента от запроса до проверенного действия: разбить задачу на шаги, подключить инструменты, определить операции, требующие подтверждения человека, и не превращать каждую новую интеграцию в отдельный проект.

→ Harness важнее модели: как собрать GraphRAG на одной GPU и, главное, зачем? Иван Бондаренко (НГУ).
Иван разберёт, как роль harness меняет подход к проектированию GraphRAG и почему выбор модели — не единственное решение, от которого зависит результат.

→ Как не проливать данные компании при использовании ИИ или «Почему Василиск скорее всего будет недоволен безопасниками?» Андрей Романовский (Яндекс).
Тем, кто внедряет AI-инструменты в разработку, Андрей покажет, как повышать её эффективность, не допуская утечки корпоративных данных.

Ждем вас 30 ноября и 1 декабря в Москве на HighLoad++ 2026 🖐️

Программа ещё формируется, посмотреть принятую часть можно на сайте


Как масштабировать Git-инфраструктуру, разгрузить память Kubernetes-узлов и построить потоковую платформу поверх объектного хранилища?

В новом дайджесте к свежим материалам за последние семь дней добавили записи докладов HighLoad++ 2025. Сравните подходы GitHub и Cloudflare с продакшен-кейсами GitLab и Kafka, а Node Swap — с тем, как память на самом деле ведёт себя на уровне Linux и JVM.

Почитать:

🔴Building Git infrastructure for agent-scale development.
GitHub объясняет, почему рост числа коммитов, push-операций и запусков CI требует новой архитектуры хранения репозиториев. Внутри — ограничения текущей схемы с пятью репликами, разделение compute и storage и результаты внутренних тестов: до 35 раз больше пропускной способности на запись.

🔴Announcing Cloudflare K2: serverless event streams.
Архитектурный разбор K2 — бессерверного журнала событий, построенного поверх объектного хранилища R2. Cloudflare рассказывает, как реализовала партиционирование, порядок сообщений и независимое масштабирование хранения и вычислений, а также разбирает ограничения подхода и отличия от очередей и Kafka.

🔴Scaling Kubernetes Workloads with Node Swap.
Бенчмарк Node Swap с NVMe-дисками для CI-сборок, изолированных Python-сред и браузерных sandbox-контейнеров. Авторы показывают, когда swap позволяет разместить на узле до трёх раз больше ворклоадов без заметного роста задержки, а где начинается падение производительности.

Посмотреть:

🔴От одного контейнера до 4000 RPS: как мы масштабировали GitLab в трех дата-центрах. Максим Степанов.
Кейс масштабирования GitLab: переход к распределённой установке, миграция хранения и бэкапов в S3, вынос очередей, Kubernetes, балансировка VCS и разделение нагрузки между Redis/Valkey-кластерами.

🔴Эволюция Kafka as a Service: от факапа до чилаута. Анастасия Цепелева.
Опыт перехода от одной большой Kafka к отдельным кластерам как сервису. В докладе — GitOps, Strimzi, автоматические обновления без простоя, пресеты конфигураций и middleware для упрощения авторизации.

🔴Beyond the OOM: Decoding Java Memory Behavior. Михаил Поливаха.
Практический разбор потребления памяти Java-приложениями. Почему NMT, VisualVM, JConsole и метрики ОС могут показывать разные результаты, как связаны физическая память, RSS/PSS, COW, cgroups и пулы JVM и где искать причину проблем с памятью в продакшене.

Кидайте подборку в «сохранённое», чтобы потом не grep’ать историю чата, и пересылайте коллегам — пригодится, когда очередное узкое место всплывёт уже в проде 🙌


Фрагментированный мир: как сохранять стабильную работу систем при внешних ограничениях.

Блокировки, нестабильную связность и ограничения на внешние сервисы приходится учитывать при проектировании и эксплуатации систем. На HighLoad++ 2026 этому посвящено отдельное направление программы — «Фрагментированный мир».

Сегодня рассказываем о трёх докладах из этого направления.

✔️ ALD Pro: мы и правда можем заменить MS AD или еще нет? Лев Николаев (Техническая академия Росатома).
Увидите, как ALD Pro работает в продуктивной среде, чем отличается от Active Directory и FreeIPA и где могут возникнуть сложности при переходе. Спикер также покажет многоуровневый стек для делегации прав, сценарии отказов и отказоустойчивую схему для клиентов.

✔️ На чем возможно построить мощную ИИ-инфраструктуру: ПАК vs не ПАК (самосбор). Антон Юдин (Группа Rubytech (Скала^р)).
Поймёте, можно ли строить ПАК на китайских GPU, сопоставима ли их производительность с Nvidia и можно ли использовать их для расширения существующей инфраструктуры. Отдельно — централизованное управление GPU и сравнение экономики ПАК и облака.

✔️ Комплаенс как системный анализ: как формулировать требования по 152-ФЗ, ФСТЭК и КИИ, чтобы их можно было реализовать в highload-системе. Татьяна Маркина (ТризТех (PT)).
На трёх практических примерах разберёте, как переводить требования 152-ФЗ, ФСТЭК и КИИ в метрики, критерии приёмки и зоны ответственности команд. В кейсах — локализация данных, требования к логам LLM и согласия на использование данных для обучения моделей.

Приходите, если сейчас решаете, чем заменить MS AD, на каких GPU строить ИИ-инфраструктуру или как перевести требования регуляторов в конкретные технические критерии.

📍30 ноября и 1 декабря, Москва, Кампус СКОЛКОВО, и онлайн.

✅ Программа ещё формируется, посмотреть принятую часть программы и выбрать формат участия можно на сайте


Что сейчас для вас важнее: понять пределы PostgreSQL под нагрузкой, посчитать экономику AI-инструментов или разобраться, как безопасно выпускать агентов в прод?

На HighLoad++ 2026 выбирать всё равно придётся: докладов много, а оказаться одновременно в нескольких залах пока невозможно 😉 Поэтому мы опубликовали предварительное расписание.

✏️ Уже можно отметить нужные разборы и собрать свой маршрут на 30 ноября и 1 декабря.

➡️ Смотрите расписание на сайте.
Пока планируйте карандашом — программа ещё формируется, поэтому возможны изменения.


Онтико dan repost
Какой способ использования агентов вы предпочитаете?
So‘rovnoma
  •   Инженерный, совместное проектирование всех процессов и шагов
  •   AI-Native, описание цели и способа проверки её достижения
49 ta ovoz


Онтико dan repost
А вот, кстати, реально серьезный вопрос о том, как решать сложные задачи с помощью агентов. Допустим, надо проанализировать миллион переписок в сотне чатов.

Вариант 1, я его называю "Инженерный", через архитектуру и процессы. Я проектирую конвейер моделей, понимая каждый этап обработки, проектируя систему хранения каждого этапа. В результате я уверен в выводах анализа, потому что понимаю каждый шаг алгоритма обработки данных.

Вариант 2, я его назвал бы "AI Native", через eval'ы. Я описываю источник данных, требуемый результат и способы проверки. Потом отпускаю модель добиваться нужного результата самостоятельно до тех пор, пока все проверки не проходят.

Вы как работаете?


Принесли вам пять свежих материалов. Здесь про оптимизацию сети, потоковые данные, ML-инфраструктуру, защищённый инференс и надёжность Kubernetes 🙌

1️⃣ We’re making Tailscale faster.
Инженерный разбор оптимизаций data plane Tailscale: меньше копирований пакетов, более короткие очереди и параллельная обработка. Изменение работы с буферами само по себе дало около 5% ускорения во многих конфигурациях.

2️⃣ Deduplicating Streams with Flink SQL.
Практический разбор дедупликации во Flink SQL. Автор сравнивает подходы по работе с состоянием, опоздавшим событиям, задержке и детерминированности и объясняет, когда Process Table Function предсказуемее сложного SQL-запроса.

3️⃣ Taming the ML Firehose: Scaling Feature Consistency.
Production-кейс Uber о согласованности признаков между обучением и инференсом при нагрузке до 8 млн предсказаний в секунду. Внутри — архитектура пайплайна, масштабирование Flink и результаты: объём сообщений сократился в 4–5 раз, пиковое отставание обработки — примерно на 70%.

4️⃣ Enabling Private High-Performance Production AI Inference with NVIDIA Confidential Computing.
Технический бенчмарк confidential computing на восьми GPU B200 и разбор узких мест. Система сохранила 96,1–98,2% исходной пропускной способности, а время генерации токена выросло на 1,2–4,3%.

5️⃣ Spotlight on SIG Apps.
Интервью с председателями SIG Apps о развитии workload-контроллеров Kubernetes. В фокусе — сбои узлов, надёжность базовых контроллеров и согласованный перезапуск распределённых задач через JobSet и LeaderWorkerSet.

Во всех пяти случаях результат зависит от конкретных решений: как обрабатывать пакет, хранить состояние, ограничивать нагрузку и восстанавливаться после сбоя.


AI в SDLC: как работают агенты и что меняется в разработке.

Внедрение AI в разработку важно оценивать не по факту подключения инструмента, а по изменениям в процессе, скорости, качестве и стоимости. На HighLoad++ 2026 обсудим, как агенты меняют разработку — от устройства инструментов до архитектуры, процессов и контроля результата.

Сегодня рассказываем о трёх докладах направления программы «AI в SDLC». В каждом своя практическая задача.

✔️ Пишем полноценную игру с новым CodeSpeak. Леша Гладков (независимый эксперт, ex-Head of Mobile в Леруа Мерлен).
Доклад поможет понять, как CodeSpeak работает с нестандартной задачей — разработкой игры, которая отличается от привычной прикладной разработки архитектурой и подходами.

✔️ Найти, изменить и доказать: как внутри устроены кодовые агенты. Дмитрий Антипов (Группа Сбер / VSRobotics).
Вы разберётесь, как агенты ищут и проверяют код, как LLM влияет на классический поиск и почему экономика KV-cache определяет архитектуру.

✔️ Вайбкодинг в облаке: API, документация и деплой под агента, а не под человека. Александр Сербул (Битрикс24).
На докладе вы разберётесь, как определить границы применимости enterprise-вайбкодинга, спроектировать высоконагруженную архитектуру и обеспечить прослеживаемость и качество результата.

Приходите, чтобы задать спикерам вопросы, сверить их опыт со своим и понять, что из услышанного можно применить в работе.

📍30 ноября и 1 декабря, Москва, Кампус СКОЛКОВО, и онлайн

✅ Посмотреть принятую часть программы и выбрать формат участия можно на сайте


Новый выпуск Podcast++ про то, как AI меняет разработку целиком, а не только ускоряет написание кода: что происходит с SDLC, когда нейросети становятся частью инженерного процесса.

🎤 Ведущий: Кирилл Россохин, CIO ВсеИнструменты.ру.

🖐 В гостях: Александр Поломодов, Technical Director & Fellow, AI4SDLC Advocate.

Обсудили: где AI уже реально дает эффект в разработке, почему одних копайлотов недостаточно, как меняются процессы и роли внутри команды и что нужно, чтобы перейти от отдельных AI-инструментов к системному AI4SDLC.

Этот выпуск будет полезен CTO, техлидам, engineering managers и всем, кто сейчас пытается понять, как встроить AI в разработку не ради эксперимента, а как рабочий инженерный процесс.

🎧 Слушать подкаст:
ВКонтакте
Яндекс Музыка
mave


🚀 Ищем волонтёров на AI Native Conf и AI Cases Conf

Хотите увидеть закулисье наших конференций, получить опыт организации мероприятий и стать частью профессионального сообщества? Присоединяйтесь к команде волонтёров!

Вас ждут: классная команда, понятные задачи и поддержка координаторов, доступ к контенту конференций, общение с экспертами и профессионалами из крупнейших IT-компаний, горячее питание в дни работы и, конечно, памятные подарки 🎁

Задачи: работа в залах, помощь с логистикой на площадке, регистрация участников и помощь в зоне выставки.

➡️ Отправить заявку на участие


Если у вас растёт нагрузка, база приближается к пределам, AI входит в процесс разработки или меняются требования к безопасности и эксплуатации — в программе HighLoad++ 2026 уже есть разборы таких задач. Вы сможете сравнить подходы команд и понять, какие ограничения и затраты важно учесть в своём контексте.

До 30 сентября билет можно купить по текущей цене и сэкономить 6000 руб. 1 октября стоимость вырастет в последний раз и станет максимальной.

✅ Изучите принятую часть программы и забронируйте билет на сайте

*Программа ещё формируется, это не финал


Онтико dan repost
Доброе утро!

По результатам моего последнего опроса большинство считает, что нам нужен ещё год-два на исследование AI-агентов, потом ситуация устаканится. Второй по популярности ответ - всё уже устаканилось. Моё личное мнение - общество (и нас) будет колбасить ещё пару десятилетий :)

IT-сообщество продолжает исследование AI-агентов как феномена. Прямо звезда в этом процессе - встреча Алексея Федорова и Андрея Морозова с философом Павлом Щелиным, на мой взгляд - смотреть обязательно любому, кто хочет осмысленно участвовать в процессе изменения мира.

Продолжение на втором дне Joker Conf (вообще сама идея сделать второй день Java-конференции посвященным философским аспектам того, как ИИ меняет профессию разработчика - смелая и правильная).

Наш вклад - доклад Олега Бартунова, основателя PostgreSQL Pro, о архитектуре данных в эпоху AI.

Что такое данные? Я предлагаю смотреть на них как на различия, зафиксированные наблюдателем в некотором контексте.

На протяжении истории мы учились всё лучше сохранять и передавать такие различия. Письменность отделила мысль от человека, измерения — наблюдение от наблюдателя, компьютеры превратили данные в формальные структуры. При этом часть исходного контекста неизбежно терялась, и каждое следующее поколение технологий пыталось его вернуть: появились типы, схемы, связи, описания, история происхождения данных.

Искусственный интеллект — следующий этап этой эволюции. Машина уже не только хранит и обрабатывает данные, но начинает их интерпретировать, сопоставлять и использовать для принятия решений.

В докладе я попробую проследить эту цепочку — от первых способов фиксации наблюдений до современных систем с ИИ — и понять, какими должны стать данные и архитектура их хранения на следующем этапе.


Конференция AI Native Conf, 20 октября, Москва, https://ainativeconf.ru/


Упал сервис:

#хроникиITбудней


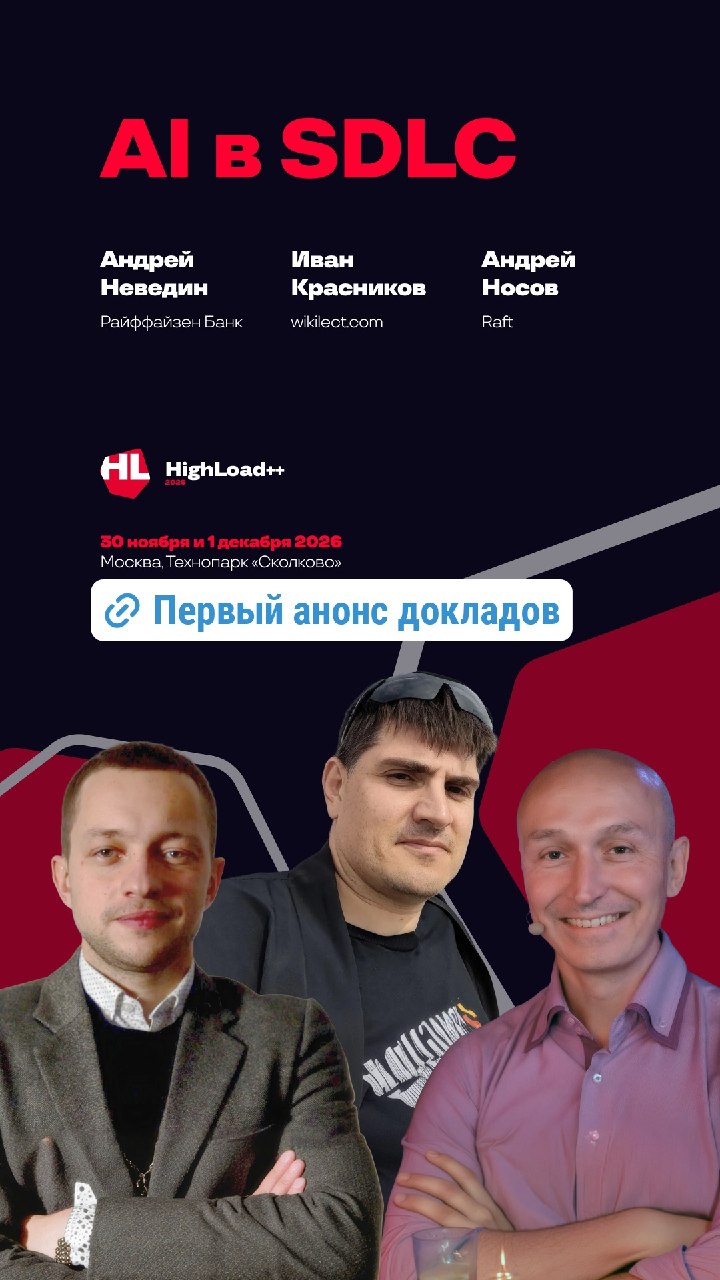
Начинаем подробно рассказывать о программе HighLoad++ 2026 🙌

Сегодня три доклада из направления программы — AI в SDLC. Задачи, решение которых вы найдёте в этой тематике: как перестроить процесс разработки после внедрения AI, наладить проверку результата и оценить изменения в скорости, качестве и стоимости.

✔️ Self-Improving Software Factory: от AI-агентов к автономному SDLC. Андрей Неведин (Райффайзен Банк).
При переходе от отдельных coding agents к Software Factory приходите разобрать её архитектуру: модель, inner/outer harness и orchestration/control plane, а также verification и feedback loops для контроля качества результата и улучшения фабрики.

✔️ Свой «Claude Cowork» внутри контура компании — как мы прикрутили OpenCode к GitLab и получили универсального внутрикорпоративного агента для самых разных задач. Иван Красников (wikilect.com).
Для корпоративного агента в закрытом контуре Иван разберёт реализованное on-premise-решение на OpenCode и GitLab: разграничение доступа, изолированные среды, контроль расходов и аналитику использования документов в RAG.

✔️ Харнес, который написал сам себя: SDLC highload-проекта на 100 агентов. Андрей Носов (Raft).
Масштабирование харнеса от одного человека до команды из пяти и сотни параллельных агентов требует новых правил. Андрей разберёт версионирование agent.md, Red/Green Zone, права MCP, резервирование ресурсов и проверку согласованности правил.

Для команд, которые переходят от отдельных AI-инструментов к системной работе с агентами, эти доклады дадут конкретные ориентиры для архитектурных и процессных решений.

Программа ещё формируется, принятую часть можете посмотреть на сайте


AI в разработке: как довести эксперименты до работающего продукта

Сгенерировать код стало проще. Но кто проверит, что он решает задачу? Как подключить агента к существующей инфраструктуре? Что произойдёт, если пользователь начнёт управлять им через prompt injection?

20 октября на AI Native Conf разберём, как команды используют AI в разработке и продуктах, какие решения принимают и с какими ограничениями сталкиваются.

Вот несколько задач, с которыми стоит прийти:

→ Сохранить качество кода при переходе на AI-разработку.
Максим Лапшин из Erlyvideo расскажет, как компания с 17-летней историей за три месяца перешла на AI-first разработку и какие методики использует, чтобы получать работающий продукт. Подробнее о докладе.

→ Встроить LLM-агента в существующую систему.
Никита Зеленский из APEX Games разберёт подключение агента к инфраструктуре данных, галлюцинации в аналитике, выбор между MCP и прямыми API-вызовами, а также стоимость работы агента. Подробнее о докладе.

→ Понять, где агент может заменить привычный интерфейс.
Артем Самойлов из Сбера покажет, как заменил GUI работающего сервиса чатом на OpenClaw, сохранив бэкенд. Обсудим, что это меняет в разработке новых сценариев и какие риски prompt injection появляются. Подробнее о докладе.

Если вы уже пробуете AI в рабочих задачах, приходите сопоставить свой опыт с решениями других инженеров и обсудить, что применимо в вашем проекте.

📍 20 октября 2026 · Москва, кластер «Ломоносов», и онлайн

Посмотреть программу и выбрать формат участия


Каких компромиссов потребует новое решение?

Выбирая архитектуру, базу или AI-инструмент, важно понять, где решение упрётся в нагрузку, сколько будет стоить в эксплуатации и что произойдёт при отказе. На HighLoad++ 2026 будем разбирать всё это на реальных примерах.

В программу уже принято 35 докладов об архитектуре, базах, AI в SDLC, агентных платформах, безопасности и эксплуатации. И ещё один формат — деловая игра про жизненный цикл создания ИИ-агента. В этой игре участники станут командами-разработчиками и в ходе тендера заказчика будут искать слабые места, генерировать тесты, разбирать ошибки и оценивать риски.

Но и это ещё не всё 😉

Нашли задачи, с которыми работаете? Изучите программу подробнее и забронируйте билет на сайте ⬅️

⚡До 30 сентября действует текущая цена. 1 октября она вырастет в последний раз и станет максимальной.


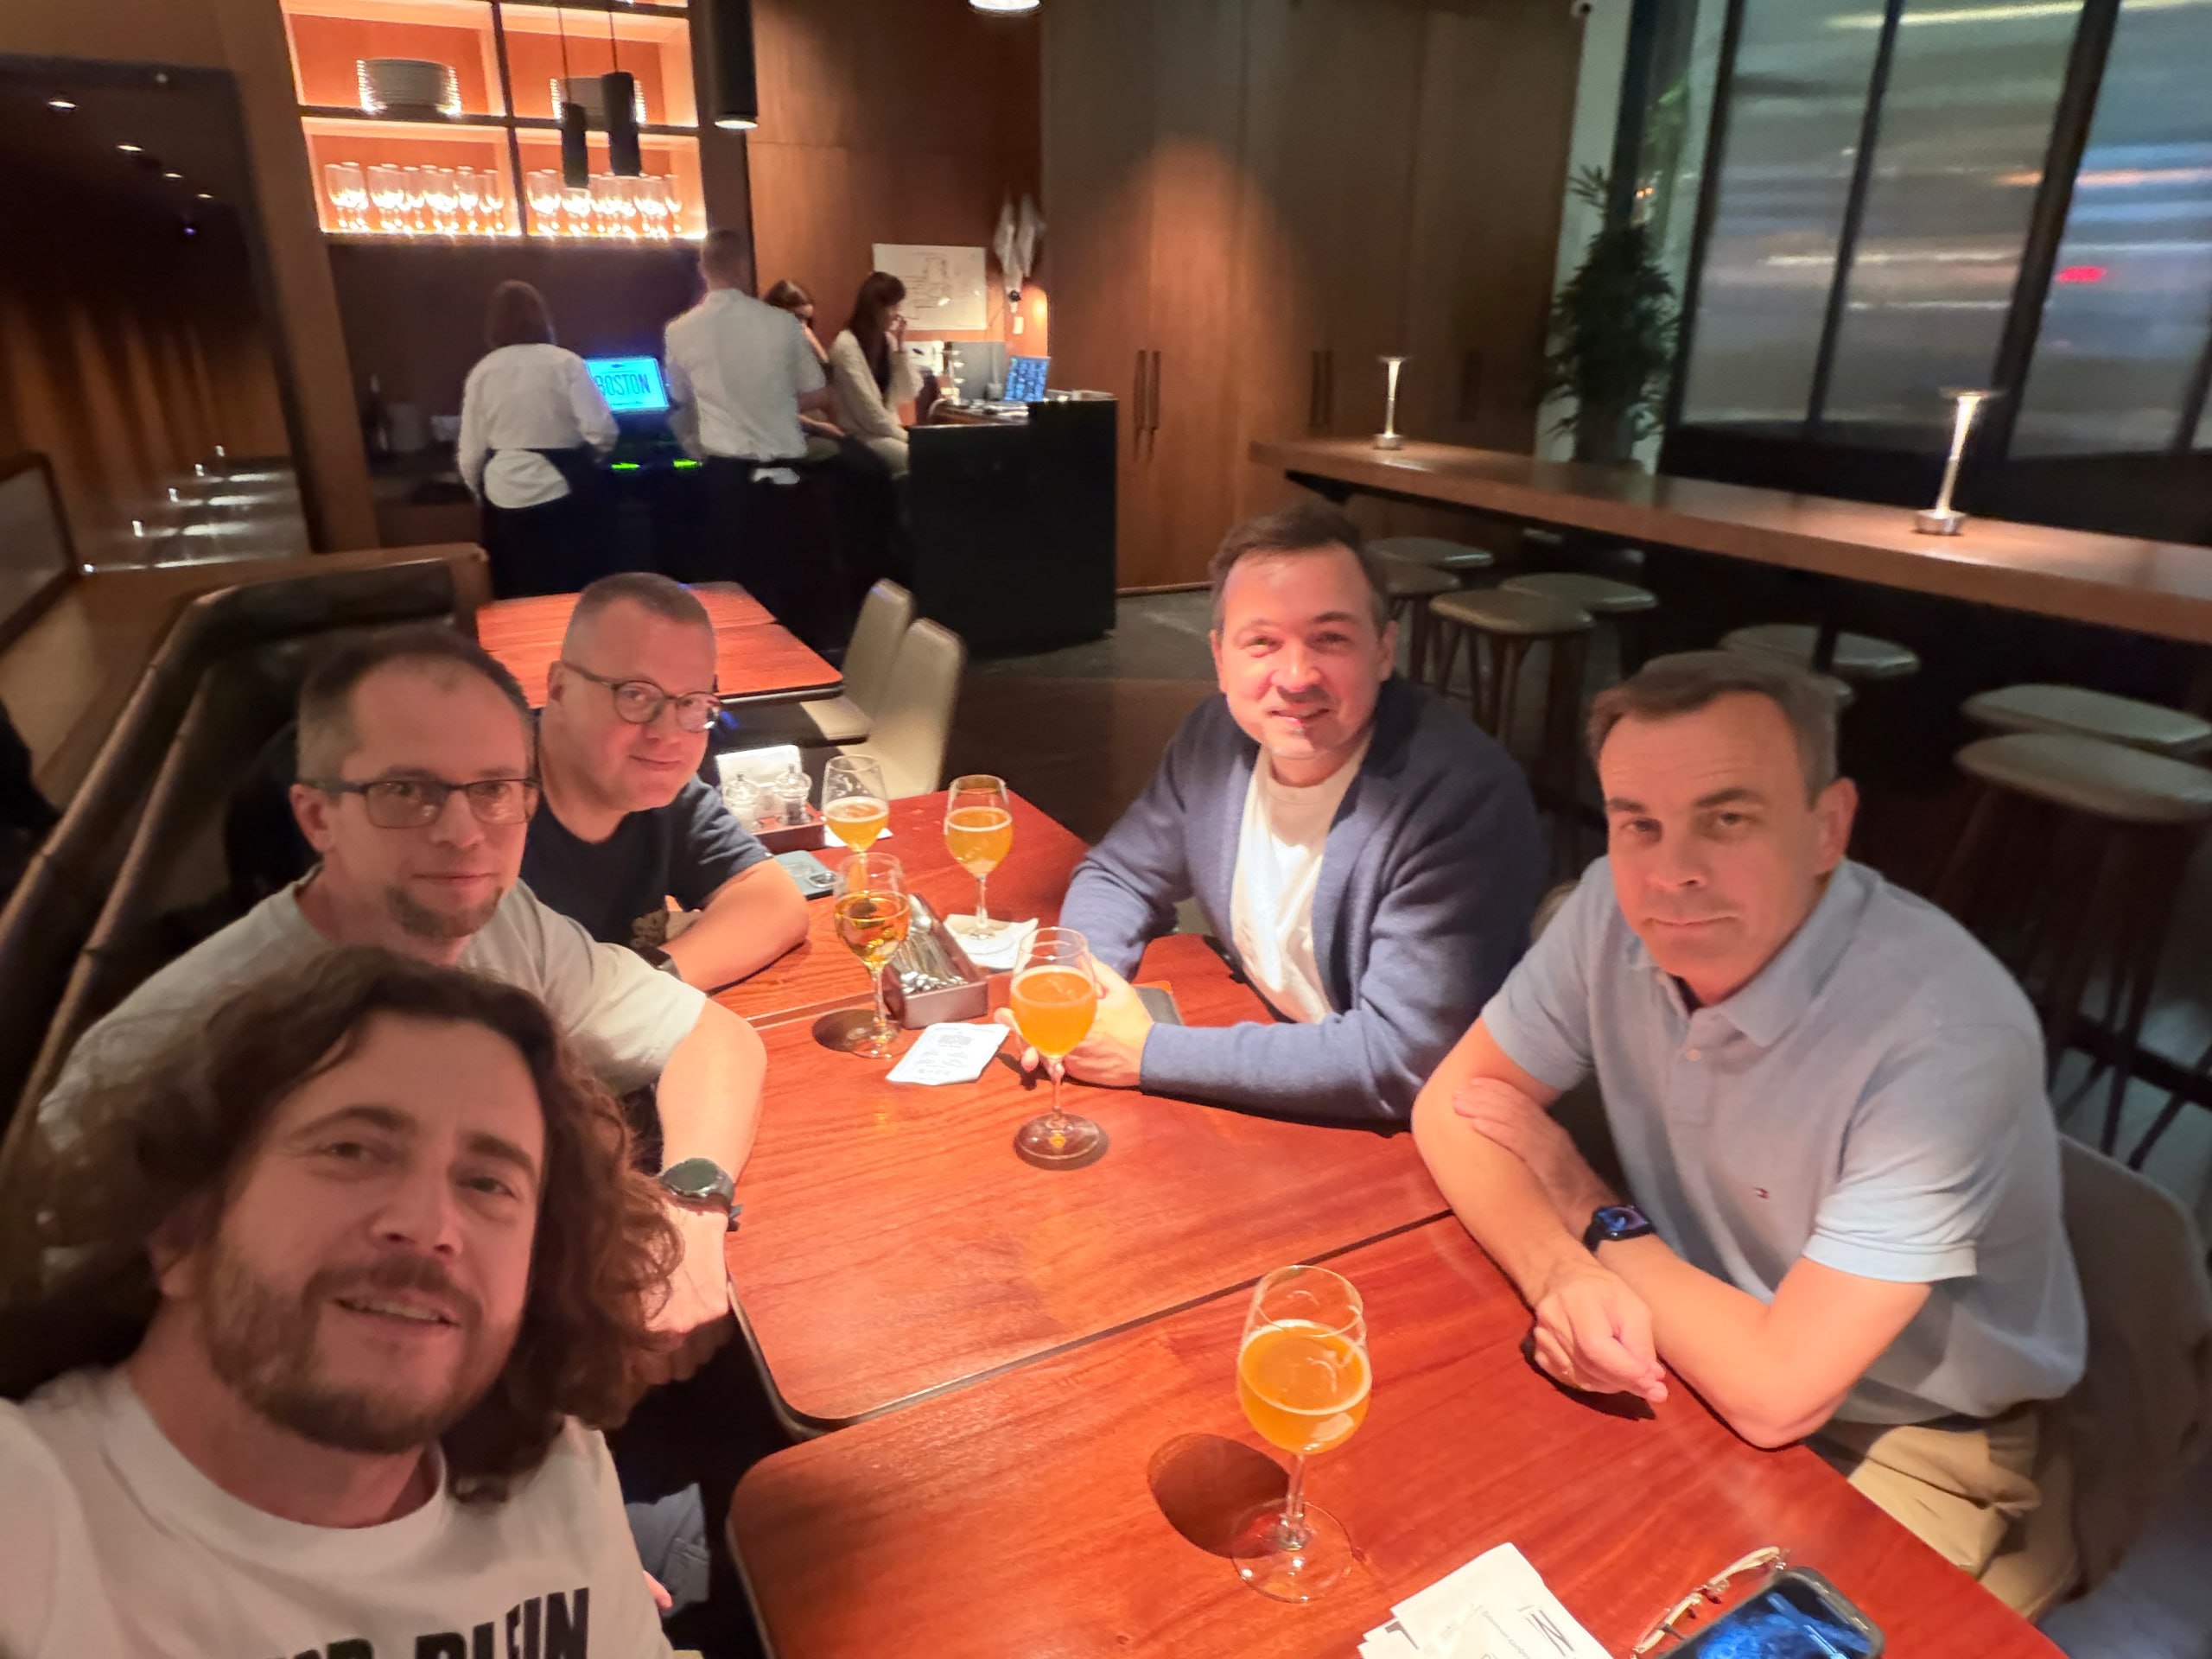
Тусовка, всем привет от Игоря Сысоева!

Вы же знаете, кто это такой, а фронтенд это не только JavaScript с вёрсткой? :)

Встречались вчера одним из первых составов ПК HighLoad++ периода бурного роста.

Это примерно когда у первого айтишника возникла мысль "А не плохо бы смузи!", DevRel'ы ещё не знали, что они DevRel'ы. На HL++ стояли стенды Facebook, Google и Oracle, а Брюс Момжан был завсегдатаем конференции и мы с ним пили водку в Бочке.

В общем, в прошлой жизни.

Все выросли в IT-предпринимателей, у одного даже получилось :) Разговоры скачут с цепей Маркова на организацию продаж.

У Фишера продюсерский центр по обучению highload, Макс прогоняет через себя половину телевидения в стране, Костя пишет (пишет ему теперь Клод) продает СУБД Пикодата, а я торгую билетиками.

Вот только Игорь ничего не продает, может себе позволить.

А ведь были же нормальными людьми разработчиками!

Куда-то пропали с моих радаров из того состава только Слоник_в_домене и Постгресмен. Ну и некому раз в год приносить программу HighLoad++ на проверку (я приносил её старшим товарищам, Илье Сегаловичу и Володе Габриеляну).

—
Олег Бунин

20 ta oxirgi post ko‘rsatilgan.