NSS Lab News


Kanal geosi va tili: Rossiya, Ruscha


Новостной канал лаборатории NSS Lab, Институт ИИ ИТМО.
https://itmo-nss-team.github.io/
"Ничего не понятно, но очень интересно"

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Про нас упоминают - говорят, создаем крепкую базу.

>Ученые и преподаватели, создающие фундаментальную базу и кадровый резерв
https://www.vedomosti.ru/partner/articles/2026/10/06/1234391-uchenie-prepodavateli

Но вообще в тексте неточность - в 2026 мы представили куда больше фреймворков)

Конкретно на FEDOT MAS можно посмотреть тут.


ITMO Staff Support dan repost
ИИ меняет то, как студенты выполняют задания, а значит, и подходы к оцениванию должны меняться тоже ❤️

Серия еженедельных встреч «Открытые практики оценивания с ИИ» поможет коллегам делиться своим опытом: удачными решениями, сложностями и ошибками. Тема очередной встречи: OSA.Edu — инструмент для комплексного анализа студенческих работ

08 октября, 11:00, онлайн 
→ Регистрация

OSA.Edu сопоставляет текст дипломной работы и программный код проекта и помогает находить расхождения между описанной и реализованной функциональностью. Андрей Гетманов, руководитель проекта, аспирант и младший научный сотрудник Института ИИ ИТМО, расскажет, какие задачи инструмент может решать, как он будет влиять на подготовку и защиту и где останутся границы ответственности


! особенно ждем тех, кто скептически относится к необходимости менять привычные подходы, — такая позиция критически важна для объективности разговора

#be_pro
💋 Мы в ВК


Базальт СПО | Операционные системы «Альт» dan repost
Началась первая часть трансляции второго дня XXII конференции разработчиков свободных программ!

Главные темы на сегодня:

🔶 Git-reveal: демонстрационные презентации на базе git-репозиториев

🔶 PAUK: карта научного кода ИТМО, собранная из открытых данных

🔶 GNOME по-нашему, несколько историй об организации сообщества ALT Gnome

🔶 Интеграция нейросетевых технологий с программами экранного доступа

🔶 Возможности интеграции ИИ-инструментов в Linux-системы

Полная программа доступна по ссылке

Присоединяйтесь к трансляции:

📹 Сайт
📹 VK Видео
📹 RuTube
📹 YouTube


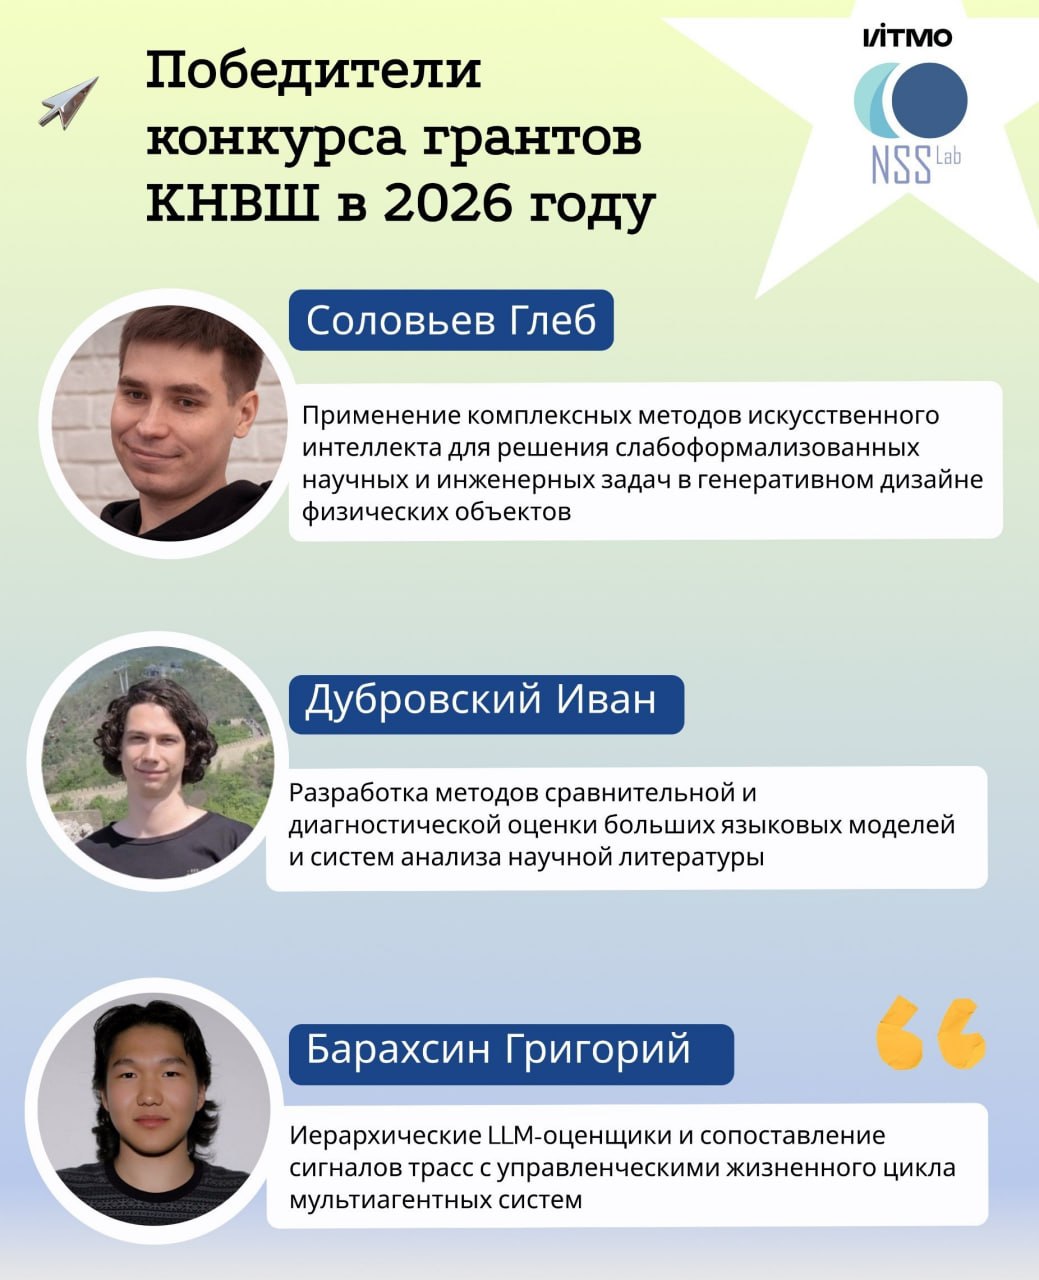
Поздравляем победителей конкурса грантов для студентов и аспирантов КНВШ в 2026 году!

Из 140 победителей из университета ИТМО трое - сотрудники нашей лаборатории:

Соловьев Глеб Витальевич (аспирант ФТИИ 3-го курса, сейчас выходит на защиту)
Проект: «Применение комплексных методов искусственного интеллекта для решения слабоформализованных научных и инженерных задач в генеративном дизайне физических объектов».

Дубровский Иван Сергеевич (аспирант ФТИИ 2-го курса)

Проект: «Разработка методов сравнительной и диагностической оценки больших языковых моделей и систем анализа научной литературы».

Барахсин Григорий Михайлович (магистрант, сейчас - аспирант ФТИИ 1-го курса)
Проект: «Иерархические LLM‑оценщики и сопоставление сигналов трасс с управленческими аспектами жизненного цикла мультиагентных систем».

Тем кто подавался, но не прошел - удачи в следующем году)


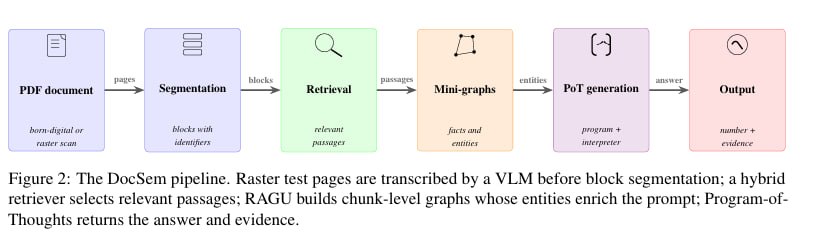
Наше сотрудничество с меж-университетской командой RAGU тоже продолжается - на archival-воркшоп DocInsights 2026 принята совместная с Иваном Бондаренко из НГУ статья When Harness Beats Scale, and When Reading Beats Both (пока выложили как препринт). Написана по мотивам участия Ивана в соревновании DocSem.

Статья будет представлена на EMNLP вместо с основной статьёй про RAGU, принятой на EMNLP Demo.

Следующая статья цикла уже рецензируется на ICLR, ко второй части соревнования тоже попробуем подступиться.


ИИ Песочница Sber AI Lab dan repost
🔥10 октября в Москве — конференция «ИИ: Наука в действии»

Sber AI Lab и Университет ИТМО собирают исследователей, инженеров и лидеров индустрии, чтобы обсудить переход от передового AI-ресерча к реальным продуктам.


🔆В программе:
🔘11 докладов от топовых исследователей из Сбера, ИТМО, МФТИ, Сколтеха, AIRI и T-Bank.
🔘Панельная дискуссия «От науки к бизнес-внедрению» с участием профессоров и топ-менеджеров ведущих AI-центров.
🔘Международный keynote спикер.

🔆Ключевые темы:
🔘Фабрики LLM-агентов, управление знаниями и мультиагентные системы для автоматизации исследований и разработки.
🔘Эффективный инференс, сжатие MoE-моделей и оптимизация контекста в RAG-системах.
🔘Надежность и оценка LLM: детекция галлюцинаций, доверие к моделям и LLM-as-Judge.
🔘Обработка банковских данных и внедрение ИИ-решений.

Зачем быть очно?
☑️Разобрать практический опыт внедрения
☑️Задать вопросы авторам исследований напрямую
☑️Нетворкинг с командами Sber AI Lab


📍Москва, Офис Сбера
📆10 октября, 11:00–18:00

➡️Программа и регистрация по ссылке!

✈@sb_ai_lab


Делаем вместе с коллегами из Sber AI Lab конференцию в Москве - welcome всем желающим! Будут доклады от NSS Lab.


На днях вышла новая журнальная статья - в IEEE Geoscience and Remote Sensing Letters (Q1).

Deep Learning for Super-Resolution of Sea Ice Concentration: Case Study of OSISAF Down-Scaler
Авторы: Юлия Борисова, Дмитрий Морозов, Дмитрий Гилемханов, Николай Никитин

Помимо уже знакомых подписчикам имен сотрудников NSS Lab, свою первую статью выпустил Дмитрий - студент бакалавриата ИИИ ИТМО и участник учебно-научной лаборатории AIST.

Это расширенная версия работы с воркшопа Machine Learning for Remote Sensing на ICLR 2026. Задача здесь практическая: как получить детальные карты концентрации морского льда, если исторические спутниковые данные доступны только в относительно низком разрешении?

В качестве исходных данных используется продукт OSI SAF с пространственным разрешением около 25 км. При этом существует более детальный продукт MASAM2 с разрешением около 4 км, в котором данные дополнительно уточняются с использованием нескольких источников. Проблема в том, что такая детальная информация доступна далеко не для всей исторической ретроспективы.
Идея работы - научить нейросеть восстанавливать MASAM2-подобные поля из одного только OSI SAF. То есть несколько источников данных нужны во время обучения, а после обучения модели достаточно только грубого поля концентрации льда. В результате этот подход потенциально позволяет получить более детальное представление исторических данных, для которых MASAM2 ещё не существовал.

Что получилось:

Super-resolution. Модель увеличивает пространственное разрешение примерно с 25 до 4 км и при этом не просто «растягивает» картинку, а восстанавливает более реалистичную геометрию ледовой кромки. У Light U-Net MAE составляет 0.010 и SSIM — 0.961. Для сравнения, у билинейной интерполяции MAE — 0.071, а SSIM — 0.879.

Простая архитектура. Помимо облегчённого U-Net мы проверили Attention U-Net. Добавление attention-механизмов практически не улучшило качество: обе модели дают MAE около 0.010 и SSIM около 0.961. Поэтому в данном случае более сложная архитектура не окупается. Аналогично сравнение было выполнено и с архитектурой conditional diffusion (аналогично, она не дает улучшения в качестве).

Применимость для исторических данных. Метод, который напрямую использует дополнительные контуры льда MASIE, лучше работает по части метрик ледовой кромки. Но ему эти дополнительные данные нужны непосредственно при построении каждого поля. Нейросети после обучения достаточно только OSI SAF - и именно это делает подход интересным для восстановления длинных исторических рядов.

В итоге задача здесь немного шире классического super-resolution: мы пытаемся перенести информацию из более богатого многосенсорного продукта в модель так, чтобы затем использовать её для улучшения данных, где доступен только один источник.

Код: https://github.com/ITMO-NSS-team/GRSL_masam2_downscaling


Корень из ИТМО dan repost
ТОЧНОФинал_ВКР_после правок научника_v17.1.docx

Знакомо? Админу тоже 😞

В идеальном мире код и его описание в работе совпадают. Но на защите может выясниться, что одна функция переехала в другой модуль, другая осталась только в черновиках, а третья работает, но о ней не написано в тексте.

С проблемой сталкиваются не только студенты, но и разработчики по всему миру. В ИТМО для ее решения создали новый инструмент для проверки дипломных работ по ИТ-направлениям OSA.Edu. Он сравнивает, что написано в пояснительной записке, с тем, что на самом деле делает программа.

🥸 Система работает как редактор: помогает студенту исправить работу до того, как ее увидит комиссия.

Разработку уже апробировали на 80 выпускных работах магистрантов факультета технологий искусственного интеллекта ИТМО. В ближайших планах — тестирование на кандидатских диссертациях.

Подробнее об OSA.Edu и о том, как инструмент для ученых помог решить проблемы студентов, — в статье 👈

#разработки

😵 Парковка ИТМО


В канале ИТМО пишут про нашу разработку - спин-офф Осы: https://github.com/ITMO-NSS-team/osa.edu

Основные авторы от лаборатории - Андрей Гетманов, Илья Соколов, Даниил Ежов и Егор Фёдоров (студент ФТИИ и участник учебно-научной лаборатории AIST).


ФТИИ ИТМО dan repost


Выступил на днях с приглашенным докладом на летней школе по ИИ в SMBU (университете, организованном МГУ и Пекинским Политехом в городе Шэньчжэне).

Рассказал про современное состояние ИИ-мультиагентов и наши свежие результаты (например, про принятые недавно на EMNLP Industrial и Demo три статьи от NSS Lab). Вопросов было много и по делу, видно что тема для всех очень актуальная.

Для желающих подробностей: детальное описание мероприятия запостил в своем канале также выступавший на школе Дмитрий Ватолин (МГУ).


Работа магистрантов ФТИИ Ивана Кирпичева и Эльдара Курманалиева (под руководством Анны Калюжной) под названием "Towards Ontology-Driven Multi-Hop Benchmark for Corporate GraphRAG Systems" успешно представлена в Бремене - на тематическом archival-воркшопе А*-конференции IJCAI.

Cтатья посвящена созданию основанного на корпоративной онтологии бенчмарку для GraphRAG-систем, проверяющему их способность отвечать на сложные многошаговые вопросы из финансовой сферы. Он включается 4000 провалидированных экспертами пар вопрос-ответ, разделенных на 4 категории, а также массив сырых данных.

Статью приняли сразу на устный и постерный формат.

Cсылка для цитирования:

@ inproceedings{kirpichev2026towards,
title={Towards Ontology-Driven Multi-Hop Benchmark for Corporate GraphRAG Systems},
author={Kirpichev, Ivan and Kurmanaliev, Eldar and Bushmelev, Fedor and Abramov, Maxim and Korepanova, Anastasiia and Kalyuzhnaya, Anna and Nikitin, Nikolay},
booktitle={Joint Workshop on Generative AI and Knowledge Graphs and Knowledge Graphs Agentic Systems Interplay},
year={2026}
}


Мини-игра "найди на фотографии аспиранта ФТИИ и м.н.с. NSS Lab Андрея Гетманова, принявшего участие в Школе AIRI 2026, прошедшей недавно в Усть-Лабинске".

В ходе школы Андрей реализовал проект "Continual learning in audio deep fake detection":

Проект посвящён разработке системы непрерывного обучения для обнаружения аудиодипфейков. Современные детекторы быстро теряют актуальность по мере появления новых моделей синтеза и преобразования голоса, а обычное дообучение на новых типах атак может ухудшать качество распознавания уже известных дипфейков. Цель проекта - создать подход, который позволит модели последовательно адаптироваться к новым генераторам и доменам без катастрофического забывания ранее изученных атак. Итогом исследования должен стать воспроизводимый бенчмарк и улучшенный метод детекции, способный сохранять качество на старых атаках и эффективно осваивать новые.

По результатам готовится А*-статья.


ФТИИ ИТМО dan repost
🎓 Работы выпускников. Как научить ИИ генерировать README для проектов с открытым кодом

У открытого репозитория без README не разобраться — это его описание и точка входа. Но писать и поддерживать его руками долго, поэтому README часто устаревает или его нет вовсе.

Захар Попов, выпускник магистратуры ФТИИ по программе «Искусственный интеллект в промышленности», в дипломной работе собрал конвейер, который генерирует README автоматически — для репозиториев на GitHub, GitLab, GitVerse и SourceCraft. Научный руководитель — Николай Никитин.

Это не отдельный скрипт, а модуль проекта OSA — открытой разработки лаборатории АИСТ. Внутри — мультиагентная система с циклом самооценки: она не просто генерирует README, а сама проверяет и улучшает результат.

Чем работа сильна:
🔹 README собирается в один клик — не нужно вручную писать и обновлять документацию;
🔹 Захар в команде OSA с самого зарождения проекта: за два года видел, как тот растёт — новые возможности, конференции, статьи;
🔹 больше всего в работе ему было ценно проектировать архитектуру вместе с командой и доводить первые прототипы до рабочего результата.

Работу Захара отдельно отметила государственная экзаменационная комиссия.

Где это пригодится: всюду, где у проекта с открытым кодом должен быть понятный README, но писать его руками некогда.

Что дальше — Захар продолжит развивать OSA в составе команды.

Репозиторий с кодом: https://github.com/aimclub/OSA

#работы_выпускников


На обратном пути с ICML нанёс визит в Harbin Institute of Technology (это в Китае) - в ходе него поучаствовал в нескольких семинарах, на которых рассказал о наших свежих результатах и текущих проектах, в которых можно поучаствовать.

Договорились c профессорами и студентами из School of Computer Science and Technology о научном сотрудничестве по нескольких направлениям (AutoML, LLM-агенты, AI4Science) - надеюсь всё получится.

Бонусом фото из их кампуса - почти как в Академгородке.


Научный опенсорс dan repost
RAGU - на HuggingFace!

Сегодня мы выложили на HuggingFace препринт про открытый GraphRAG-фреймворк RAGU.

RAGU - это модульный GraphRAG-движок, который превращает сырой текст в граф знаний: извлекает сущности и связи, строит и чистит граф, а затем ищет ответы через локальные, глобальные или гибридные стратегии.

Этот проект сейчас разрабатывается совместно Лабораторией прикладных цифровых технологий НГУ (Иван Бондаренко) и Лабораторией автоматизированного мульти-агентного ИИ ИТМО (Николай Никитин). В разработке активно участвуют студенты обоих университетов.

В комплект фреймворка входит также новая компактная модель Meno-Lite-0.1 на 7B параметров (первое место на SemEval-2026 Task 8 MTRAG). В препринте, (сейчас он на рецензии на одной из A*-конференций), мы показали, что для построения качественного графа знаний не обязательно задействовать большие модели: наш 7B-экстрактор показывает результат лучше, чем Qwen2.5-32B на построении графов. Также, фреймворк недавно ставил одним из победителей конкурса Yandex Open Source.

Если говорить о конкретных цифрах:
RAGU достает до 84% релевантного контекста в медицинских бенчмарках (у конкурентов ≤76%). Мы обходим HippoRAG 2 на креативных задачах (59.0 против 56.9). При этом стоимость обработки — $0.001 за документ в сравнии с $0.10 у API-решений.

Как пользоваться RAGU:
Ставится одной командой pip install graph_ragu, работает на обычной потребительской видеокарте. Код открыт (MIT), веса — Apache 2.0.

Как поддержать:

Если разработка заинтересовала, то ее можно поддержать в Daily Papers на Huggingface, поставив upvote тут: https://huggingface.co/papers/2607.11683

Также, будет рады звездочкам на репозиторий: https://github.com/RaguTeam/RAGU

Если есть вопросы - пишите в комментариях или в Issues на GitHub.

P.S. Если хотите посмотреть, как всё работает:
- 2 минуты: базовая настройка и первый запуск
- 11 минут: глубокое погружение в конфигурации пайплайна


А теперь новости с другого конца света: c 13 по 17 июля в Коста-Рике проходит GECCO — крупнейшая международная конференция по эволюционным вычислениям (организатор - ACM SIGEVO, ранг CORE - A).

Факультет технологий ИИ ИТМО и NSS Lab на конференции представляет недавний выпускник программы "ИИ в промышленности" Вадим Ахмеров, с исследованием «Evolving Multi-Agent Systems with Large Language Models: Surrogate Fitness Limitations and Empirical Insights», на archival-воркшопе Large Language Models for and with Evolutionary Computation. Эта статья стала основой успешно защищенной ВКР.

Cреди со-авторов - студенты и аспиранты ФТИИ, коллеги из Sber AI Lab и Satbayev University. Также, от учебно-лаборатории АИСТ в исследовании участвовал студент бакалавриата ФТИИ Егор Рождественский.

О чем статья: мы используем LLM, чтобы оптимизировать мультиагентные системы эволюционным методом: модели сами предлагают улучшения и сами же оценивают результат. Оказалось, что успех критически зависит от того, насколько хорош LLM-оценщик, в статье анализируем применимость и ограничения этого подхода.

Текст статью опубликуют чуть позже - а пока поздравляем Вадима с первым очным докладом на топовой международной конференции!

Upd: а во и статья - https://dl.acm.org/doi/10.1145/3795101.3814705


Sber AI dan repost

20 ta oxirgi post ko‘rsatilgan.