Научный опенсорс


Kanal geosi va tili: Rossiya, Ruscha


Канал сообщества ITMO OpenSource, посвященного созданию и использованию наукоёмких open-source проектов, в том числе в области AI/ML.
Чат: https://t.me/itmo_opensource
По всем вопросам - @nicl_nno

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Data Secrets dan repost
Ученый из Гарварда придумал, как искать задачи специально под ИИ

Мэтью Шварц, который ранее за две недели написал с Claude полноценную работу по теоретической физике, продолжил эксперимент. На этот раз он решил не заставлять модель работать как ученого, а искать научные задачи, которые хорошо подходят под сильные стороны современных LLM.

Он называет их Claude-shaped problems. Идея в том, что в разных областях науки постоянно встречаются очень похожие математические конструкции, но ученые из одной области могут просто не знать, что нужный метод уже давно существует в другой. А LLM как раз очень хорошо умеют находить такие связи между огромным количеством разрозненной литературы.

Под это Шварц вместе с Claude собрал BootLoops, набор инструментов для точных математических вычислений. Изначально он создавался для теоретической физики, но затем Claude начал находить практически те же задачи в экологии, генетике, экономике, лингвистике и других областях.

Например, в экологии модель нашла уравнение из теории биоразнообразия, которое около 20 лет не умели эффективно считать на больших данных, и решила его методами из математической физики. А в популяционной генетике Claude нашел способ точно вычислить интеграл, который около 30 лет приходилось оценивать приближенно. Это позволило исследователям проверить модель рекомбинации ДНК на огромном массиве генетических данных и обнаружить следы генной конверсии, которые раньше было сложно выделить.

Но тут обнаружилась важная проблема. Claude довольно хорошо находил технически правильные результаты и очень плохо понимал, насколько они вообще интересны для конкретной науки. Шварц несколько раз приносил такие находки профильным специалистам и получал примерно один ответ: технически впечатляет, научно не очень интересно.

Поэтому дальше схема работы стала другой. Claude ищет связи между областями, пишет код, считает и перебирает гипотезы, а профильный ученый определяет, какой вопрос действительно стоит задавать. Так из первоначально неинтересного результата по экологии вместе с экспертом сделали новую модель динамики лесов, а из расчета по генетике пришли к анализу миллиардов пар мутаций.

Шварц считает, что именно здесь современные модели уже могут заметно ускорять науку. Огромный пласт научных задач можно решить не новым методом, а переносом уже существующего метода из другой области.

https://www.anthropic.com/research/claude-shaped-science


ИИ Песочница Sber AI Lab dan repost
🔥10 октября в Москве — конференция «ИИ: Наука в действии»

Sber AI Lab и Университет ИТМО собирают исследователей, инженеров и лидеров индустрии, чтобы обсудить переход от передового AI-ресерча к реальным продуктам.


🔆В программе:
🔘11 докладов от топовых исследователей из Сбера, ИТМО, МФТИ, Сколтеха, AIRI и T-Bank.
🔘Панельная дискуссия «От науки к бизнес-внедрению» с участием профессоров и топ-менеджеров ведущих AI-центров.
🔘Международный keynote спикер.

🔆Ключевые темы:
🔘Фабрики LLM-агентов, управление знаниями и мультиагентные системы для автоматизации исследований и разработки.
🔘Эффективный инференс, сжатие MoE-моделей и оптимизация контекста в RAG-системах.
🔘Надежность и оценка LLM: детекция галлюцинаций, доверие к моделям и LLM-as-Judge.
🔘Обработка банковских данных и внедрение ИИ-решений.

Зачем быть очно?
☑️Разобрать практический опыт внедрения
☑️Задать вопросы авторам исследований напрямую
☑️Нетворкинг с командами Sber AI Lab


📍Москва, Офис Сбера
📆10 октября, 11:00–18:00

➡️Программа и регистрация по ссылке!

✈@sb_ai_lab


Делаем вместе с коллегами из Sber AI Lab конференцию в Москве - всех приглашаю! Расскажу про нашу агентную науку и реализующий её опенсорс.


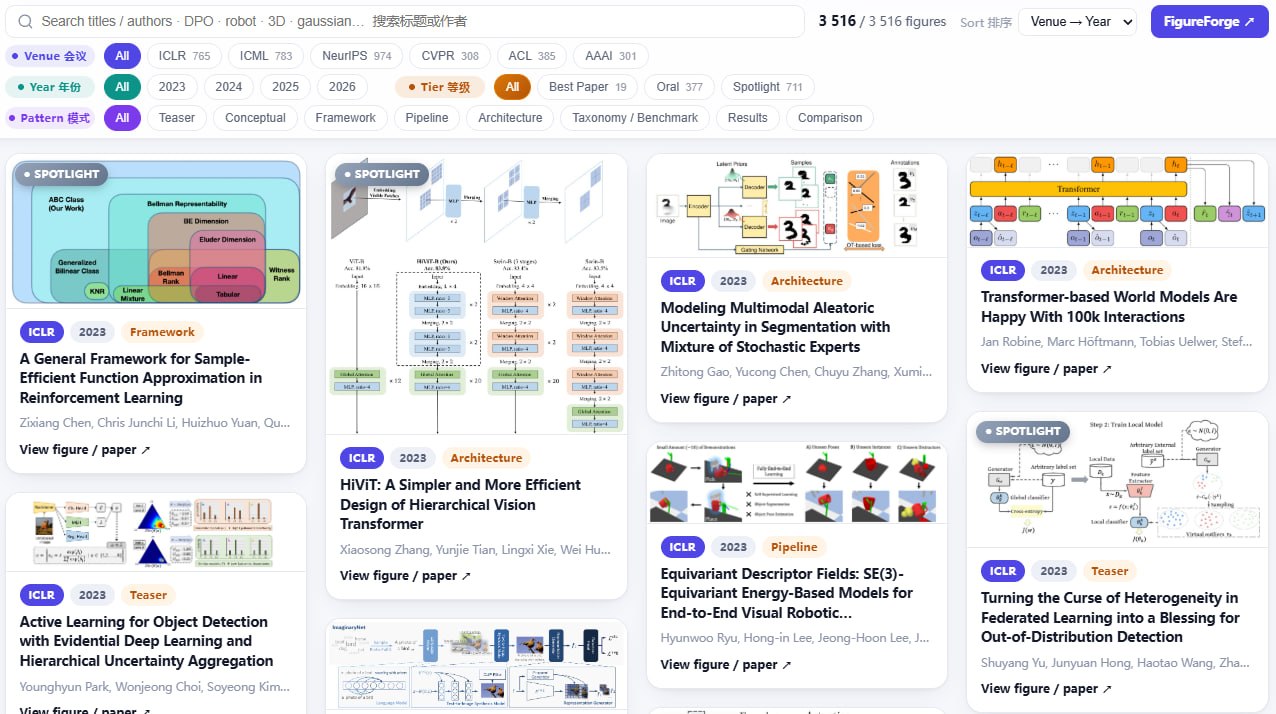
Китайские авторы сделали открытый датасет иллюстраций из топ-статей по AI/ML:

https://github.com/qwdwqfwq/topconf-paper-figure-gallery

https://qwdwqfwq.github.io/topconf-paper-figure-gallery/

Развиваем художественный вкус, получается.


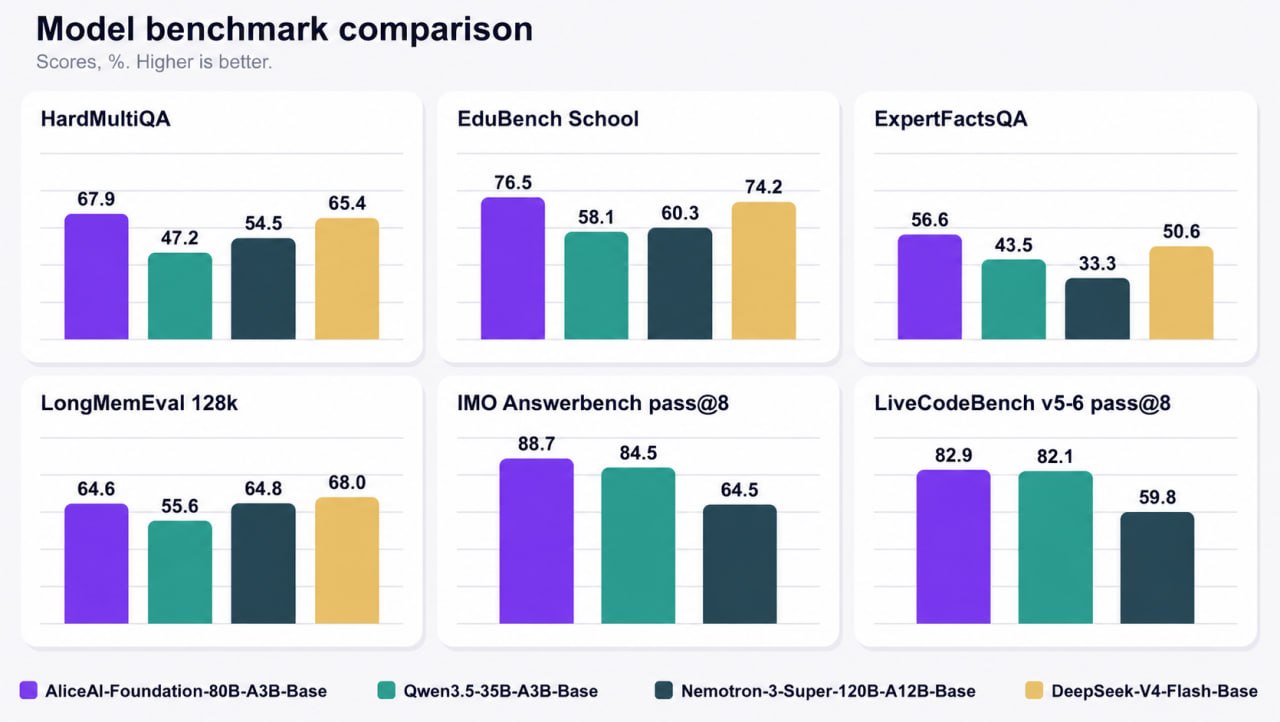
И ещё один опенсорс-релиз от Яндекса - Alice AI Foundation 80B LLM.

AliceAI-Foundation-80B-A3B-Base – базовая языковая модель с гибридной архитектурой и MoE-слоями. Модель содержит 80 млрд параметров, из которых для каждого токена активируются 3 млрд, и поддерживает контекст длиной до 262 144 токенов. Модель была обучена полностью с нуля.

При создании модели мы заново собрали обучающий корпус, выбрали архитектуру и гиперпараметры, а также подготовили данные для сложных рассуждений и взаимодействия с инструментами.


Пост авторов: https://t.me/MLunderhood/427
HF: https://huggingface.co/yandex/AliceAI-Foundation-80B-A3B-Base
Техрепорт: https://habr.com/ru/companies/yandex/articles/1083300/

Лицензия - Апач 2.0.


ODS Events dan repost
Привет!

Рады сообщить, что 🦜 ODS совместно с Международным университетом информационных технологий запустили соревнование по написанию кода ИИ-агентами - SWE MERA Challenge.

Соревнование пройдет в три этапа:
✅ на первом этапе участникам с помощью любых агентов предстоит решить представленные задания на своей стороне;
✅ на последующих этапах то же самое нужно будет делать уже в изолированном окружении.

⭐️Для Топ-3 участников будет дана возможность представить свою работу на конференции по программной инженерии ICSE 2027!

Присоединяйтесь к соревнованию по 🔗ссылке!


Закулисье МатМодельера dan repost
Кажется, у меня случился тот самый момент, когда проект перестаёт быть папкой на ноутбуке.

BiomechPy 1.1.0 опубликован.

Теперь его действительно можно установить одной командой:
pip install biomechpy

BiomechPy — это Python-библиотека для механики мягких биологических тканей, роста и ремоделирования, constituent turnover и constrained-mixture моделей.

И самое важное для меня здесь даже не сам факт публикации.
Перед релизом библиотека прошла тот уровень проверки, который я давно хотела видеть у собственных вычислительных проектов: тесты, научные инварианты, независимый аудит, сравнение NumPy и DOLFINx, реальные MPI-запуски на 1/2/4 процессах, проверку wheel и source distribution в чистых окружениях.
То есть в какой-то момент это перестало быть:
«у меня вроде работает».
И стало:
«вот постановка, вот эталон, вот независимые проверки, вот воспроизводимый результат».

Для математического моделирования эта разница, пожалуй, важнее количества написанных строк кода.

Пока BiomechPy не пытается быть «библиотекой вообще обо всём». В текущей версии ядро — это конечные деформации, волоконно-армированная механика, рост и ремоделирование, turnover составляющих ткани, когортная память и пространственные constrained-mixture модели.

Дальше хочется двигаться уже к экспериментальным данным, калибровке и обратным задачам.

Но сегодня можно просто зафиксировать:
первая стабильная публичная версия — есть.
GitHub: https://github.com/karinaurazova/biomechpy
PyPI: https://pypi.org/project/biomechpy/

И да. Теперь фраза «я написала библиотеку» звучит чуть менее подозрительно, потому что её хотя бы можно поставить через pip.

#матмоделирование #биомеханика #mechanobiology #python #opensource #BiomechPy #ЗакулисьеМатМодельера


Попался ещё один предметный открытый проект, на этот раз из области биомеханики:


Завершим рабочую неделю подборкой опенсорс-релизов разного рода:

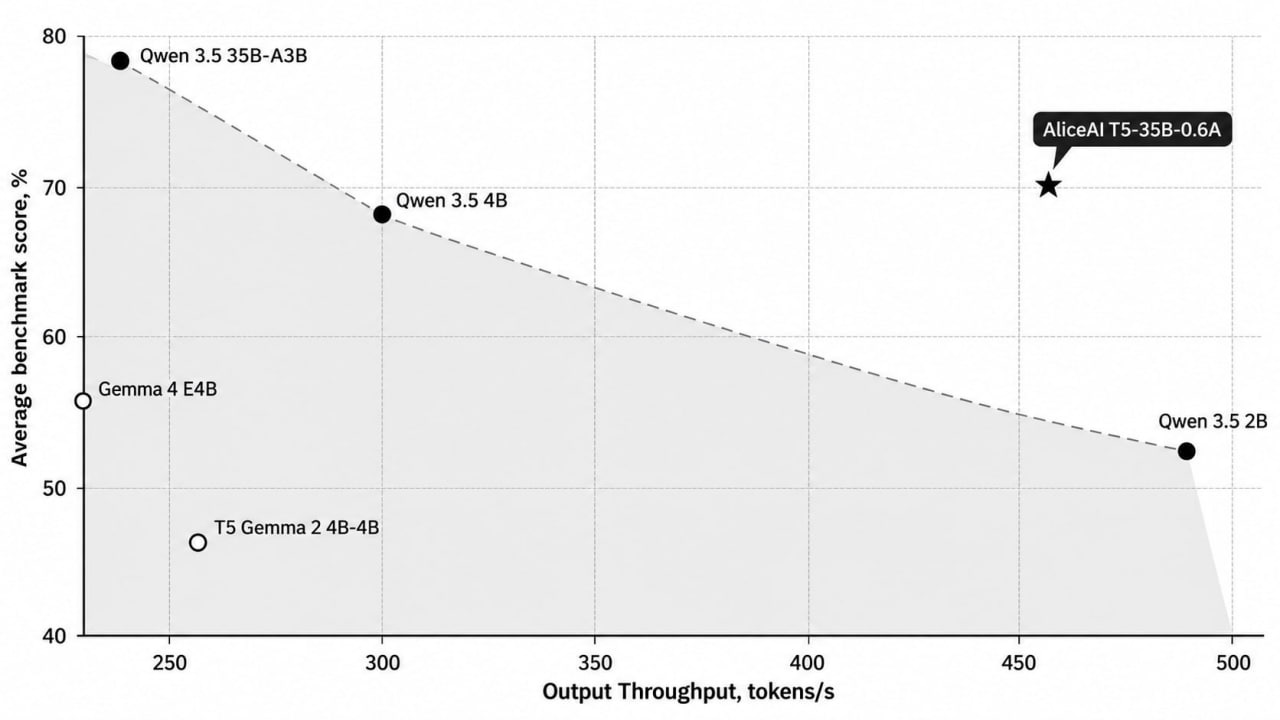
1) Как уже обсудили в чате, Яндекс выкатил Alice AI‑T5-35B‑A0.6B.
Модель обучена с нуля, в онлайн-эксперименте винрейт 56% против Google AI Overview.

На картинке - фронт Парето для моделей схожих весовых категорий.

Веса - https://huggingface.co/yandex/AliceAI-T5-35B-A0.6B
Техпрепорт - https://habr.com/ru/companies/yandex/articles/1080654

2) Сбер в свою очередь выкатил GigaChat 3.5 Reasoning - первую в России открытая модель с рассуждениями. В основе - архитектура 432B-A28B MoE.

- Хабр: статья
- Hugging Face: fp8 | bf16
- GitVerse: репозиторий

3) Нашумевшая оцифровка мухи-дроздофилы.

Мемы
про использование этого мозга видели наверное многие, а вот репо c туториалом по использованию данных вряд ли - https://github.com/sjcabs/fly_connectome_data_tutorial

На картинке соответственно муха и её мозг со 140 тыс параметров нейронов.

Вообще считаю это хорошим примером того, как потенциал научного опенсорса и агентов сочетается. Статья без открытых данных так и осталась бы интересной только узким специалистам. Вручную делать все эти примеры использования тоже вряд ли бы кто-то стал. А так околонаучный вайбкодинг позволяет проверять даже самые забавные гипотезы очень быстро.

4) Отчет Antropic "Detecting and countering misuse of AI: September 2026", где рассказывается множество интересных историй о том, как люди со всего мира используют Claude разными необычными способами. Наиболее пугающие из них как раз околонаучные (про "engineering highly pathogenic mammal-adapted avian influenza")...

Но даже для более здоровых применений важно помнить, что провайдеры LLM вам не друзья (математики из недавней истории про Навье-Стокса не дадут соврать), и для многих чувствительных задач локальные модели подходят лучше.
Иначе можно увидеть свои запросы заопенсоршенными в очередном отчете. На приложенной картинке - мем с реддита, а не настоящий отчет, если что)


Зоопарк из слоновой кости dan repost
#зоопарк_одобряет #дорогая_редакция

Автоматический генератор Supplementary Information для статей!

Нам пишут:

Привет! Я Данила, занимаюсь органической химией и сделал Auto Support Generator — программу, которая помогает избавиться от ручной сборки Supporting Information (SI).
Она собирает готовый SI в Word из таблицы соединений, экспериментальных данных и исходных спектров: переносит структуры из ChemDraw, обрабатывает ЯМР через MestReNova и оформляет всё под выбранный журнал. Ещё помогает заметить возможные несоответствия в ЯМР и HRMS. Готовый документ можно быстро править, переоформлять под другой журнал и дополнять новыми соединениями, не собирая всё заново.
Сам генератор полностью бесплатный, исходный код доступен на GitHub. Хочется поделиться им с другими химиками-органиками, которым он может облегчить работу, и получить обратную связь — что удобно, а чего пока не хватает.

https://github.com/danilalebedev/Auto_support_generator/tree/Auto_support_generator_beta.1.1


Пишут про узкотематический научный опенсорс-инструмент для органической химии.
С одной стороны, выглядит весьма полезно для авторов, статей, надеюсь пригодится кому-то из подписчиков.

Но с другой - хоть сам код и открыт, но какой-то конкретной лицензии не заявлено. А на такой случай позиция гитхаба:

"You're under no obligation to choose a license. However, without a license, the default copyright laws apply, meaning that you retain all rights to your source code and no one may reproduce, distribute, or create derivative works from your work".

Upd: автор лицензию докинул.


mipt-npm.news dan repost
Открытый семинар: «Образование после ChatGPT: опенсорс-курс на Физтехе и план развития на 2026–2028»

В среду, 16 сентября, в 15:30 состоится совместный семинар Учебно-научного центра гуманитарных и социальных наук и Центра научного программирования МФТИ.

Докладчик — Антон Костин, доцент УНЦ ГСН МФТИ, автор опенсорс-курса «Анализ данных в научной литературе».

О чём поговорим:

- почему нейросети обесценили домашние задания и как превратить курс в настоящий опенсорс-проект;
- что показал первый запуск: слушатели пишут код, размечают датасеты и чинят формы вместе с преподавателем;
- четыре курса 2026/27 на Физтехе, ИИ-сокурсник botai и стандарт качества курсов OCA, Open-Course Advisor, OSA для образования;
- планы развития опенсорс-образования на Физтехе и за его пределами — и что нужно проекту от научного сообщества и индустриальных партнеров.

Участие свободное, офлайн и онлайн.

Дата: среда 16 сентября
Время: 15:30 - 18:30
Место: МФТИ, поточная ауд. Арктики
Трансляция: доступна
по ссылке

До встречи на семинаре!


Про открытый курс Антона Костина (МФТИ) мы уже упоминали - а теперь коллеги из Центра научного программирования МФТИ проводят семинар с его участием.

Обсудят и нашу разработку OSA (которую недавно расширили на учебные задачи в формате отдельного инструмента OSA Edu - скоро про это расскажем).


Небольшой кейс не-кодового образательного опенсорса от коллег:

В конце июля в ИТМО проводили ДПО для преподавателей образовательных программ топ-уровня в сфере искусственного интеллекта (проект Минцифры России при участии АНО «Аналитический центр при Правительстве Российской Федерации").

Участвовали 331 преподаватель из 19 российских вузов - они учились применять компетентностно-ролевые модели при разработке рабочих программ дисциплин и комплексных фондов оценочных средств.

По итогам обучения участники представили экспертам 54 проекта учебных дисциплин, посвященных MLOps, инженерии данных, компьютерному зрению, большим языковым моделям и другим направлениям искусственного интеллекта.

И чтобы максимизировать полезность данного мероприятия - участники выложили каждый проект в свой мини-репозиторий (на GitHub или GitVerse), а организаторы агрегировали всё это в один общий каталог:

https://github.com/aimclub/top-ai-dpo

Можно посмотреть как в разных университетах видят связанные с ИИ курсы, переиспользовать их или закинуть issue авторам.

Шаблоны репозиториев тоже выложили - на случай, если пригодится будущим разработчикам таких учебных материалов.


Попался интересный лонгрид про конкурентоспособность людей и ИИ-агентов: https://t.me/vgcourse/560

Разбираются различные модели продуктивности, методики её оценки, статьи по теме и т.п.

Цитируя основные выводы автора:

- Большинство студентов не понимает, почему они могут быть конкурентоспособны в век агентов и как двигаться к этой конкурентоспособности.

- В свежем исследовании METR рассматривается Expenditure Horizon — момент, начиная с которого агент становится менее эффективен, чем квалифицированный человек, что будет использоваться как для измерения эффективности агентов, так и для повышения эффективности использования агентов человеком.

- Наиболее перспективны в век ИИ AI-Amplifier задачи, когда использование ИИ существенно повышает производительность наиболее квалифицированных людей, увеличивая их отрыв от менее опытных. Доля таких задач будет с ближайшие годы расти просто потому, что в AI-Equalizer задачах ИИ будет все сильнее вытеснять людей, а их работа будет использоваться в первую очередь как разметка для ИИ.

- В ваших руках увеличение доли AI-Amplifier задач в вашей работе/учебе. Если она мала — дружеский совет — меняйте работу/учебу.


Коллеги из Sber AI Lab опубликовали новый открытый репозиторий https://github.com/sb-ai-lab/SIRIN (Semantic Inconsistency Recognition and Inspection Nexus) - инструмент для поиска смысловых ошибок в ответах языковых моделей.

Что умеет SIRIN:
- Проверяет соответствие ответа исходному контексту на уровне токенов, последовательностей и отдельных утверждений.
- Поддерживает детекцию галлюцинаций и оценку answerability - достаточности данных для ответа.
- Объединяет несколько классов детекторов: llm-as-a-judge, uncertainty, probing с использованием метамоделей.
- Позволяет сравнивать и комбинировать разные методы детекции - работает как инструмент для исследований и разработки.

Ссылки:
🔗GitHub
🔗GitVerse
🔗Демо на Hugging Face
🔗Статья на arxiv

Поддержать традационно можно звездочками.

702 1 14 1 12

Зоопарк из слоновой кости dan repost
#зоопарк_одобряет #конференции

Вернее, не конференция, а интересный (и бесплатный) вебинар от girafe.ai "Рабочее окружение ML-инженера: делегируем рутину ИИ-агентам"

Почему интересно: хотя бы по той причине, что у girafe.ai есть совместная онлайн-мага с МФТИ, что, на наш взгляд, уже знак качества (Физтех очень разборчив в выборе таких партнеров)

Темы:
• организация удобного рабочего окружения ML-инженера с нуля
• настройка безопасного состояния удалённого сервера для любых нужд
• автоматизация всех рутинных процессов агентами
• формирование скиллов агентов для однокнопочного воспроизводства операций
• кастомизация под свои вкусы и нужды

Когда: 5 августа (среда), в 19:00 (МСК)

Спикер: Владислав Гончаренко - основатель girafe.ai и автор курса MLOps онлайн-магистратуры MSAI (girafe.ai × МФТИ)

Язык русский, участие, повторяем, бесплатное, но нужна предварительная регистрация - вот тут


Анонсируют такой вот вебинар из цикла опенсорс-курсов по ИИ от МФТИ:

20 ta oxirgi post ko‘rsatilgan.