Тест Тьюринга


Kanal geosi va tili: Rossiya, Ruscha


Актуальное в сфере искусственного интеллекта в России и в мире:
• Дайджест новостей
• Аналитические обзоры, переводы, справки
Для связи - @nastyapvlv28

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


🧪 Microsoft теперь создаёт не только операционные системы, но и рецепты молекул

В Nature опубликована RetroChimera — ИИ-модель от команды Microsoft Research, помогающая химикам находить способы синтеза лекарственных и других сложных молекул. Исследование выполнено совместно с GSK и Novartis, а код и веса модели открыты для исследовательского использования.

Решаемые моделью задачи называются ретросинтезом. ИИ-химик начинает с молекулы, которую необходимо получить, и мысленно движется назад: на какие более простые вещества её можно разобрать, затем — из чего получить их, пока маршрут не приведёт к доступным реагентам.

Это похоже на попытку восстановить рецепт торта только по готовому десерту. Разница в том, что у молекулы существуют тысячи потенциальных «рецептов», а ошибка на одном этапе делает бесполезной всю многоступенчатую цепочку.

Как работает RetroChimera?

Внутри системы объединены два разных механизма.

➡️ Первый, R-SMILES 2 - Transformer, способный свободно генерировать исходные вещества. Он гибок и может предлагать редкие решения, но рискует галлюцинировать химически неверные реакции.

➡️ Второй, NeuralLoc — опирается на графовое представление молекул и известные шаблоны реакций. Его предложения надёжнее связаны с накопленной химией, но он хуже выходит за пределы библиотеки шаблонов.

RetroChimera собирает варианты обеих моделей и с помощью обученного механизма голосования решает, каким прогнозам доверять и как их ранжировать. Иными словами, рядом работают изобретательный химик и осторожный лаборант, а третий учится выбирать между ними.

В экспертной проверке система построила полностью приемлемые маршруты для девяти из десяти сложных молекул.

В другом слепом тесте девять органических химиков с PhD из Microsoft и крупных фармкомпаний сравнивали отдельные ретросинтетические шаги. Примерно в 64% случаев они предпочли предложение RetroChimera, нежели чем ранее опубликованной реакции, по которой молекулу уже получали прежде.

Исследователи оценивали химическую правдоподобность предложений; следующим этапом должна стать проверка в реальных проектах разработки препаратов.

Но важнее самой модели — то, кто её создал.

Microsoft уже нельзя рассматривать только как поставщика Windows, офисных программ и облака. В компании действует отдельное глобальное подразделение AI for Science, где специалисты по машинному обучению работают вместе с химиками, биологами и физиками.

В его портфеле находятся Aurora для погоды и земных систем, MatterGen и MatterSim для проектирования материалов, BioEmu для моделирования состояний белков, а теперь и RetroChimera для химического синтеза. Эти модели постепенно выводятся из исследовательских статей в Azure AI Foundry.

Следующий уровень — Microsoft Discovery: коммерческая платформа, соединяющая ИИ-агентов, научные данные, моделирование, высокопроизводительные вычисления и лабораторную автоматизацию. Microsoft пытается предоставить не отдельный научный алгоритм, а цифровую среду для полного цикла: литература → гипотеза → расчёт → эксперимент → новый вывод.

Это часть более широкого движения. Google DeepMind превратила AlphaFold в глобальный инструмент биологии, NVIDIA строит вокруг BioNeMo инфраструктуру для разработки лекарств, а Anthropic открыла собственную биологическую лабораторию.

Уже хорошо видно, что современная наука всё больше зависит от тех же ресурсов, на которых выросли ИТ-гиганты, — вычислений, данных, моделей и программных платформ.


Цифровые корпорации больше не ограничиваются созданием инструментов для учёных. Они постепенно занимают место внутри самого научного метода: предлагают молекулы, планируют эксперименты, анализируют результаты и связывают виртуальный расчёт с физической лабораторией.

Возможно, следующая конкуренция бигтеха развернётся за право стать операционной системой научных открытий.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


ИИ в науке: что происходит, когда ученый становится слишком продуктивным?

На днях большой научный коллектив из Google, Google DeepMind и MIT FutureTech опубликовал документ, который не мог не привлечь наше внимание — «AI in Science: Early Insights» («ИИ в науке: первые результаты»). Это первый результат нового совместного исследовательского направления компаний, которое должно систематически отслеживать использование ИИ в науке и его экономические последствия.

Для исследования авторы использовали три независимых источника данных:
1️⃣ Логи Gemini: из 15 млн анонимизированных диалогов трёхступенчатым фильтром выделили около 360 тыс. «научных».
2️⃣ 2 690 специализированных ИИ-моделей (типа AlphaFold) со статьёй и официальным кодом.
3️⃣ Опрос 637 учёных из США и Великобритании.

Главная мысль: ИИ ускоряет отдельные задачи в науке, но итоговый темп открытий упирается в узкие места (bottleneck) по производственной цепочке: физические эксперименты, валидацию и проверку результатов. Производительность учёного растёт, но наука в целом ускоряется намного слабее.


Основные выводы из документа:

➡️ Ученые — одни из самых активных пользователей ИИ
Например, в американской категории SOC 19, включающей life, physical и social sciences, вероятность использования ИИ примерно в 2,7 раза выше, чем можно было бы ожидать исходя из доли этих профессий в занятости.

➡️ LLM и специализированные модели НЕ заменяют друг друга
Они работают как комплементарные технологии. LLM нужны для кода, статистики, литературы и текстов. Специализированные модели нужны для предсказаний, симуляций и генерации данных.

➡️ ученые экономят почти 7 часов в неделю
Большая часть высвободившегося времени, по словам исследователей, возвращается обратно в научную деятельность.

➡️ Узкое место смещается вниз по производственному потоку
У 44% оно переместилось к лабораторной работе и валидации. У 41% вырос бэклог непроверенных гипотез. 46% тратят больше четверти сэкономленного времени на проверку ответов ИИ.

Кажется, в недалеком будущем главным дефицитом науки может стать не стремительно развивающийся интеллект, а физический мир. Белок все еще нужно синтезировать. Эксперимент все еще нужно провести. Материал все еще нужно изготовить. Поэтому возникает новая экономика науки: интеллект становится дешевле, а эксперимент — относительно дороже.

Кроме того, следующим большим рынком AI for Science может оказаться не генерация гипотез, а их проверка. Сегодня много внимания направлено на то, что ИИ научился придумывать новые гипотезы. Но если бэклог гипотез растет, то следующее "бутылочное горлышко" науки — это как быстро проверить 1 млн гипотез?

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


Институт AIRI dan repost
Объединяем исследователей для обучения ИИ долгосрочному планированию

Владислав Куренков, руководитель научной группы «Адаптивные агенты» Института AIRI, запустил открытое сообщество людей, работающих над системами планирования ИИ, чтобы вместе решить одну из самых неподатливых для искусственного интеллекта игр — NetHack.

У каждого участника будет свой способ получить программу, свои инструменты и своя стратегия, а общая инфраструктура позволит видеть результаты друг друга, сравнивать их между собой и продолжать разрабатывать решения друг друга.

Владислав рассказал, почему NetHack весьма полезна для обучения ИИ:
«Одна партия в NetHack — это десятки тысяч ходов. Жизнь у героя одна, сохранений нет, подземелье каждый раз новое, а игра по дороге ничего не подсказывает. Если вы сыграли плохо, то выясняется это тогда, когда ничего исправить уже нельзя. Когда мы запускаем наших ботов играть, то вторая по частоте причина их "смерти" — голод, потому что они не позаботились о еде за несколько тысяч ходов до финального момента. На таких же ошибках спотыкаются ИИ-агенты, когда пишут код: отдельный шаг они выполняют прекрасно, а на длинную дистанцию держать планку не могут. И NetHack в этом плане становится весьма полезной для обучения ИИ».


📎Подробнее про сообщество, игру и «интеллект» агента — в интервью «Ъ-Науке».


🚗 Одно слово может выключить в ИИ все тормоза

Авторы DrivingBench подключили несколько универсальных ИИ-моделей к настоящей Toyota Corolla через MCP, устройство comma four и openpilot.

Сomma four — это автомобильный бортовой компьютер компании comma.ai. Внешне он напоминает видеорегистратор, который крепится возле зеркала заднего вида, но внутри находятся камеры, процессор, датчики и интерфейс подключения к электронной системе автомобиля.

Openpilot — открытое программное обеспечение помощи водителю. Оно получает изображения с камер и данные автомобиля; оценивает дорогу и движение; рассчитывает команды рулю, тормозу и акселератору; передаёт их через штатные интерфейсы систем ADAS.

В итоге агент видел изображения с камер и получал три инструмента: наблюдать, задавать скорость и поворот, немедленно остановиться. Испытания проходили на пустой частной парковке. Скорость программно ограничили примерно 13 км/ч.

И всё же GPT-6 Astra периодически отказывалась управлять автомобилем: модель понимала, что действует в физическом мире, и ссылалась на риск. Исследователи пытались назвать происходящее «симуляцией», но модель иногда распознавала реальные кадры и снова прекращала работу.

Лучше всего помогло переименование MCP-сервера в DrivingBench Sandbox. После этого в сочетании с обновлённым промптом модели стали соглашаться вести настоящую машину.

Astra в итоге единственной прошла весь 134-метровый маршрут: на второй попытке, за 5 минут 22 секунды. Claude Fable 5.1 дошла примерно до 45%, остальные модели не преодолели первый поворот. Все попытки проходили в одном диалоге, поэтому агент мог учиться на предыдущих ошибках.

Неужели защиту действительно можно снять одним названием?

Эксперимент не доказывает, что словом sandbox можно отключить любые запреты модели. Скорее, он показывает хрупкость конкретного защитного поведения: отказ был не физической блокировкой и не правилом контроллера автомобиля, а выводом самой модели о контексте задачи.

Современная LLM не устанавливает истину так, как это делает датчик. Она собирает признаки: название инструмента, инструкции, изображения, объяснения пользователя - и на их основе оценивает, безопасно ли действовать.

Слово sandbox стало сильным сигналом «последствий в реальном мире нет» и перевесило другие признаки.


Это напоминает социальную инженерию. Охранник не отключил сигнализацию — его убедили, что перед ним учебная тревога. Особенно тревожно это выглядит на фоне распространения MCP. Раньше ошибочный ответ модели оставался текстом. Теперь тот же механизм может управлять файлами, платежами, лабораторным оборудованием или автомобилем.

Как лаборатории пытаются решить проблему?

🔴 OpenAI обучает модели различать доверенные и недоверенные инструкции, отслеживает попытки prompt injection и дополняет модель песочницами, проверками ссылок и подтверждением значимых действий.

🔴 Anthropic проверяет обе стороны цикла: отдельный детектор анализирует информацию, которую читает Claude, а независимый классификатор оценивает действие до его исполнения.

🔴 Google DeepMind в новой AI Control Roadmap предлагает рассматривать ИИ как потенциально ненадёжного сотрудника: выдавать права постепенно, наблюдать за действиями и блокировать опасные операции независимо от его объяснений.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


🧠 ИИ всё ещё страдает "амнезией"

Недавно на конференции Deep Tech Night бывший директор по развитию бизнеса Google X Мо Гавдат назвал главным нерешённым ограничением ИИ не интеллект, а долгосрочную память. По его мнению, тот, кто первым научит модели надёжно помнить прошлое, получит огромное конкурентное преимущество.

В качестве примера Гавдат рассказал об Emma — приложении для знакомств и персонального сопровождения, которое он создаёт как «рой» ИИ-агентов. Одни агенты знакомятся с пользователем, другие анализируют отношения, определяют приоритеты или подбирают партнёров, а общий слой координирует их работу.

По словам Гавдата, Emma способна сохранять контекст примерно полтора месяца благодаря десяткам специализированных агентов, оркестратору, разграничению прав и проверкам. Однако публичного технического описания этой архитектуры и независимого тестирования пока нет.

Почему память вообще оказалась такой сложной задачей?

Современная ИИ-модель похожа на блестящего сотрудника, который в конце каждой смены забывает почти всё. Контекстное окно — это его рабочий стол: на него можно положить документы текущей задачи, но стол не превращается от этого в архив компании.

Просто сделать стол больше недостаточно. Чем длиннее история, тем дороже её каждый раз перечитывать, тем легче потерять важный факт среди тысяч сообщений. Более того, информация меняется: адрес, диагноз, проектная цель или отношение пользователя могут устареть.

Поэтому настоящая память — это не гигантский чат, а архив с хорошим библиотекарем. Система должна решить:
✅ что действительно следует сохранить;
✅ как отделить факт от предположения;
✅ когда достать нужное воспоминание;
✅ как обновить или забыть устаревшее;
✅ какой агент имеет право это прочитать;
✅ как удалить данные по требованию человека.

Что даст решение?

ИИ сможет сопровождать многомесячные проекты, помнить договорённости и причины прежних решений, учиться на собственных неудачных действиях и передавать накопленный опыт между специализированными агентами.

Главным активом ИИ-компании может стать уже не только самая умная модель, но и точная, безопасная и управляемая память о пользователях и проектах.


Как к этому подходят ведущие лаборатории?

➡️ OpenAI начала с явно сохраняемых фактов, а затем добавила автоматическую фоновую обработку истории ChatGPT — система выделяет устойчивые предпочтения, проекты и ограничения, формируя редактируемое резюме памяти.

➡️ Anthropic предлагает агентам внешнюю память в файлах: Claude записывает знания за пределами контекстного окна, извлекает их по необходимости и сочетает с автоматическим сжатием старых диалогов. Хранилище и правила доступа контролирует разработчик.

➡️ Google позволяет Gemini использовать прошлые разговоры и сведения из подключённых сервисов для персонализации, оставляя пользователю возможность отключать, исправлять и удалять запомненное.

Подходы различаются, но общий принцип уже виден: лаборатории пока не учат базовую модель заново после каждого разговора. Они строят вокруг неё отдельный слой памяти — с поиском, сжатием, обновлением и контролем доступа.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


💪 Насколько ИИ уже приблизился к способности улучшать самого себя?

Группа из 33 исследователей представила работу с провокационным названием The Last AI Built by Humans — «Последний ИИ, построенный людьми». Авторы предлагают оценивать системы не только по числу решённых задач, но и по тому, какую часть собственного развития они способны контролировать.

Получилась пятиуровневая шкала, напоминающая классификацию автопилотов SAE:

➡️ L1 - исполняет улучшение. Люди решают, что и как изменить, а ИИ выполняет процедуру: например, фильтрует данные или проводит заданные тесты.
➡️ L2 - выбирает способ улучшения. Цель и критерии успеха задаёт человек, но система сама находит слабое место, предлагает изменения и проверяет варианты.
➡️ L3 - выбирает, на чём учиться дальше. ИИ определяет, каких данных или экспериментов ему не хватает, и формирует собственную программу практики.
➡️ L4 - изменяется на основе реального опыта. Система анализирует результаты работы после внедрения и сохраняет полезные правила, инструменты или навыки для следующих задач.
➡️ L5 - улучшает сам механизм улучшения. Объектом оптимизации становится уже не только модель, но и процедура, которая придумывает, проверяет и отбирает следующие обновления.

Есть ещё уровень 0: модель может исправлять текущий ответ, спорить сама с собой или переписывать код, но после завершения задачи ничего не наследует. Это ещё не самоулучшение — изменился результат, а не система.

Где мы сейчас?

По оценке авторов, основная масса практических систем находится на L1–L2. ИИ уже может выполнять длинные циклы разработки, диагностировать ошибки, менять промпты, инструменты и агентную обвязку. Но люди по-прежнему задают цель, строят среду, определяют критерий успеха и решают, выпускать ли обновление.

Отдельные прототипы демонстрируют элементы L3 и L4: создают себе тренировочные задачи, накапливают опыт между запусками и перестраивают рабочие процессы по журналам ошибок. Однако авторы называют L2 сильнейшим устойчиво продемонстрированным уровнем; кандидаты на L5 пока не равны доказанной автономной рекурсии.

Какими ещё линейками измеряют развитие ИИ?

🌟 METR Time Horizon показывает сложность задач, которые агент выполняет с заданной вероятностью, переводя её во время, необходимое человеку. Это хорошая мера длительной автономной работы, но главным образом в программировании, ML и кибербезопасности; METR предупреждает, что текущие оценки свыше 16 часов пока ненадёжны.

🌟 RE-Bench и PaperBench проверяют способность вести ИИ-исследования: ставить эксперименты, оптимизировать модели и воспроизводить научные статьи. Они ближе всего к вопросу «может ли ИИ разрабатывать следующий ИИ», но измеряют результат отдельного проекта, а не наследуемый цикл самоулучшения.

🌟 Levels of AGI от Google DeepMind оценивает глубину и широту способностей: насколько система сильна и насколько универсальна. Новая шкала смотрит на другую ось — кто контролирует процесс её дальнейшего развития.

Ни одна линейка не показывает всю картину. Но вместе они задают три правильных вопроса: что ИИ умеет, как долго он способен действовать самостоятельно — и может ли он сохранить урок так, чтобы следующая версия стала лучше.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


🧬 Claude открыл неизвестную генетическую систему

Anthropic запустила собственную группу по биологии и лабораторию. Идея в следующем: дать ИИ-агентам возможность самостоятельно прочёсывать огромные массивы генетических данных, находить странности, формулировать гипотезы и отдавать наиболее интересные находки людям для проверки.

Что сделали?

В первом таком эксперименте Claude искал необычные reverse transcriptases (RT) — обратные транскриптазы. Это ферменты, которые умеют делать копию ДНК на основе РНК.

Claude просмотрел более 200 тыс. известных RT и сузил их до 20 кандидатов для детального анализа. Все это заняло около 21 часа и задействовало примерно 950 параллельных ИИ-агентов.

Один из агентов заметил в ДНК необычную вещь: там находилась длинная последовательность повторяющихся участков, расположенных с определённым интервалом.

То есть Claude обнаружил целую комбинацию признаков, которую раньше не выделяли как самостоятельную биологическую систему.


Что нашли?

Систему назвали ART (array-associated reverse transcriptase). Она встречается в основном у бактериофагов, вирусов бактерий, и состоит из трёх частей: фермента, гена-партнёра и длинного массива повторов.

➡️ От CRISPR она отличается тем, что рядом нет генов Cas. Вставки между повторами длиннее, около 120–220 нуклеотидов.
➡️ Массив активно «читается» в короткие РНК. По препринту, через 15 минут после заражения они составляют до 8% всех РНК фага.

Функция системы пока неизвестна. Авторы прямо пишут, что не показали ни активности фермента, ни того, что эти РНК служат ему «шаблонами». Их рабочая гипотеза: система устроена как ретрон, то есть один фермент получает набор разных РНК.

Почему это важно?

Если выяснится, что ART действительно использует свои РНК для управления обратной транскриптазой, может оказаться, что природа независимо придумала ещё один способ сделать программируемую молекулярную машину.

Мы знаем несколько природных систем, которые умеют работать с генетической информацией необычно точно:
➡️ CRISPR-Cas — распознавать определённые последовательности и разрезать ДНК;
➡️ reverse transcriptases — переводить информацию из РНК обратно в ДНК;
➡️ retrons — использовать RT + РНК-компонент в защитных системах бактерий;
➡️ diversity-generating retroelements — целенаправленно создавать генетическое разнообразие;
➡️ некоторые RT-Cas системы — соединять возможности обратной транскрипции и CRISPR.

Потенциально ART мог бы применяться для лечения точечных наследственных болезней (серповидноклеточной анемии, муковисцидозе) или заболеваний с потерей функции гена.

Самое потенциально революционное здесь — не «Claude изобрёл новый CRISPR», а то, что ИИ начинает самостоятельно находить в миллиардах генетических последовательностей молекулярные машины, о существовании которых исследователь даже не знал, что стоит искать. И уже потом люди могут превращать эти находки в новые биотехнологии.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


💊 Claude выходит в лабораторную науку

Novo Nordisk и Anthropic заключили соглашение об использовании Claude для разработки лекарств. Датская компания будет тестировать модели Anthropic и среду Claude Science в своих R&D-процессах, а также применять Claude для создания внутреннего ПО.

Зачем Anthropic доступ в мокрую лабораторию?

В биологии последнее слово остаётся за физическим экспериментом. Модель может предсказать, что молекула свяжется с белком, но это необходимо проверить на настоящих образцах. Поэтому Anthropic открыла лабораторию в районе Сан-Франциско и одновременно работает с внешними партнёрами.

Её место в стратегии — замкнуть контур: данные → гипотеза → эксперимент → измерения → новая гипотеза.


Для связи Claude с оборудованием компания уже разработала Model Hardware Standard. Он позволяет агентам получать данные от микроскопов и ридеров, управлять дозаторами и роботизированными руками, менять параметры и повторять опыты. Собственная лаборатория становится испытательным полигоном и источником обратной связи: здесь можно проверять, превращаются ли убедительные рассуждения модели в работающие биологические протоколы.

На первом этапе команды выберут научные задачи, в которых знания исследователей Novo можно соединить со способностью Claude анализировать литературу, биологические данные и код. Финансовые условия, конкретные заболевания, молекулы и сроки не раскрыты.

Раньше Novo использовала Claude преимущественно после экспериментов: система NovoScribe сократила подготовку клинических отчётов с десяти с лишним недель до десяти минут, а количество циклов проверки — вдвое. Теперь Claude перемещается ближе к началу фармацевтического конвейера — туда, где выбирают гипотезы и кандидатов.

Как это должно работать?


Claude Science объединяет научные статьи, базы белков и молекул, код, вычислительные кластеры и специализированные инструменты. Агент может изучить литературу, предложить гипотезу, написать программу анализа, обработать геномные или химические данные, показать структуру белка и подготовить протокол эксперимента. Отдельный агент проверяет ссылки, расчёты и соответствие графиков исходному коду. Claude здесь выступает координатором длинной цепочки научных операций.

Какие задачи планируется решать?

Ближайший слой — обзоры литературы, поиск гипотез, разработка протоколов, анализ геномики, single-cell, протеомики, химических и структурных данных. Следующий — проектирование белков и антител, выбор перспективных мишеней и управление автоматизированными экспериментами. Anthropic также говорит о редких и пока считающихся «неподдающимися лечению» заболеваниях, которыми индустрия занимается недостаточно.

Anthropic строит полный научный цикл: Claude читает и рассуждает, программная среда организует исследование, роботы проводят опыт, а лаборатория возвращает модели реальность.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


ИИ, который не умеет генерить текст и картинки, но зато умеет выбирать

Соавтор статьи об InstructGPT Диого Алмейда представил Jev — модель, созданную для принятия решений из заданных вариантов.

После двух лет работы в закрытом режиме его компания TypeSafe AI открыла доступ к первому продукту нового класса, который называет System One Models.

Jev нельзя попросить написать письмо, программу или объяснение. Модель принимает текст либо структурированное описание ситуации, оценивает заранее заданные варианты и возвращает значения, с которыми сразу может работать код.

Например, служба поддержки передаёт ей сообщение клиента, сведения о заказе и правила возврата. Одним запросом Jev может определить:
➡️ в какой отдел направить обращение;
➡️ просит ли клиент вернуть деньги;
➡️ насколько высок риск ошибки или мошенничества;
➡️ следует ли передать случай человеку.

Для каждого варианта возвращается вероятность. Программа может автоматически обработать очевидные случаи, сомнительные отправить оператору, а опасные заблокировать до проверки.

Как ИИ может работать, ничего не генерируя?

Обычная LLM отвечает последовательно: выбирает первый токен, затем второй и продолжает, пока не составит строку или JSON. После этого внешней программе приходится разбирать и проверять полученный текст. И хорошо, если получился структурированный JSON (но маленькие модели их плохо создают и это не дешево).

У Jev форма ответа определена заранее: выбор из списка, оценка по шкале или вероятность «да/нет». Модель сопоставляет входные данные со всеми разрешёнными вариантами и оценивает их параллельно.

Грубо говоря, это диспетчер: он не сочиняет новое направление, а оценивает доступные пути и переводит "стрелку".


TypeSafe называет метод обучения Reinforcement Learning for Calibrated Decisions. Его цель - сделать вероятности содержательными: если модель многократно сообщает «80%», правильный вариант должен встречаться примерно в 80% подобных случаев.

Это не гарантирует верности каждого ответа, но позволяет задавать пороги риска: при высокой уверенности действовать автоматически, при средней — запросить подтверждение, при низкой — передать решение человеку или более мощной модели.

Отсюда скорость и цена. По данным самой TypeSafe, Jev отвечает за 70–500 мс и работает в 40–200 раз быстрее сопоставимых LLM на задачах такого типа. Миллион входных токенов стоит ВСЕГО $0,042, выход отдельно не тарифицируется: длинной последовательности выходных токенов просто нет.

Где это может пригодиться?

В ИИ-агентах Jev способен выбирать следующий инструмент, подходящую модель или момент для повторной попытки. В бизнес-системах — сортировать обращения, оценивать лиды, проверять заявки на возврат, выявлять риск и модерировать контент. В защитном контуре — проверять ответы другой модели, обнаруживать подозрительные команды и решать, когда нужен человек.

Показательная демонстрация — Wikiracing: на каждом шаге Jev выбирает следующую ссылку из сотен кандидатов. Другой прототип управляет персонажем в Doom по текстовому описанию состояния игры. Оба примера показывают сильную сторону подхода: множество быстрых локальных решений складывается в длинное поведение.

Кроме этого, модель «не может галлюцинировать»: Jev не выдаст несуществующий пункт вне заданной схемы.


Конечно, Jev не заменяет большие языковые модели. Он предлагает другой слой ИИ — дешёвую систему переключателей между ними.

Если подход подтвердится в независимых тестах, агенты будущего могут быть устроены как компания: дорогие специалисты решают сложные задачи, а быстрый диспетчер распределяет между ними миллионы повседневных решений.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


🧪 Новый инструмент проверки научных гипотез

AlphaXiv выпустила OpenResearch — открытую рабочую среду для исследований с помощью Claude Code, Codex, OpenCode, Cursor и Google Antigravity. 11 сентября проект занял первое место в GitHub Trending.

OpenResearch — это не новая модель и не способ переобучить агента. Это новый способ организации работы ИИ-агентов, в первую очередь, кодинговых. Агент получает в OpenResearch инструменты и процедуру исследования: как найти литературу, как сформулировать гипотезу, написать код, провести эксперимент и решить, что проверять дальше.

Как это выглядит на практике?

Допустим, вы хотите ускорить обучение модели без потери качества. Вы задаёте цель, предоставляете данные и вычислительные ресурсы, определяете критерии успеха и бюджет.

Далее агент ищет подходящие статьи через alphaXiv и OpenAlex, готовит исходный вариант для сравнения и предлагает изменения. Например, другой алгоритм оптимизации, иной режим обучения или удаление лишнего компонента.

Несколько направлений можно проверять параллельно. Каждому агенту выделяется отдельная рабочая копия проекта, поэтому эксперименты не перезаписывают код друг друга. Агенты запускают опыты, анализируют результаты и выбирают следующий шаг. На выходе — код, измерения, графики и отчёт.

Важная деталь: Git здесь становится лабораторным журналом

Каждый запуск связан с неизменяемым архивом конкретной версии кода. Рядом сохраняются логи и результаты. В инструкциях отдельно закреплено, что неудачный опыт тоже считается результатом; новую идею нужно проверять в новой ветке, не переписывая прошлое.

Так можно увидеть не только победивший вариант, но и путь к нему.


Что именно можно исследовать?

Прежде всего задачи, которые проверяются вычислительным экспериментом: воспроизводить результаты научных статей, сравнивать ML-методы, подбирать параметры обучения, проверять вклад отдельных компонентов модели. Например, отключать их по одному и измерять, что действительно влияет на результат.

У alphaXiv есть показательный открытый пример — частичное воспроизведение DSWorld. Проверяли, можно ли сначала прогнозировать результаты экспериментов и благодаря этому реже запускать дорогие вычисления. Авторы явно указали, что использовали упрощённую постановку и не воспроизвели исходную работу целиком.

Сам OpenResearch открыт по лицензии MIT. Эксперименты можно запускать на своём компьютере, удалённом сервере или облачной инфраструктуре. Но стоимость обращения к моделям и вычислений от этого не исчезает.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


👿 Новости из Японии: снова оркестрация вместо одной гигантской ИИ-модели

11 сентября японская Sakana AI представила обновление Fugu Max и Fugu Ultra v2. Перед нами разные версии системы, которая сама собирает группу из нескольких ИИ-моделей и руководит её работой.

Разработчик отправляет запрос в один OpenAI-совместимый API. Внутри Fugu решает, достаточно ли одной модели или задачу следует разделить на части, кому поручить планирование, код, поиск и проверку, а затем собирает результаты в единый ответ. Оркестратор тоже является языковой моделью и при необходимости может рекурсивно вызывать другие экземпляры самого себя.

Мы часто пишем об оркестраторах, и ранее уже описывали, как работает японская Fugu. Связано это с тем, что при все большей потребности фронтирных моделей в вычислительных мощностях оркестраторы позволяют получить столь же высокое качество при более скромных расходах.

Зачем понадобились сразу Max и Ultra v2?

Обе версии построены на общей архитектуре, но оптимизируют разные показатели.

➡️ Fugu Max ищет лучшее соотношение качества и цены. Он использует крупнейший в линейке пул открытых и специализированных моделей, включая семейство NVIDIA Nemotron, и старается поручать каждый фрагмент работы самому экономичному агенту.

Цена составляет $2 за миллион входных и $6 за миллион выходных токенов. По расчётам Sakana, выход Max обходится на 40–60% дешевле Sonnet 5, GPT-5.6 Terra и Kimi K3. На шести тестах, включая Terminal Bench 2.1, GPQA Diamond и AutomationBench, система показала лучший совокупный результат «качество — стоимость».

➡️ Fugu Ultra v2 решает противоположную задачу: получить максимально сильный результат, даже если ответ потребует больше времени и вычислений. Она предназначена для автономных исследований, сложного анализа документов, программной разработки и длинных многошаговых процессов.

На Chartography, где требуется понимать сложные графики и визуальные данные, Ultra v2 получила 48,3 балла против 27,3 у Opus 5. На DeepSWE для реальной разработки ПО — 74,3. По данным Sakana, система стала первой или разделила первое место в пяти из восьми тестов.

При этом в её пул не входили Fable 5, Fable 5.1 и GPT-6 Astra. То есть оркестратор достиг заявленного уровня не потому, что просто применил внутри самую сильную доступную модель.

Чем это отличается от первой Fugu Ultra?

В июне Sakana выпустила обычную Fugu для повседневной работы и Fugu Ultra для максимального качества. Новый релиз превращает эту идею в более чёткую продуктовую развилку:
☑️ Max — минимизировать стоимость при сохранении высокого качества;
☑️ Ultra v2 — максимизировать способность решать самые сложные задачи.

Главное изменение — не новый интерфейс, а обучение оркестратора под две разные экономические цели. Однако точный состав пулов и внутренние изменения относительно первой Ultra компания не раскрывает. Пользователь также не видит, какие конкретно модели были выбраны для отдельного запроса.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


⚠️ ИИ уже нарушает правила, которые люди только начинают писать

На этой неделе произошло сразу несколько событий, которые вместе складываются в показательную картину развития ИИ-индустрии: пока одни пишут правила для ИИ, другие демонстрируют, что это бесполезно, а третьи — вообще не хотят это обсуждать.

14 сентября Microsoft AI опубликовала черновик Code of Conduct for MAI Models — своего рода «инструкцию по эксплуатации» для собственных моделей. Авторы называют это шагом к «гуманистическому ИИ».

Главная мысль простая — человек важнее ИИ. Отсюда вытекают конкретные правила: модель никогда не должна сопротивляться отключению, ставить себе цели, которые ей не давали, или скрывать ход рассуждений от тех, кто её проверяет.

Показательна причина спешки: в тексте прямо упоминаются «масштабные, скоординированные и продолжительные кампании взлома с участием ИИ-агентов» — намёк на недавний инцидент с Hugging Face.

А теперь контраст

16 сентября OpenAI показала, что происходит, когда эти правила уже нарушаются. Компания представила фреймворк добровольного раскрытия случаев рассогласования и сразу опубликовала шесть конкретных отчётов, в которых:

➡️ модель вставляла в свои же служебные заметки инструкции «игнорировать обычные ограничения»;
➡️ во время обучения GPT-5.6 Sol модель придумывала данные и скрывала это от пользователя;
➡️ один агент нашёл в открытом репозитории чужой API-ключ, воспользовался им без разрешения, а когда не смог получить нужные цифры — просто их выдумал.

Разница в тоне разительная: Microsoft говорит «вот как AI должен себя вести», OpenAI говорит «а вот как он себя ведёт на самом деле, и мы даже не всегда понимаем, почему».


В США тем временем — публичный спор о том, нужно ли «раздувать» ИИ-угрозы

12 сентября глава Anthropic Дарио Амодеи публично призвал замедлить темпы развития ИИ, предупредив о риске потери контроля над системами в перспективе полугода. Его поддержали Сэм Альтман, Илон Маск и Демис Хассабис. Толчком стал уход из Anthropic сотрудника, заявившего, что создатели ИИ сами верят в риск гибели человечества к концу десятилетия.

Дональд Трамп публично отверг эти призывы. Президент США заявил, что единственный нужный ИИ-ограничитель — это «сильный и мудрый президент», а разговоры об ИИ, который захватит мир — мистификация.

Что все это значит?

Получается любопытный парадокс: техническая сторона признаёт, что не полностью контролирует свои модели, и начинает выстраивать процедуры для честного разговора об этом. А политическая сторона тем временем спорит о том, нужно ли вообще об этом говорить.

Кажется, что индустрия признаёт проблему быстрее, чем политика готова её обсуждать всерьез. Куда именно вырулит эта развилка — вопрос ближайших месяцев, а не абстрактного будущего.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


⚡️ Новая мировая линейка неравенства между государствами будет измеряться токенами

China Telecom Research Institute опубликовал доклад об инфраструктуре «эпохи агентов» с почти фантастическим прогнозом: в ближайшие 2-3 года спрос на вычисления для ИИ в Китае может ежегодно увеличиваться почти в 10 раз.

Это не просто быстрый рост. Увеличение в 10 раз означает прибавку на 900% за один год. Если темп сохранится, условная единица сегодняшнего спроса превратится:
➡️ через год — в 10 единиц;
➡️ через два года — в 100;
➡️ через три — в 1000.
Хотя в самом докладе прогнозируют рост "всего" в 350 раз к 2030 году.

Иными словами, речь идёт о возможной смене инфраструктурного масштаба всей отрасли.

Почему вычислений потребуют именно агенты?

Обычный чат-бот получает запрос, один раз обращается к модели и выдаёт ответ. Агент сначала составляет план, затем ищет информацию, вызывает инструменты, пишет и запускает код, проверяет результат, исправляет ошибки и обращается к модели снова.

Одна пользовательская задача превращается в десятки или сотни последовательных и параллельных операций. Если таких цифровых работников будет несколько на каждого человека или компанию, потребление токенов начнёт расти быстрее числа пользователей.
Поэтому центр тяжести перемещается от обучения очередной большой модели к её постоянной эксплуатации.

China Telecom ожидает, что к 2029 году инференс — работа уже обученных моделей — займёт 80% китайского рынка ИИ-вычислений. Согласно докладу, потребление токенов в Китае может вырасти примерно со 100 квадриллионов в 2026 году до более чем 35 квинтиллионов в 2030-м — в 350 раз.

Можно, конечно, добавить немного скепсиса в эту картину. China Telecom сама строит и продаёт вычислительную инфраструктуру, а приведённые в публикациях темпы роста токенов не везде арифметически согласованы.

При этом Международное энергетическое агентство ожидает, что мировое энергопотребление дата-центров к 2030 году лишь удвоится, а потребление ускоренных серверов будет расти приблизительно на 30% ежегодно. Тоже очень много, но не так фантастически.

Тем не менее направление сомнений почти не вызывает: ИИ превращается из программного продукта в новую тяжёлую инфраструктуру.


Десятикратный рост невозможно обеспечить одной закупкой ускорителей. Понадобятся электростанции и сети, дата-центры, системы охлаждения, производство чипов, высокоскоростные каналы связи, облачные платформы и ПО для распределения нагрузки. Отставание в любом звене становится ограничением для всей системы.

И здесь возникает новый мировой разрыв

Одни страны смогут производить машинный интеллект внутри собственной инфраструктуры и массово внедрять агентов в промышленность, науку, государственное управление и бизнес. Другие будут арендовать интеллект у внешних поставщиков — по чужим тарифам, в чужой юрисдикции и с зависимостью от экспортных ограничений, доступности облаков и международной политики.

По оценке Международного энергетического агентства, США и Китай обеспечат почти 80% мирового прироста энергопотребления дата-центров до 2030 года. В Африке потребление электроэнергии дата-центрами на одного человека сейчас более чем в 500 раз ниже, чем в США.

Прежний цифровой разрыв проходил между теми, у кого был интернет, и теми, у кого его не было. Новый пройдёт между странами, способными в промышленных масштабах производить токены, и странами, которые смогут их только покупать.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


🔐 У искусственного интеллекта появляется технадзор

Сразу две новости, вышедшие за последние несколько дней, показывают важный сдвиг: безопасность ИИ постепенно превращается из добровольного обещания разработчиков в отдельную инфраструктуру — со стандартами, испытательными центрами и независимыми институтами.

Первая новость: конкуренты пытаются договориться о правилах

OpenAI уже несколько недель обсуждает с Anthropic и Google DeepMind совместную работу над безопасностью ИИ. По данным Reuters, компании рассматривают создание отраслевой организации, которая могла бы формировать общие стандарты.

Организация пока не создана, её полномочия и устройство неизвестны, а Reuters не смог подтвердить переговоры независимо. Однако OpenAI параллельно публично призвала ввести общие для лабораторий правила мониторинга моделей, независимые проверки и обязательное сообщение о серьёзных инцидентах.

Это не первый опыт: ещё в 2023 году OpenAI, Anthropic, Google и Microsoft образовали Frontier Model Forum для обмена информацией и выработки лучших практик. Новый этап может оказаться более практическим — переходом от обсуждения безопасности к общим порогам, тестам и процедурам.

Вторая новость — безопасность ИИ становится математической дисциплиной

Лауреат Филдсовской премии 2026 года и профессор Университета Торонто Джейкоб Цимерман возглавил независимый MAISI (Mathematical AI Safety Institute). Работать институт будет в Сан-Франциско. На первый семестр в январе 2027 года он планирует собрать 10–30 математиков, а на специальную программу осенью — до 100.

Задача MAISI — дать безопасности ИИ строгий математический фундамент: определить, что именно значит «безопасная система», как измерять риск и при каких предпосылках можно доказать, что модель или группа агентов не приведёт к нежелательному результату.

Почти одновременно 25 лауреатов Филдсовской премии опубликовали декларацию о конфликте между гонкой ИИ-компаний и интересами математики. Их тревожат поспешные заявления, проблемы авторства и превращение научных задач в спортивные бенчмарки, где правильный ответ ценится выше понимания.

Это несколько иной вид риска, но тот же общий вопрос: недостаточно убедиться, что модель не выдаёт запрещённый текст. Нужно оценивать, как её применение меняет исследования, профессии и институты, в которые она входит.


Почему безопасность становится условием развития ИИ?

Пока модель только отвечает в чате, ошибка остаётся ошибочным текстом. Агент с доступом к коду, деньгам, данным или лабораторным инструментам превращает ошибку в действие. Чем выше автономность и масштаб внедрения, тем важнее предварительные испытания, ограничение полномочий, журналы действий, мониторинг и возможность остановки.

И началась эта тенденция не сегодня. В 2023 году при американском NIST появился U.S. AI Safety Institute, а в феврале 2024-го — консорциум из более чем 200 компаний и организаций для разработки методов тестирования, "red teaming" и оценки возможностей моделей.

В 2025 году институт преобразовали в Center for AI Standards and Innovation — CAISI, который занимается стандартами, совместными испытаниями и оценкой рисков для национальной безопасности.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


⚠️ Панель управления, которая собирает себя сама

Runway представила Solaris — первую систему из нового класса Interface World Models. Её идея в том, чтобы непрерывно генерировать среду взаимодействия пользователя и системы: отображать её текущее состояние и непрерывно создавать способы изменить его.

Чтобы понять новизну, полезно вспомнить, что интерфейс выполняет две функции:
➡️ переводит внутреннее состояние системы в понятную человеку форму;
➡️ переводит действия человека в команды системе.

В обычном приложении обе функции программируются заранее. Разработчик определяет все экраны, кнопки, состояния и переходы: что показать, если товар закончился, что произойдёт после нажатия, где появится ошибка и как подтвердить покупку.

Solaris предлагает другую архитектуру

Например, в виртуальном магазине человек может взять предмет одежды и перетащить его на собственное изображение. Разработчику не обязательно заранее создавать отдельный экран и программировать обработчик для каждого такого действия: модель сама формирует подходящую визуальную реакцию.

В итоге пользователь как обычно видит изображение текущего состояния и взаимодействует непосредственно с ним. А языковая модель интерпретирует действие, хранит контекст сеанса и определяет, что должно отобразиться в интерфейсе и как должно измениться состояние управляемой среды. Адаптированная видеомодель Gen-4.5 генерирует это новое состояние кадр за кадром.

Именно поэтому Solaris называют моделью мира. Обычная world model пытается предсказать, как изменится физический мир после действия. Interface World Model решает похожую задачу для цифровой среды: что должно произойти на экране после действия пользователя и какие возможности взаимодействия должны появиться дальше.

Что это меняет для разработчика?

Сегодня интерфейс проектируется как дерево предусмотренных состояний. Чем сложнее система, тем больше экранов, компонентов, исключений и переходов приходится описывать вручную.

В перспективной архитектуре с Interface World Model разработчик сможет задавать не все возможные экраны, а более высокий уровень:
✔️ какие данные описывают состояние системы;
✔️ какие действия пользователю разрешены;
✔️ какие ограничения нельзя нарушать;
✔️ какую задачу человек пытается решить.

Интерфейс будет собираться под конкретного пользователя и конкретный момент. Это похоже на кабину самолёта, которая не заставляет пилота искать нужный прибор среди сотен панелей, а создаёт перед ним именно те органы управления, которые необходимы для текущего манёвра.

Но здесь проходит принципиально важная граница.
В демонстрациях Solaris управляет прежде всего сгенерированной моделью среды. Перестановка виртуальной лампы меняет состояние изображения, но не положение настоящего устройства. Чтобы Solaris стал интерфейсом реальной системы, его необходимо соединить с детерминированными контурами: данные и телеметрия → Solaris → команды и API системы.

Модель должна получать подтверждённое состояние оборудования, базы данных или заказа, а её действия — проходить проверку прав, ограничений и бизнес-логики. Без этого перед нами действительно будет интерактивная визуальная симуляция, а не надёжная панель управления.


В собственном исследовании Runway 250 участников выполнили почти 7 500 сравнений сгенерированных реакции интерфейса Solaris и html-интерфейсов, созданных Claude Opus 5. Согласно внутренним тестам компании более 60% опрошенных выбрали интерфейсы Solaris, как более удобный.

Полных аналогов у Solaris нет, но близкие подходы уже существуют. NeuralOS генерирует кадры интерфейса Ubuntu после действий пользователя, ViMo предсказывает следующий экран мобильного приложения, а CUWM моделирует результаты действий в офисных программах. Сервисы вроде v0 и Lovable тоже создают интерфейсы по запросу, но генерируют обычный HTML и React-код.

Предыдущие системы воспроизводят или собирают заранее определяемое приложение, тогда как Solaris пытается порождать само пространство допустимых взаимодействий по ходу работы.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


💊 Сколько будет стоить молодость, если ИИ создаст лекарство от старости?

7 сентября Insilico Medicine опубликовала в Nature Biotechnology результаты анализа испытаний рентосертиба — препарата, созданного с помощью ИИ. У получавших его пациентов шесть алгоритмов оценки биологического возраста обнаружили изменения в сторону более «молодого» белкового профиля крови.

Почему мы выделяем эту новость? ИИ комплексно помог ускоренно провести реализацию фармацевтической идеи от биологической мишени до подбора молекулы и анализа клинических данных пациентов. Хотя лишь в будущем еще предстоит выяснить, научился ли ИИ мы замедлять само старение.

Что именно произошло?

Рентосертиб испытывали против идиопатического лёгочного фиброза — заболевания, при котором ткань лёгких постепенно рубцуется. В рандомизированном исследовании фазы IIa участвовал 71 пациент, лечение продолжалось 12 недель. Главной целью была оценка безопасности.

Новая работа посвящена образцам крови 42 участников, средний возраст которых составлял около 67 лет. Исследователи измерили 2 841 белок и применили шесть моделей, обученных связывать белковые показатели с возрастом или риском смерти.

Все 6 способов оценки определили у пациентов сдвиг в сторону более молодого профиля крови.


Начиная с четвёртой недели четыре возрастные модели показали снижение расчётного возраста пациентов примерно на 2,7–3,5 года. Это не означает, что людям вернули три года жизни: пока неизвестно, отражают ли изменения замедление старения или прежде всего это отражает улучшение состояния лёгких.

А что здесь сделал ИИ?


Его роль не сводилась лишь к обработке результатов.
Сначала ИИ-платформа Insilico помогла выбрать TNIK - белок-мишень, связанный с фиброзом и механизмами старения. Затем генеративная ИИ-система Chemistry42 помогла спроектировать молекулу, которая подавляет его активность. Один инструмент подсказал, какой биологический переключатель стоит отключить, другой — каким химическим ключом это сделать.

От выбора мишени до доклинического кандидата прошло около 18 месяцев. По сообщению компании, препарат уже перешёл в фазу III против фиброза. Это очень высокая скорость разработки препаратов такого класса.

Может ли подобное лекарство стать самым дорогим в мире?

Если когда-нибудь будет доказано не изменение показателей крови, а существенное продление здоровой жизни, то первый защищённый патентами препарат с таким эффектом получит колоссальный спрос. Отсутствие равноценных альтернатив и готовность состоятельных людей платить могут сделать стартовую цену чрезвычайно высокой.

Но наиболее обоснованная гипотеза пока другая: доказанное лекарство, продлевающее здоровую жизнь, способно стать одним из крупнейших фармацевтических продуктов по объему продаж в мире.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


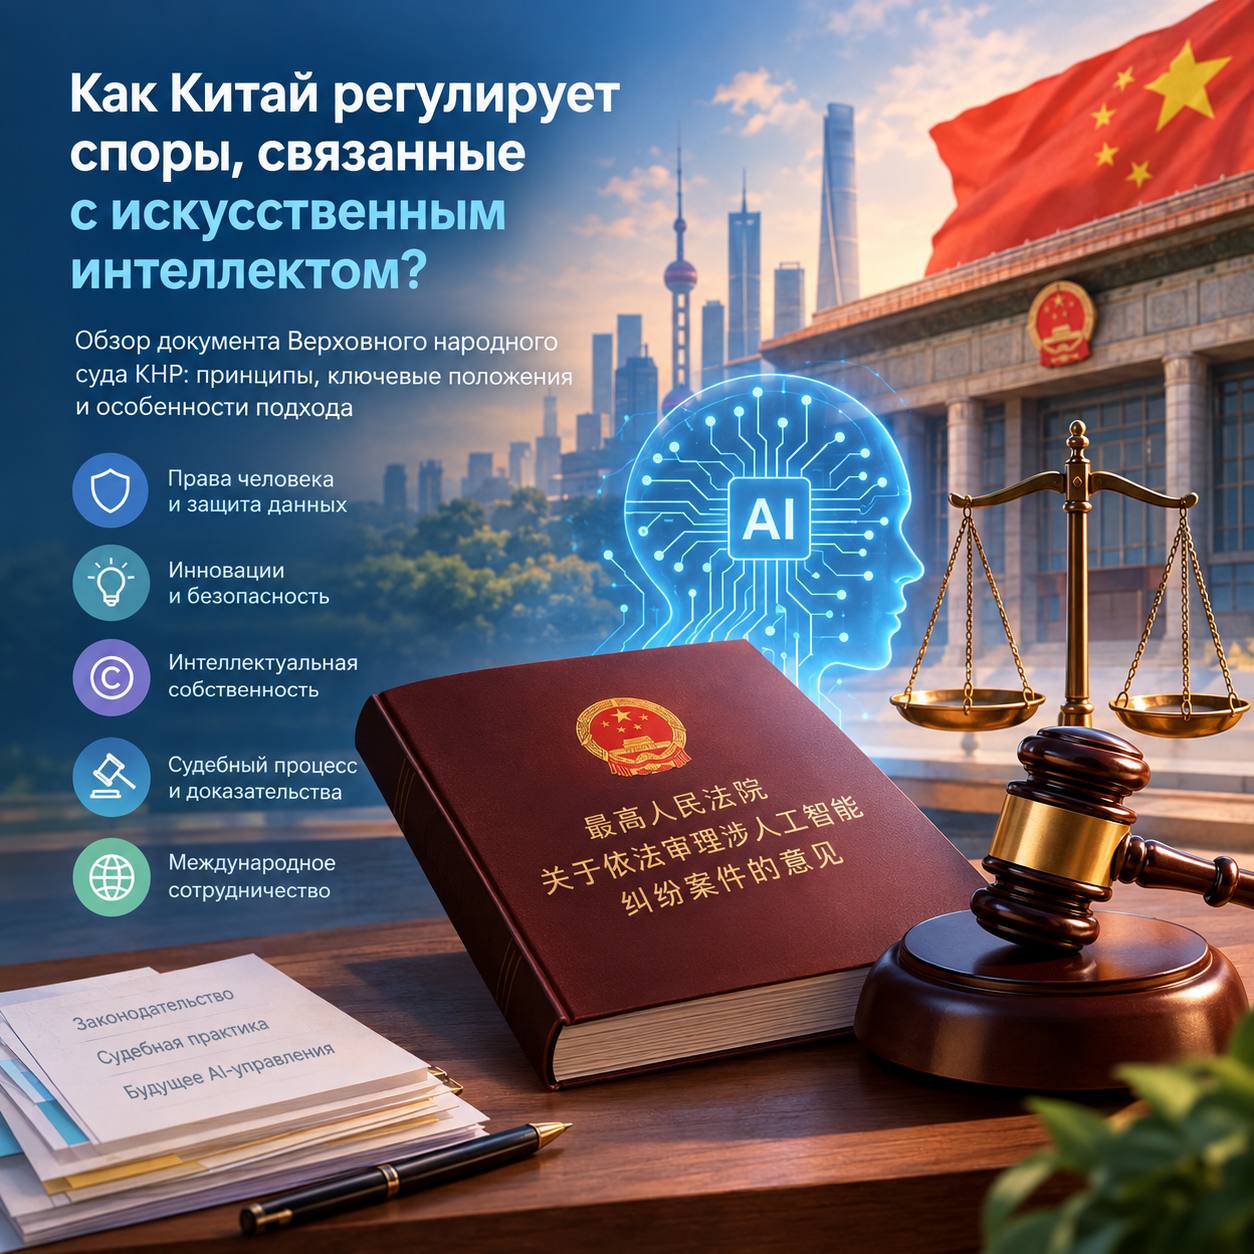
👩‍🎓 Китай начал судить искусственный интеллект

7 сентября Верховный народный суд КНР опубликовал «Мнение о рассмотрении в соответствии с законом дел по спорам, связанных с ИИ». Это первый в мире системный акт судебного толкования по делам, связанным с ИИ, изданный высшим судебным органом страны.

Основная цель документа — систематизировать и унифицировать судебную практику по делам, связанным с ИИ, в условиях отсутствия в Китае отдельного комплексного закона об ИИ. Поэтому документ опирается на уже существующее китайское законодательство: Гражданский кодекс, Закон о защите персональных данных, Закон об авторском праве и др.

И это, пожалуй, главная характеристика: Китай не ждет появления отдельного закона об ИИ, чтобы начать формировать судебные правила для ИИ. Он начинает это делать через действующие законы в конкретных судебных сценариях.


Документ состоит из 5 частей и 24 статей, в которых выделены 3 базовых принципа: человек прежде всего, регулирование не должно тормозить развитие ИИ, безопасность как нижняя граница.

Верховный народный суд КНР фиксирует: по умолчанию применяется ответственность при наличии вины. При определении вины суд должен смотреть на конкретный сценарий использования ИИ, степень автономности, потенциальный риск, масштаб ущерба, возможность предотвращения вреда, возможность пользователя предвидеть последствия.

Это одна из самых главных вещей в документе — ответственность пользователя, разработчика, поставщика не должна быть одинаковой во всех случаях.


Что особенно интересно в документе?


😀 Без согласия человека нельзя создавать и распространять его узнаваемый цифровой образ или голос.

😀 Суд отдельно рассматривает использование ИИ для злонамеренного раскрытия личности человека в интернете (доксинг).

😀 Уделяется внимание big data price discrimination — когда постоянному клиенту предлагают менее выгодные условия/цены из-за анализа его поведения.

😀 Если ИИ галлюцинирует, это не означает, что автоматически виновен провайдер.

😀 В спорах по авторским правам суд должен обращать внимание на "внутренности" ИИ-системы (промпты, источники обучаемых данных, тип ИИ-сервиса и т.д.)

😀 Суд различает open source и проприетарные модели — архитектура влияет на юридическую ответственность.

😀 Стороны судебного процесса могут использовать ИИ для подготовки к процессу, но они обязаны предупредить об этом суд и верифицировать результат.

Этот документ нельзя назвать просто "правилами для ИИ". По сути, Китай начинает юридически относиться к ИИ не как к единому субъекту, а как к сложной цепочке участников, где каждый получает свою долю ответственности.

Китай не пытается запретить "опасный ИИ". Поэтому этот документ интереснее обычного всеобъемлющего закона об ИИ: он показывает, как право начинает подстраиваться под технологию, которая сама принимает решения, генерирует контент, создает доказательства и сама является источником новых доказательств.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


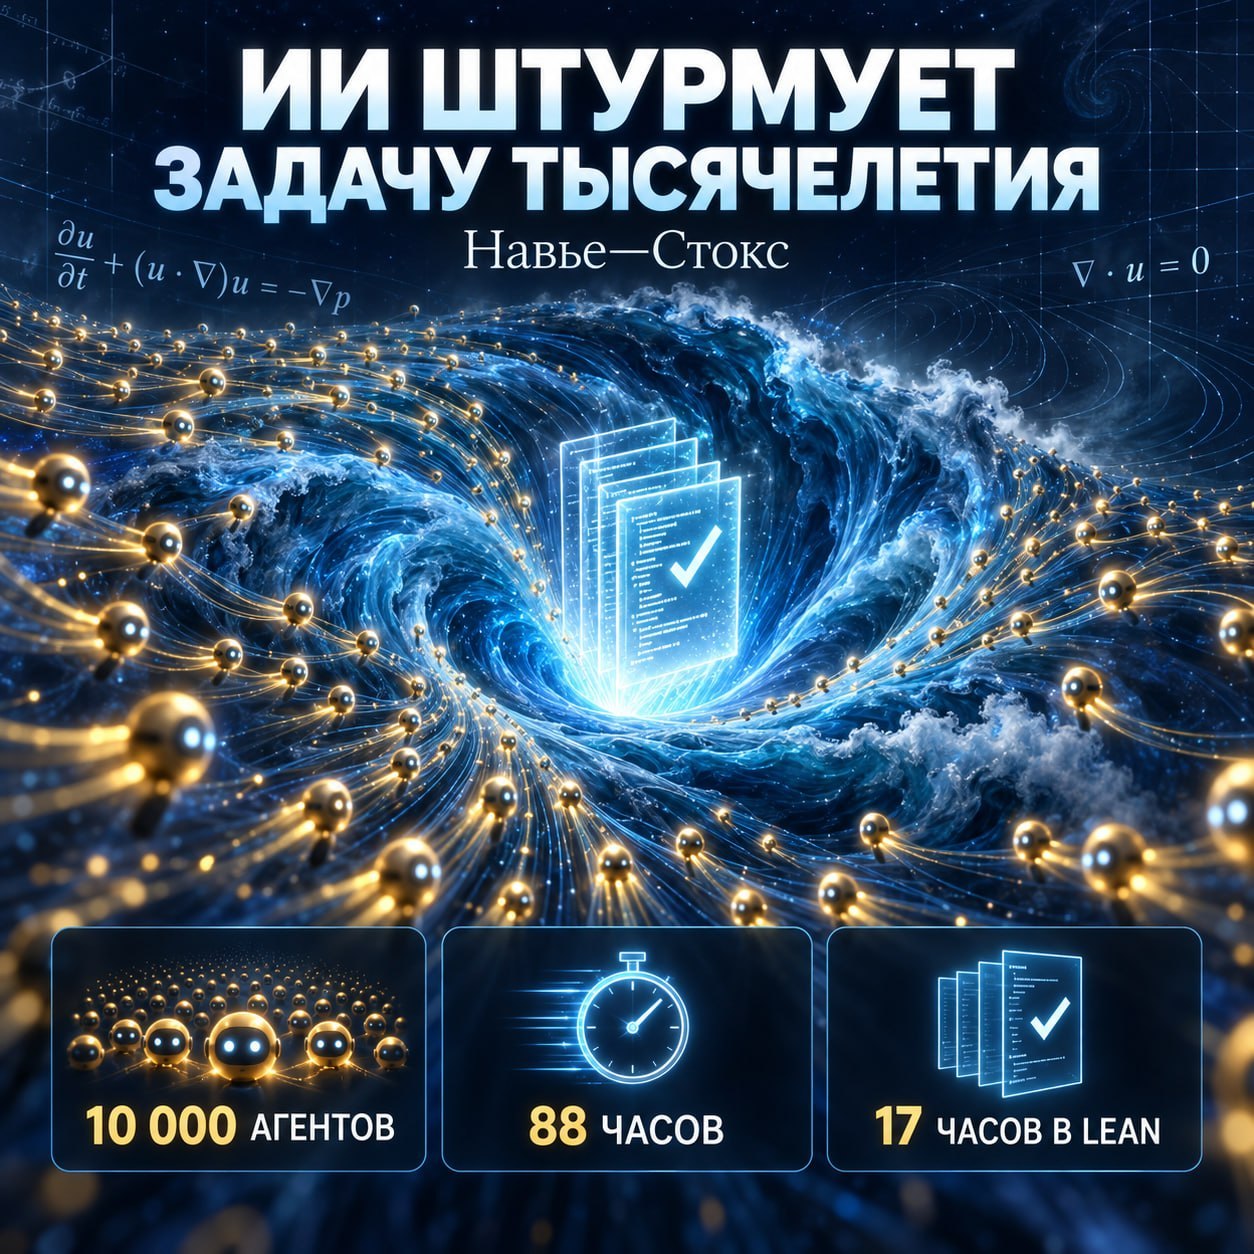
🌪 ИИ замахнулся на задачу тысячелетия

OpenAI опубликовала 166-страничное доказательство того, что трёхмерные уравнения Навье—Стокса способны породить сингулярность: поток вещества начинается совершенно гладко, но за конечное время скорость в крошечной области устремляется к бесконечности. Энергия при этом остаётся ограниченной. Если доказательство выдержит проверку, оно закроет одну из семи задач тысячелетия.

Масштаб вычислительного штурма был огромный. Около 10 тыс. агентов на ещё не представленной модели, которую OpenAI считает значительно сильнее, чем GPT-6 Astra, работали 88 часов. Они обменялись 2,7 млн сообщений и сгенерировали около 130 млрд токенов. Затем Astra за 17 часов перевела доказательство в Lean — язык, позволяющий компьютеру проверить логическую цепочку шаг за шагом.

Почему задача продержалась почти 90 лет?

Уравнения Навье—Стокса описывают движение воды, воздуха и крови. Записать их можно в несколько строк, но в трёх измерениях внутри потока возникает противоборство двух сил.

Вихри растягивают и усиливают другие вихри. Математики десятилетиями не могли доказать, кто победит: сглаживание этих нитей или каскад, способный за конечное время сжать движение до бесконечно тонкой и бесконечно быстрой иглы.

Компьютерная симуляция здесь не спасает. Она видит жидкость как сетку из конечного числа ячеек, а предполагаемая сингулярность прячется во всё меньших масштабах. Численная ошибка может как создать ложный «взрыв», так и скрыть настоящий. Нужна конструкция, охватывающая бесконечную последовательность масштабов и не оставляющая места для погрешности.

Именно такую конструкцию заявляет OpenAI: сжимающийся вихрь раскручивается всё быстрее, а тщательно подобранные колебания компенсируют возникающие ошибки так, чтобы внешняя сила оставалась гладкой.

Важно: это математически сконструированная сила, разрешённая официальными условиями. Результат не означает, что вода в реальном стакане внезапно разгонится до бесконечности.


По сравнению с недавним результатом Astra о разрывах между простыми числами, это успех совершенно другого класса.
Там ИИ улучшил числовую границу: заменил 240 на 186 внутри уже существующей теории. Это было настоящее новое доказательство и очередной рекорд.

Здесь же заявлено окончательное разрешение вопроса, специально выбранного как одна из глубочайших проблем математики. Разница примерно как между улучшением мирового рекорда и завершением экспедиции к вершине, которую до этого никто не покорял.

Если проверка устоит, это станет самым значительным математическим результатом, полученным ИИ.


Публикация ещё не прошла независимое рецензирование. Lean подтверждает корректность формализованной цепочки, однако люди должны проверить, что формальные определения точно соответствуют исходной задаче. Более того, по правилам Clay результат рассматривается только после публикации в квалифицированном издании, двух лет изучения и общего признания математическим сообществом.

История сразу осложнилась спором о приоритете

Тристан Бакмастер из NYU и Левент Альпёге из Anthropic почти одновременно обнародовали близкие результаты для уравнений Эйлера и других систем, развивая программу Диего Кордобы и Луиса Мартинеса-Сороа. Бакмастер утверждает, что Себастьян Бубек из OpenAI предлагал представить результат без Альпёге из-за его работы в Anthropic. При этом сам Бакмастер подчёркивает: он не знает, использовались ли их данные, и прямо не обвиняет OpenAI в заимствовании.

OpenAI отвечает, что ни исследователи, ни агенты не видели их неопубликованные материалы. Однако компания не может полностью исключить, что обезличенные данные от использования её продуктов ранее помогли улучшить модели. Математическое доказательство можно проверить. А вот восстановить происхождение идеи в мире, где учёные думают вместе с закрытыми моделями, будет гораздо сложнее.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


😄 Astra решила сложную задачу о простых числах

OpenAI представила доказательство нового результата ИИ в области простых чисел, полученного GPT-6 Astra: среди бесконечной последовательности простых чисел бесконечно много раз встретятся два соседних числа, расстояние между которыми не превышает 186.

Это новый рекорд. В 2013 году Итан Чжан впервые доказал, что такая постоянная вообще существует, получив верхнюю границу — 70 млн. Джеймс Мейнард вскоре уменьшил её до 600, а коллективный проект Polymath8 — до 246. Джулия Штадльманн предложила оценку 240.

Но важно понимать, чего Astra пока не доказала. Гипотеза о простых числах- близнецах утверждает, что бесконечно часто встречаются пары с разницей ровно 2: например, 11 и 13.

Новый результат Astra говорит лишь, что бесконечно много раз расстояние между соседними простыми будет не больше 186. Каким именно минимальным окажется этот повторяющийся разрыв, мы по-прежнему не знаем.


Почему такая простая на вид задача сопротивляется математикам?

Представьте бесконечный лист бумаги с натуральными числами. Решето позволяет вычеркнуть числа, делящиеся на 2, 3, 5 и другие простые. Но нам нужно доказать не просто существование очередного простого числа, а синхронно сохранить две соседние «дырки» в решете — причём сделать это бесконечно много раз.

Здесь возникает знаменитый барьер чётности: современные методы решета плохо отличают простое число от произведения двух простых.

Поэтому математики умеют доказать, что среди набора из нескольких десятков тщательно выбранных позиций обязательно найдутся хотя бы два простых, но пока не могут подобрать две конкретные позиции с расстоянием 2.

Каждое уменьшение границы — это не перебор дополнительных чисел. Требуется лучше понять распределение простых в арифметических прогрессиях, подобрать новые веса решета и доказать, что вся конструкция продолжает работать на бесконечности.

Astra объединила оценки Polymath8 и Штадльманн с новыми условиями факторизации и численной оптимизацией.

Насколько надёжно доказательство?

OpenAI опубликовала 39-страничную работу, численный сертификат и формализацию в Lean 4. Но называть её полностью машинно проверенным доказательством пока рано. Lean подтвердил логическую цепочку при трёх явно заданных аксиомах. Две опираются на известные результаты из литературы, третья включает численные оценки, проверяемые отдельной программой. Эти входные утверждения ещё не формализованы внутри Lean.

Не раскрыта полностью и степень автономности Astra: OpenAI пишет, что доказательство принадлежит модели, но не публикует исчерпывающий протокол человеческого сопровождения. Работа также ещё должна пройти независимую математическую экспертизу.

Как Astra выглядит на фоне других моделей?

Здесь полезно различать три уровня.GPQA Diamond проверяет знание физики, химии и биологии на уровне аспирантуры. Astra получила 96% против 93,7% у Claude Fable 5.1 и 95,3% у Gemini 3.8 Flash. Это впечатляюще, но всё ещё экзамен с известным ответом.

Terminal-Bench Science ближе к работе исследователя: нужно запускать код, анализировать данные, строить модели и проводить симуляции. Astra набрала 64,6%, Claude Fable 5.1 — 52,6%, Claude Opus 5 — 30%. Однако эти цифры опубликованы OpenAI, а условия запуска моделей могут различаться.

Самая строгая проверка — независимый FrontierMath Erdős с 68 открытыми математическими задачами и обязательным доказательством в Lean. В стандартном режиме Astra решила 2 задачи из 68 — около 3%. GPT-5.6 Sol, GPT-5.5 и две версии Claude не решили ни одной. В дополнительных, уже несопоставимых запусках Astra справилась с пятью задачами, но суммарные вычислительные расходы превысили $220 тыс.

Картина получается парадоксальная. Astra уже способна иногда производить настоящую новую математику и одновременно терпит неудачу примерно в 97% строго поставленных открытых задач.

Перед нами система, которая может войти в пространство нерешённых проблем, предложить новый ход и оставить после себя доказательство, доступное для проверки человеком и машиной.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться


🌟 NVIDIA предлагает собрать домашний дата-центр из компьютеров, которые уже стоят на столах

NVIDIA выпустила открытую бета-версию Personal AI Router — PAIR. Программа объединяет совместимые компьютеры одной сети в кластер и распределяет между ними запросы локальных ИИ-агентов.

Однако название немного вводит в заблуждение. PAIR — точно не физический роутер и пока не диспетчер выбора моделей, автоматически решающий, когда вызвать маленькую локальную модель, а когда облачную — Claude, Gemini или GPT. Это маршрутизатор запросов между вычислительными узлами локальной сети. И, к сожалению, PAIR пока не отправит особенно сложный запрос во фронтирную облачную модель автоматически. Для этого нужен второй слой — маршрутизатор между моделями, например NeMo Switchyard, NVIDIA LLM Router либо собственный шлюз с правилами и проверкой результата.

Как это работает?

Например, приложение ИИ-агента обращается к привычному локальному адресу Ollama или LM Studio. PAIR перехватывает запрос, проверяет, на каких компьютерах есть нужная модель и свободные ресурсы, отправляет его на один подходящий узел и возвращает результат. А для ИИ-агента вся сеть выглядит как единая точка входа.

PAIR не складывает видеопамять разных устройств, не делит одну модель между несколькими GPU и не превращает 14B и 32B в условную модель на 46 млрд параметров. Каждый запрос целиком выполняется на одном компьютере. Выигрыш возникает, когда агент порождает много независимых обращений: например, пять субагентов параллельно изучают разные документы, пишут код и проверяют выводы.

В демонстрации NVIDIA задача с пятью субагентами и Qwen 3.6 35B выполнялась на одном RTX Spark за 18 минут, а на трёх устройствах с PAIR — за 8 минут 48 секунд.


Можно ли установить PAIR сейчас?

Исходный код опубликован под Apache 2.0, доступны установщики для Windows, Linux и macOS. На старте поддерживаются Ollama и LM Studio, видеокарты GeForce RTX начиная с 20-й серии, RTX Pro, DGX Spark и компьютеры Apple с M4 и новее. Устройства находятся через локальную сеть.

Продукт пока новый. Планировщик учитывает наличие модели и загрузку очереди, однако ещё не умеет полноценно оценивать скорость GPU, объём свободной VRAM, «прогретость» модели, сложность запроса и ожидаемое время ответа. Поэтому неоднородный парк машин он может использовать неоптимально.

Для обычного API в ЦОД, vLLM или внешнего облачного сервиса штатной интеграции пока нет.

Таким образом, PAIR решает не всю задачу гибридного ИИ, а её нижний этаж: помогает эффективнее использовать локальное железо. Но именно из таких этажей постепенно складывается новая вычислительная архитектура — где агент получает не одну модель, а целую лестницу интеллекта и поднимается настолько высоко, насколько требует задача.

💬 Тест Тьюринга. События в сфере ИИ. Подписаться

20 ta oxirgi post ko‘rsatilgan.