Системный аналитик в финтехе/Orlova courses


Гео и язык канала: Россия, Русский
Категория: Telegram


Ирина Орлова, системный аналитик.
Пишу о работе в финтехе.
Преподаю. Курсы: "Инструменты системного аналитика", "System desing в решении задач системного аналитика".
https://t.me/vira_otzuv - отзывы
Для связи со мой @VinokurovaI

Связанные каналы
Гео и язык канала
Россия, Русский
Категория
Telegram
Статистика
Фильтр публикаций


Что должно быть в вашем резюме, чтобы его заметили?

Сейчас просто написать, что ты собирал требования, рисовал диаграммы и знаешь SQL, недостаточно. Автоматические отказы за 5 секунд это подтверждают.

Тогда что нужно?
А нужна конкретика. Это требование возникло потому, что аналитиков больше не ищут просто для освоения бюджета: если нельзя показать экономию, завтра подразделению просто не дадут денег.
Сейчас ищут человека на ПРОЕКТ.

Это значит, что хотят сэкономить на онбординге и сократить время интеграции нового сотрудника.
А у вас о проекте часто ничего не написано или написано очень бегло.
Если вы занимались расчётно-кассовым обслуживанием, СМЭВ, личными кабинетами, системой быстрых платежей или внешнеэкономической деятельностью, возможно, есть команды, которые ищут людей с подобным опытом. Насколько подробно вы это описали?

Конкретика помогает рекрутеру зацепиться за ваш опыт, делает ваше резюме «реальным» и отличает его от остальных.

Достижения. Вот тут кто в лес, кто по дрова. Кто-то ничего не пишет. А кто-то пишет, что благодаря своим ТЗ увеличил выручку компании на 20%. Расскажите мне, пожалуйста, как вы оценили эти 20% или рассчитали их? Вы видели бизнес-расчёты с точными показателями CAPEX и OPEX, которые вам предоставил продакт?
Вот то, что вы спроектировали 3 микросервиса, 20 методов API и восстановили документацию по определённому направлению, я верю, а вот к прибыли есть вопросы.

Обучение? Писать или нет? Обучение в Skillbox и других коробках - скорее минус, чем плюс. С одной стороны, человека, только что прошедшего обучение на аналитика, никто не хочет брать. Но, с другой стороны, если вы аналитик, который постоянно обучается, это плюс: где-то вы узнали больше о брокерах, где-то укрепили знания по архитектуре, а где-то прошли обучение по нейросетям. Это выглядит хорошо. Но, опять же, не для всех.

Фотография. Знаете, у меня есть знакомая, у которой своё HR-агентство, и она скрывает фотографии кандидатов и не показывает их работодателям. Почему? Потому что у работодателей может возникнуть негативная ассоциация из-за самых непредсказуемых паттернов: вдруг вы похожи на Васю, который обзывал в школе нынешнего руководителя направления аналитики?
С другой стороны, фото может быть и плюсом.

Все эти тезисы - это непросто теория. Это практика, протестированная мной.
Пруфы в комментариях.

Полезно — 🦅

А на ваш взгляд, что самое важное?

504 0 14 7 13

Вы знаете, что такое ПДн? Персональные данные. К ним относятся ФИО, номер банковской карты,  адрес и другие сведения, по которым можно узнать человека. По закону, есть допущенные к работе с ПДн люди/системы,  так называемые операторы ПДн. Еще данеые ПДн называют "чувствительными".

Поэтому одни системы используют ПДн для работы, и обрабатывают их, а другие просто передают. Те системы, которые просто перелают чувствительную информацию, не должны ее видеть.  Поэтому важно ограничивать доступ и не показывать лишнее.

В этом случае прибегают к маскированию данных. Думаю, про него слышали чаще, чем про санитайзинг. Маскировании чувствительных данных скрывает их полностью или частично: например, вместо полного номера телефона видно:
+7 * *-12-34.
.
Санитайзинг  — это процесс обработки данных, убирающмй из них чувствительную информацию. Например, система находит ПДн в сообщении или логе и заменяет их на
Х, [СКРЫТО] или другой шаблон. То есть в данным примере санитайзинг использует маскирование.
Под санитайзингом так же могут понимать безопасное удаление данных с носителей. Но в контексте логов и сообщений это обычно маскирование чувствительной информации.

Если есть, чем поделиться на эту тему жду в комментариях
Полезно -🦅


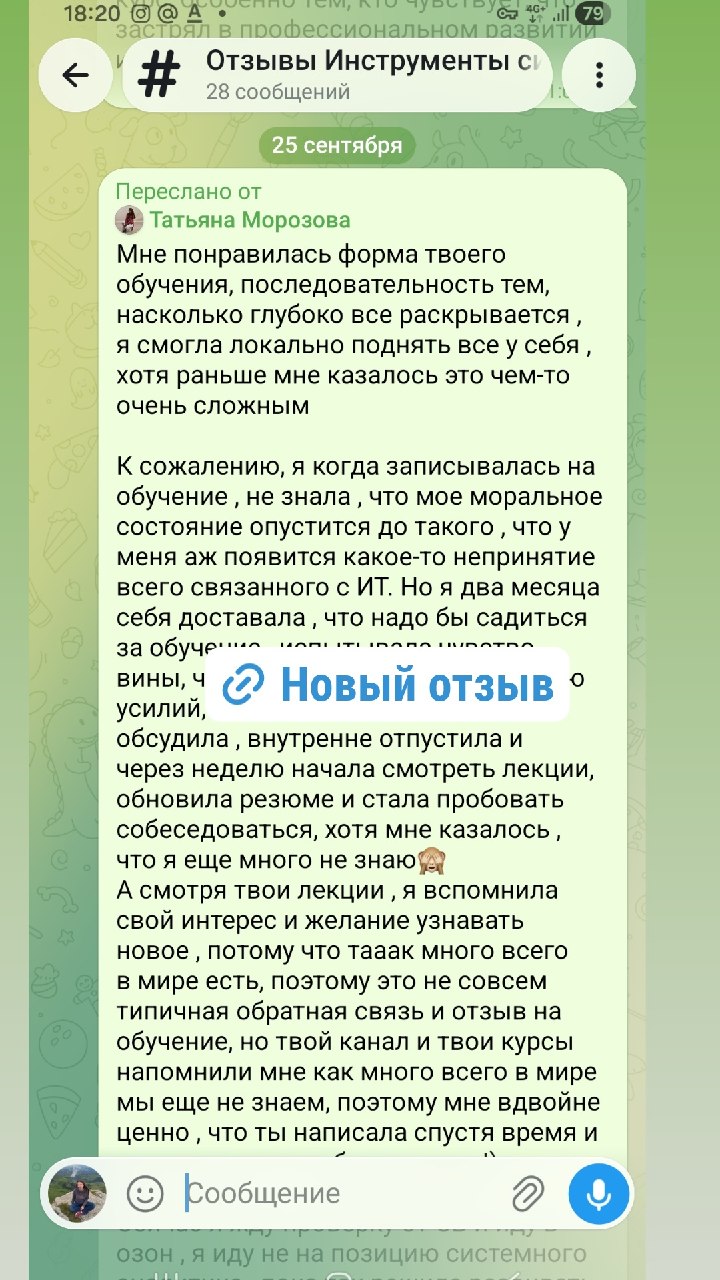
Ребят, мне неожиданно пришёл очень необычный отзыв.

На курс пришла очень активная девушка. Она очень хотела попасть на курс и записалась заранее. На первых лекциях задавала много вопросов, а потом пропала.

Я спросила, как она. Оказалось, у неё были сложности на работе и она столкнулась с выгоранием — поэтому и пропала. Онлайн-курс закончился, но доступ остался, и она прошла его по записям, самостоятельно.

Хорошо повторив теорию и подтянув технические навыки с помощью курса, она вышла на рынок. И скоро выйдет работать в Ozon.

Полный отзыв можно прочитать 'https://t.me/vira_otzuv/1/41' rel='nofollow'>тут.

И да, отзыв не совсем обычный: девушка написала, что её вдохновляли в том числе моё отношение к жизни и мой интерес. В целом это очень душевный отзыв. Просто когда делаешь свои продукты для себя и от души, получаешь в том числе и такую обратную связь.


Поздравляю всех с днем системного аналитика! Адекватных заказчиков и легких задач!

Викторину на сегодня заканчиваю. Про все вопросы, которые обсуждали сегодня, рассказываю на моем курсе, который стартует завтра.


Вопрос про Kafka. Если один из участников группый потребителей прочитал и обработал сообщение, может ли другой участник группы потребителей сделать тоже самое?
Опрос
  •   Да
  •   Нет
  •   Не знаю
45 голосов


Какой метод идемпотентный?
Опрос
  •   Patch
  •   Put
  •   Не знаю
102 голосов


Можно ли Post использовать для удаления пользователя?
Опрос
  •   Да
  •   Нет
  •   Не знаю
123 голосов


Ребят, привет! У меня к вам архитектурный вопрос. Вы пришли на проект, и вам говорят: «Вот тут у нас 5 микросервисов, но у них всех один UI и одна общая БД». Как вы думаете, в чем подвох?


 Забыла пароль от удалёнки

Ну что? Я вернулась сегодня в час ночи, а утром уже первый рабочий день.

Утренний дождь сразу напомнил, что я не в Анталии и даже не в Стамбуле.

И первое, что я поняла,  я настолько отдохнула, что забыла пароль. Вот так просто. Хотя на удалёнке, конечно, сложно взять и его восстановить. В моменте даже уже была готова ехать в офис. Пересмотрела все записные книжки, у меня их 3 , и не нашла нигде новый пароль. А поменяла я его за 3 дня до отпуска.

Последний раз забывала пароль в 2019 году после почти месяца в Тае.

Но теперь всё хорошо. Все мессенджеры прочитаны, планы на текущую неделю написаны.И знаете, что я первым делом сегодня сделала, подключившись? Заполнила заявление на новое обучение: распечатала, отсканировала. А ещё узнала, когда смогу сдать тестирование по обучению, которое закончила до отпуска.

Да, мне 37, и я постоянно учусь. Честно говоря, когда мне было 17 лет и я закончила школу с золотой медалью, я наивно думала, что всё основное уже выучено. В моменте даже хотела сжечь часть своих конспектов на поле за домом. Представляла, как это всё будет гореть синим пламенем, но так и не решилась, просто выкинула. На первом курсе, правда, очень об этом пожалела.

Честно говоря, я много в своей жизни просиживала за книгами, учебниками, конспектами, статьями, и мне далеко не всегда это нравилось. Вернее, когда знаешь, что все гуляют, а ты просиживаешь за учебниками, мне такой расклад не нравился. Отдыхать гораздо приятнее.

Но всегда нравился результат от обучения новым навыкам. Нравится пластичность мозга, возможность погружаться в новое, не костенеть. Интересоваться. Нравится повышение в заработке, появляющаяся с этим уверенность.

Чем больше учусь, тем больше понимаю, как мало знаю. В мире же столько всего.Этот год я начинала с небольшого курса по родительскому авторитету. Училась рисовать картину маслом. Что говорить, даже приседать правильно пришлось учиться, ничего само не пришло. Скоро получу корочку по архитектуре.

Как-то мой начальник мне сказал, что постоянно учится: просто понемногу, но регулярно. А я обычно учусь наскоками, периоды когда впихиваю в мозг новую информацию сменяются временами, когда я даю себе отдохнуть. В целом, подход у каждого свой.

Похоже, отпуск заканчивается, а учёба - никогда.

А вы как обучаетесь?Постоянно - 😜
или
Наскоками - 🦅


Привет, ребята. Задумалась тут в отпуске о соотношении в жизни вариантов сделать сам/делегировать.

Начну с того, что я активный сторонник делегирования)) По крайней мере, когда речь идёт о домашних делах, таких как уборка и готовка. Во-первых, не буду кричать душой у моей помощница по дому получается это лучше чем у меня)) Во-вторых, в освободишься время я могу заняться тем, что мне интереснее и получается лучше - блогом, работой, семьёй. Кстати, с финансовой точки зрения такой обмен тоже получается, как минимум, не в минус.

В тоже время отпуска я всегда планирую сама. Потому что, как бы внимательно тебя не слушал турагенту, наиболее подходящий вариант для себя любимой подберешь только ты)
Это и оптимальный по цене/качеству отель с детским клубом, куда ребёнок сам улетает утром, и регулярный рейс с удобной пересадкой, позволяющей прогуляться по новому городу, да и новое необычное направление отпуска тоже.

Обратная сторона, что на правильный выбор уходит много времени: и отзывы об отелях нужно почитать на Тripadvisor и Google, и выбрать платформу бронирования - у букинга больше предложений и нет альтернативы на некоторых направлениях, у российских агрегаторов бывают хорошие предложения  на отдельные отели и можно платить миром без конвертации. Билеты, кстати, я рекомендую по возможности брать на сайте авиакомпании. Меньше заморочек, если случаются отмены/переносы. Одним словом, очень много времени уходит, но сейчас плавая в ласковых волнах Средиземного моря, я этот результат чувствую прямо своей кожей))

На самом деле, дилема делегировать/сделать самому распространяется на все области нашей жизни. К примеру, всю информацию, которая есть в моих курсах вы можете найти и сами почитав инструкции к програмным продуктам, хабар, посмотрев ютуб и так далее. И даже, наверное, разберётесь в вопросе более глубоко, максимально пропустив его через себя. Другое дело, что если вы собираетесь разобраться качественно, времени у вас уйдёт много. У меня на знакомство со всеми вопросами, которые входят в курс "Инструменты системного аналитика" ушло пара лет.

Ребята, а вы какого баланса придерживается в варианте все сами или делегируете? Нанимаете помощников по дому или репетиторов/тьюторов? Сами планируете отпуск или получаете турагентам и какой в итоге результат? Пишите в комментариях.

Все самостоятельно - 🙈
Делегирую - ❤️


Часто задаваемые вопросы по курсу.

1. В какое время занятия?
Занятия онлайн (вебинары, не записи): понедельник, среда в 18:10 с 23.09 по 02.11.

2. Можно ли проходить самостоятельно в записи?
Конечно, все вебинары выкладываю на следующий день после проведения в Zenclass.

3. Что такое Zenclass и как там выглядят материалы?
Это аналог Геткурса. На следующий день после вебинара выкладываются запись и текстовые материалы. К каждому уроку даются домашние задания.

4. Если не успеваете сдать домашки в течение курса, можно потом сдать?
Да, я даю после курса 1,5 месяца на сдачу домашних заданий, ваши вопросы и нахожусь на связи.

5. Насколько останутся материалы?
6 месяцев после окончания курса.

6. Можно посмотреть подробную программу по курсу?
Да, полностью расписанная программа по дням тут вместе с сылкой на примеры записей со мной.

7. Можно разделить оплату?
Да, можно разделить оплату на 3 части, по 1 платежу в месяц, в течение 3 месяцев. Это рассрочка от меня.

8. Будет ли сертификат после курса?
Да, приложу пример в комментариях.

9. Кто преподает?
Преподаю я, действующий главный системный аналитик в финтехе. Работаю в банках 15 лет, кандидат наук, с 2018 года начала работать с ЦФТ в ПСКБ банке (в те времена ЦФТ еще отправлял своим клиентам на Новый год календарики с медленно раздевающимися девушками. Календарь был настолько запоминающимся, что потом через много лет начальник в Альфе тоже про него рассказывал; в общем, равнодушными в тот год ЦФТ никого не оставил). Работала еще аналитиком в Альфе, Сбере, ПСБ. Сейчас я работаю на проекте с нуля по биометрии.

10. В чем отличие от других курсов?
Ключевое — это комплексное рассмотрение одного рабочего кейса. Это не один какой-то скилл типа REST API, это рассмотрение целого реального рабочего проекта со всех сторон. Небольшая камерная группа. Возможность приходить на живые уроки и задавать свои вопросы, в том числе после собеседований, с вашей работы. Любые вопросы приветствуются. Я за живые обсуждения.

11. Есть примеры спецификаций, которые получались?
Да, вот тут.

12. Кто проходил курс?
Проведено 3 потока. Первый был в декабре 2025 года. Приходили аналитики от 0,5 года до 8 лет опыта в ИТ.
Был еще парень с 'https://t.me/vira_otzuv/1/5' rel='nofollow'>нуля, но очень умный. Была студентка-джун, ей понравилось, и она прошла у меня еще второй курс по 'https://t.me/vira_otzuv/21/28' rel='nofollow'>задачам.
Кому-то с опытом в год было сложно, но полезно (отзыв 'https://t.me/vira_otzuv/1/18' rel='nofollow'>тут), для кого-то наоборот с таким же опытом курс стал 'https://t.me/vira_otzuv/1/40' rel='nofollow'>бустом.
Были бизнес 'https://t.me/vira_otzuv/1/19' rel='nofollow'>аналитики.
Были фулстек-аналитики. Были аналитики с опытом 3-4 года. Был фулстек-аналитик с опытом более 6 'https://t.me/vira_otzuv/1/38' rel='nofollow'>лет. Был аналитик с опытом работы с монолитами и БД СА 8 лет в ИТ (отзыв 'https://t.me/vira_otzuv/1/37' rel='nofollow'>тут). Была девушка-лид-аналитик из Ташкента, она просто для себя пришла систематизировать знания. Пост о том, кому подойдет писала тут.


Я еще в отпуске: температура +30, вода +26. Неожиданно, но отель прям очень понравился. Но давайте всё же вернемся к техничке.

Я тут с вами обсуждала NGINX, канарейку и версионирование.

То, что можно отправлять запросы на разные endpoint'ы с версией 1 и 2, понятно. Но зачем?

Как-то мою знакомую даже просили на собеседовании рассказать, в каких случаях стоит поднимать версию. Я разбирала мажорную и минорную версии и не только это.

Самый простой пример с версионированием — это мобильные приложения.

Вы всегда скачиваете новую версию приложения или пользуетесь старой, потому что так привычнее и удобнее?
Так вот, есть пользователи, которые всегда скачивают новую версию и любят новинки, а есть те, кто не любит обновляться.

Получается, и для тех, и для других какое-то время нужно поддерживать работу разных версий приложения.
Например, раньше API принимал номер телефона одним полем, а в новой версии вы решили изменить контракт: добавить страну и по-другому передавать номер.
Старые приложения об этом не знают. Если просто изменить старый endpoint, можно сломать работу старых клиентов.

Поэтому появляется v2 — новый контракт, а старый v1 какое-то время продолжает работать.
И тут возникает интересный вопрос: а сколько вообще должна жить старая версия API?


Для мобильного приложения это может быть довольно долго, потому что пользователи не обязаны обновляться сразу.

А теперь самое интересное: как вообще понять, кому отправлять v1, а кому v2?

Самый простой вариант — указать версию прямо в URL:
/api/v1/payment
→ сервис версии 1
/api/v2/payment
→ сервис версии 2
В таком случае маршрутизация довольно очевидная: NGINX или API Gateway смотрит на URL и отправляет запрос в нужный backend.

Но версию можно передавать и иначе — например, через HTTP-заголовок:
API-Version: 2
Тогда Gateway смотрит на заголовок и в зависимости от его значения выбирает нужную версию сервиса.

Есть и еще один вариант — определять версию по клиенту. Например, мобильное приложение версии 5.10 работает с API v1, а приложение 6.0 — уже с API v2.

А дальше появляется канареечный релиз.
Допустим, v2 только что выпустили и мы не хотим сразу отправлять туда всех пользователей. Тогда можно сначала направить на v2, например, 5% трафика, а остальной на v1. Если всё хорошо, увеличиваем долю трафика: 10%, 25%, 50% и так далее.

То есть здесь уже две разные задачи:
Версионирование отвечает на вопрос:
«Какой контракт API должен использовать клиент?»
Маршрутизация отвечает на вопрос:
«Куда отправить конкретный запрос?»
А канареечный релиз позволяет постепенно переключать трафик на новую реализацию и контролировать, что происходит после переключения.

А еще есть даты релизов и обновлений мобильного приложения, в которые стоит успевать командам. Нужно всегда помнить, что в банковское приложение каждый день обновление не выкатишь.

Вот так, кратко и ясно, зачем нужно версионирование и почему после появления v2 вопросы к реализации не заканчиваются.

Сталкивались с версионированием?
Да - 👍
Нет - 🙈

Полезно - 🦅


Ребята, привет. Снова напоминаю о своём курсе Инструменты системного аналитика. Записаться на курс можно до 22.09, а сам курс начнётся 23.09. Осталось три свободных места, записывайте пока не разобрали))

В своё время для меня стало неожиданностью, что на курс пришли ребята с солидным опытом в it в целом. Почему курс оказался им полезен, можно прочитать ('https://t.me/vira_otzuv/1/37' rel='nofollow'>тут, 'https://t.me/vira_otzuv/1/14' rel='nofollow'>тут). По горячим следам решила порасуждать о том, кому ещё курс может быть полезен.

1. Бизнес-аналитикам, перешедшим или переходящим в системный анализ. Они смогут структурировать свои знания, продумать, как проектировать микросервис, определить его границы, получат примеры различных ТЗ, повысят технические скиллы и вот это понимание, куда копать и что делать с непонятной таской, почувствовать себя увереннее на проекте - отзыв по такому кейсу 'https://t.me/vira_otzuv/1/38' rel='nofollow'>тут.

В итишке все роли постепенно усложняются, требований становится больше: от бизнес-аналитиков требуют понимания системных требований, от СА просят и понимание бизнеса и одновременно архитектуры, безопасности, в финтехе ещё нужно умение работать с нормативной базой. Я постоянно на новом проекте, например, общаюсь с архитекторами, безопасниками и сделала себе доступ к Консультант Плюсу.

Спрогнозирую, что через пару лет останутся практически или фулстек-аналитики или СА-архитекторы. И в таких условиях БА оказываются в той же ситуации, что когда и я: понимание бизнес-требований замечательное, а вот опыт разработки и применения программных средств системного анализа страдает.

2. Системным аналитикам, которые хотят перейти в финтех из других направлений. Почему полезно: в финтехе, конечно, всё не так радужно как пару лет назад, но всё ещё относительно стабильно благодаря постоянно появляющимся требованиям регулятора. Кстати, тут недавно цифровой рубль вывели, всё это тоже финтех-задачки. При этом разница между разными направлениями СА существует и опыт разработки именно в финтехе будет нелишним как на собеседовании, так и в дальнейшей работе даже опытным системным аналитикам.

3. Системным аналитикам, работающим в поддержке или со старым стеком технологий, монолитами, 1С, миграцией.

В своё время я работала с АБС EQUATION от IBM. И это я вам скажу совсем другой мир: зеленый экран, опции, SQL запросы в интерфейсах, Soap, IBM MQ, 10-значные счета, мнемоники.

Ещё я как-то работала с АБС от ЦФТ и в целом с ЦФТ, всё это тоже другой мир.
Работа с монолитами, пусть и модульными, существенно отличается от микросервисной архитектуры. Из старого болотистого проекта перейти в современный интересный проект крайне сложно. Хотя может кажется: зачем? С одной стороны спокойно и комфортно. Но с другой стороны роста и развития особо нет и з/п в таких проектах меньше обычно, ощущение, что вязнешь. Хотя, конечно, опыт копится, но настолько специфичный, что применить его на другом месте вряд ли получится.

Я в своё время специально искала краткосрочный небольшой проект только чтобы получить опыт в современном проекте и познакомиться с актуальным стеком технологий и скажу вам: этот небольшой проект дал мне действительно хороший буст, даже больше чем я ожидала от него.

4. Начинающим аналитикам. Например, у меня был на курсе очень активный парень, постоянно задавал кучу вопросов. После курса он сменил проект и поднял свою з/п на 50%, вот его отзыв ('https://t.me/vira_otzuv/1/40' rel='nofollow'>1, 'https://t.me/vira_otzuv/1/11' rel='nofollow'>2) и 'https://t.me/vira_otzuv/1/16' rel='nofollow'>кейс.

Как вы считаете: усложняются ли профессии в ИТ?
Да, требований всё больше - 😜
Нет, всё также - 👍


Всем привет. Про API GW и зачем он нужен проговорили выше. Также обсудили основные паттерны API GW.

Отдельно проговорили про NGINX. У него ещё есть функция балансировки.
Вот тут возникает вопрос: что будем балансировать и зачем? Если с акробатами и балансировкой всё понятно, то тут, мне кажется, стоит обсудить подробнее.

Начнём слегка издалека.
Вспомним про масштабирование. Часто раньше спрашивали, что такое горизонтальное и что такое вертикальное масштабирование на собеседованиях.

Напомню: вертикальное масштабирование — это когда добавляются ресурсы имеющемуся серверу (ядра, память); горизонтальное масштабирование — это добавление количества экземпляров.
Например, вместо одного микросервиса B2C у вас будет три таких экземпляра. И вместо 1000 запросов в секунду можно будет на B2C отправлять 3000 запросов в секунду, но главное — на разные экземпляры.

Кто будет определять, куда отправлять запрос?
Вот так и подошли к балансировщику, который по какому-то заданному алгоритму распределит запросы.

При этом есть разные варианты, кто будет выполнять балансировку.
Может после API GW стоять отдельно балансировщик = Load Balancer (или встроенный механизм балансировки Kubernetes), может быть общий компонент, который выполняет функции API GW и LB. Всё зависит от конкретных решений, которые выбрали в той или иной организации при проектировании архитектуры.

Варианты алгоритмов, по которым LB может распределять трафик:

Статические алгоритмы
Балансировщик распределяет трафик согласно заданным правилам.
Round Robin
Распределяем просто по очереди:
1-й запрос → server1
2-й запрос → server2
3-й запрос → server3
Weighted Round Robin
Например:
server1 — вес 5
server2 — вес 3
server3 — вес 2
Тогда server1 получит 50% трафика, server2 — 30%, server3 — 20%.
IP Hash
По IP пользователя считаем хеш и направляем запросы на один и тот же сервер. Это позволяет сохранять привязку клиента к серверу, но при изменении набора серверов распределение может измениться.
Динамические алгоритмы
LB следит за актуальной нагрузкой на серверы и принимает решения на основе этой информации.
Least Connections
Отправляем туда, где сейчас меньше всего активных соединений.
Weighted Least Connections
Учитывается и вес сервера, и количество активных соединений.
Подходит при неравномерной нагрузке и разной производительности серверов.
Least Response Time
Отправляем туда, где сервер отвечает быстрее всего (на основе измерений response time).

Если говорить про System Design интервью, то обычно балансировщик отдельно не рисуют. Можно проговорить, что нарисованные API GW и LB находятся в одном квадрате и назвать его адаптер или коннектор.

Были у вас кейсы с балансировкой?
Да —👍
Нет —🙈
Полезно -🦅


Всем привет! Всех с понедельником. Обещала вот тут показать какие спецификации получаются у ребят у меня на курсе. Выкладываю одну из них. Здесь только часть сделанного, отдельно делалось ТЗ на интеграционную шину, OpenAPI спецификация, работа в Archi, С4, работа с XML-документами. В новый курс я добавляю ТЗ на кафку и grpc.


Недавно у меня состоялся интересный разговор с коллегой тим лидом аналитиков по поводу ИИ. Коллега признал, что на настоящий момент ИИ помогает ему в работе больше, чем два новичка мидла вместе, которых недавно взяли на проект.

Действительно, ИИ все глубже проникает в нашу повседневную жизнь и рабочие процессы. В связи с этим, актуальнее становятся вопросы цифровой гигиены при работе с ИИ.

Про истории типа туристы приехали к несушествующей достопримечательности или в несушествующий город и так далее, даже говорить не буду. Думаю, все в этом чате понимают необходимость валидации результатов, полученных с помощью ИИ.

Меня больше зацепили три достаточно свежие новости, связанные с ИИ и конфиденциальностью.

И так первая: Топ-менеджера московской компании уволили за загрузку документов в DeepSeek (https://www.cnews.ru/news/top/2026-07-27_top-menedzhera_odnoj_iz_moskovskih). История достаточно ниодназначная, и здесь загрузка данных в ИИ была скорее поводом избавиться от ненужного сотрудника и невыплачивать компенсацию при увольнении. Я бы отметила юридическую сторону вопроса: суд признал загрузку файлов разглашением информации.

История вторая: Anthropic заблокировало применение своих инструментов ИИ для разработки биологического оружия и кибератак (https://news.sky.com/story/anthropic-blocks-effort-to-use-ai-to-research-potential-biological-weapons-13584258). Несомнено, прекрасная новость, свидетельствующющая о социальной ответственности компании. Но я бы обратила внимание на другой аспект данной ситуации: степень контроля компании за трафиком. Все запросы отслеживаются и обрабатываются. Главное, чтобы в них содержалось, что -то интересное, а инструмент, конечно, есть.

Ну, и наконец третья новость. ИИ решил задачу тысячелетия - уравнение Навье-Стокса. Но есть нюансы... В этой истории сам черт ногу сломит, подробнее можно прочитать здесь (https://habr.com/ru/articles/1079940/). Я бы обратила внимание на конкретный момент в пресс-релизе OpenAI: компания не может исключить, что анонимизированные данные из чата математиков решивших уравнение могли попасть в тренировочный датасет модели-первооткрывателя решения уравнения. Так что кто был первым человек или машина неясно.

По сути, это означает, что любые данные, которые вы загружаете в ИИ могут быть использованы ими в своих целях.

Честно говоря, я далека от паранои и подозреваю, что большинство подписчиков данного чата не занимаются решением задач тысячелетия. В тоже время, быть аккуратнее и соблюдать цифровую гигиену в работе с ИИ стоит.  Особенно в наше несамое простое время https://www.cnews.ru/news/top/2026-05-18_tsentrobank_rossii_zafiksiroval

Правила при работе с ИИ над которорыми стоит задуматься:

1. Если платформа позволяет, стоит отключать сохранение истории чатов и использование ваших диалогов для дообучения нейросети. Очевидный и немного наивный совет, но лишним точно не будет.

2. Работать с ИИ в пустом профиле/браузере. В этом профиле/браузере не входить в банк, госуслуги, рабочую почту и рабочие репозитории. Это не 100% защита, но и сделать это элементарно.

3. Для рабочих вопросов и документов, можно развернуть локальную версию (хотя точно ли этого будет достаточно?). Стоит использовать обезличенные данные. НИКОГДА не грузить конфидециальную рабочую информацию в общие ИИ.
"Да что там интересного! И так прокатит. Никто не заметит!" и тому подобное, как мы уже обсудили сегодня, может иметь вполне конкретные юридические последствия.

ИИ в нашей жизни плотно и навсегда, а значит применение цифровой гигиены при работе с ним столь же актуально как и чистка щубов каждое утро. А какие правила цифровой гигиены выработать вы для себя?
И всегда ли их соблюдаете?

У меня есть локальная версия- 👍
Пользуюсь онлайн версией, мне все равно- 🙈
Не использую ИИ- 😜
#ИИ


Ребята, много вопросов в личке по поводу подробной программы курса. Поэтому выкладываю её на всеобщее обозрение в группу.

23.09 Типология платежей и их виды. Платежные платформы. Введение в домен системы быстрых платежей. Функции и задачи АО "НСПК". Знакомство с официальной документацией АО "НСПК". Задаем бизнес-требования к разработке нашего микросевиса. Определяем структуру эпика и ключевые пользовательские сценарии.

28.09 Инструмент PlantUML/Mermaid: строим диаграмму последовательности для микросервиса регистрации, обсуждаем первично API Gateway, коннекторы, ESB (интеграционную шину), сервисы шифрования. Даю шпаргалку для PlantUML (коды для основных команд и процессов, с ними вашидиаграммы будут выгдядить наглядно и профессионально).

30.09 Виды интеграций (gRPC, RPC, GraphQL, WebSocket, Webhook, callback, REST, SOAP). Выбираем, что лучше применить в кейсе - внутренние обсуждеие. Рассматриваем пример ТЗ на gRPC и REST.

05.10 Изучаем Swagger. Локально поднимаем через Docker Swagger Editor и в нем пишем спецификацию в OpenAPI для нашего микросервиса. Разбираем типы данных в JSON, чем отличаются JSON и JSON Schema.

07.10 Тестируем полученные методы в Postman/Swagger UI и Insomnia. Рассказываю про среды, коллекции и авторизацию.

12.10 Рассказываю про XML/XSD/XML Schema. Изучаем SoapUI. Определяем где может быть SOAP в нашем кейсе, тестируем в SoapUI XML. Разбираем пример ТЗ на интеграционную шину. Пишем XML и JSON для интеграционной шины.

14.10 Подробный разбор теория по Kafka (офсеты, коммиты, гарантии доставки, группы потребителей, ключи, настройки). Мои видео по данной теме можно посмотреть здесь: https://youtu.be/m2ddCdCtYq8?si=4DDcS31VTPU4PxEQ
https://youtu.be/QWO1cUNZBIk?si=ZWTMHYvJPtUFVEaY

19.10 Локально поднимаем Offset Explorer и применяем все, что я рассказала про Kafka на практике. Обсуждаем, может ли Kafka заменить интеграционную шину и как это можно реализовать. Разбираем пример описания топика по Kafka. Готовим ТЗ на топик Kafka. Видео про Kafka и ESB тут https://youtu.be/8qYakA75yy8?si=M2s4r7EjRT2Rjga-.

21.10 Устанавливаем DBeaver. Смотрим основной функционал. Рассказываю про простые и составные индексы/внешние и внутренние ключи, parentId/childId/UUID/ транзакции/ACID/SAGA/ERD. Проектируем БД для нашего микросервиса, определяем ключи, индексы и связи.

26.10 Определяем, нужно ли включить логирование для микросервиса, как это сделать и на каком уровне. Подключаемся к тестовому стенду Kibana, смотрим там логи, придумываем алерты для микросервиса. Дополнительно рассказываю про Zipkin и Grafana.

28.10 Разбираем C4/диаграммы представления 4+1 / ArchiMate / Archi. Рассказываю, как работать с архитектурными схемами, строим их для нашего микросервиса. Показываю, как работать в Archi. Недавно записывала видео по этой теме https://youtu.be/hnm-LzeF9S0?si=u024ZMzLuK_Nnfio

02.11 Завершающий вебинар, посвященный спецификации на микросервис. Обсуждаем какие разделы в спецификации обязательные, а какие опциональные. Подробнее обсуждаем раздел кэширования и безопасности.  Рассказываю про сертификаты, токены, проксирование. Дополнительно обсуждаем нефункциональные требования к микросервису. Поднимаемся на уровень выше и обсуждаем, что должно включать в себя описание домена.

Программа очень насыщенная. Благодаря тому, что группа небольшая все слушатели активно включены в процесс работы. В каждом занятии, после каждого раздела оставляю время на ответы на вопросы.

Постараюсь в ближайшие дни также выложить в канал образец спецификации, которая должна получиться у Вас по итогам курса.


Вот еще визуальное представление: что делает API Gateway

711 0 16 2 10
Показано 20 последних публикаций.