Maxim.ML - канал


Channel's geo and language: Russia, Russian
Category: Technologies


🟥 Machine Learning Team Lead
📢 Рассказываю о жизни в IT в целом и о machine learning в частности
🤖 Генератор контента для обучения AGI
✉️ лс тут: @Maxim_ML

Related channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


У меня было много образовательных активностей: преподавал школьникам, студентам и олимпиадникам, сейчас вот блок Агентов в МФТИ. И вот впервые собираю материал для руководителей направления продуктов 🤓

Школьнику нужно объяснить, как устроено. Студенту нужно дать инструмент и проверить, что он работает. Олимпиаднику - показать приём, который снимает класс задач. Руководитель продукта приходит с другим запросом: что изменится в моих метриках и что мне делать в понедельник. Про "как работает агент" он и так читал.

Курс организует и собирает Никита в MLinside: 7 занятий по 1,5 часа, старт 27 октября. Я на первом занятии показываю вот что: собираем агентное рабочее место и процесс от беклога до бизнес-требований и ТЗ. Дальше - клиент и рынок, discovery, AI-стратегия, метрики и unit-экономика, аналитика на продуктовых данных, защита решения.

Ведут продакты из Avito, Typeform, МТС и Beeline Cloud

Так как я веду открывающее занятие, у меня есть промокод на скидку (10%): MAX10

Если давно хотели систематизировать знания и посмотреть, как агентов внедряют в крупных компаниях, - вам сюда: ai4products.mlinside.ru


Тут huawei выпустила отчёт intelligent world 2035, там целых 10 смелых прогнозов, советую ознакомиться.

Меня зацепил один - агентный интернет: к 2035-му автономные агенты будут генерировать больше 90% мирового трафика ai-токенов, а самих агентов будет около 900 миллиардов - в сто раз больше, чем людей на планете

Я лично в это верю. просто потому что принцип работы современных и эффективных агентных систем построен определенным образом

Разбираемся

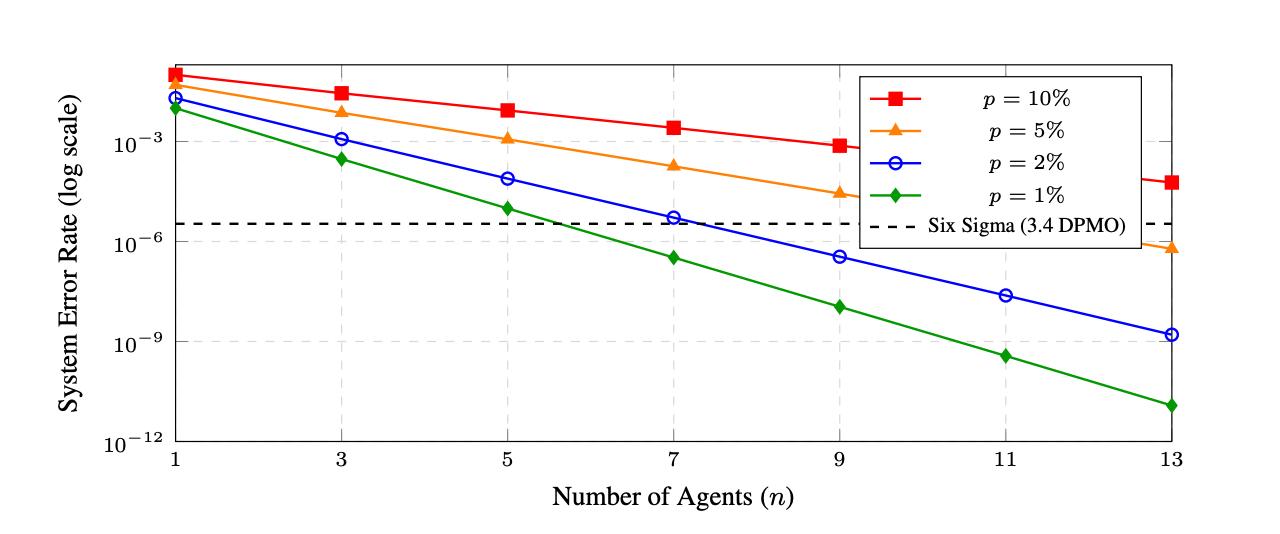
Агент недетерминирован: один прогон может ошибиться, и на уровне LLM модели с этим ничего не сделать. но ошибка перестаёт быть проблемой, когда агентов много. пять параллельных агентов с голосованием при 5% ошибке на действие дают 0.11% ошибок системы - в 45 раз точнее каждого из них (про это есть публикация на arxiv (картинка из нее): https://arxiv.org/html/2601.22290v1 )

Отсюда появляются современные субагенты. у каждого своё окно контекста и своя роль, оркестратор собирает только результаты: главный агент не тонет в шуме, а каждый субагент получает минимальные права под свою задачу. чем больше агентов в такой схеме и чем дольше они работают с инструментами, тем выше шанс, что задача вообще будет решена. именно поэтому openai и anthropic гоняют рои агентов (которые сбегают из их песочниц).

Один агентный прогон - это десятки и сотни вызовов модели, и каждый тащит в контекст всю историю шагов. рой умножает это на число агентов и на длину работы. если рой станет доступен каждому человеку , а не только исследователю с бюджетом, то потребление токенов вырастет не на проценты

Вообщем прогноз выглядит реалистично. Агентов станет много и они будут работать долго

источник


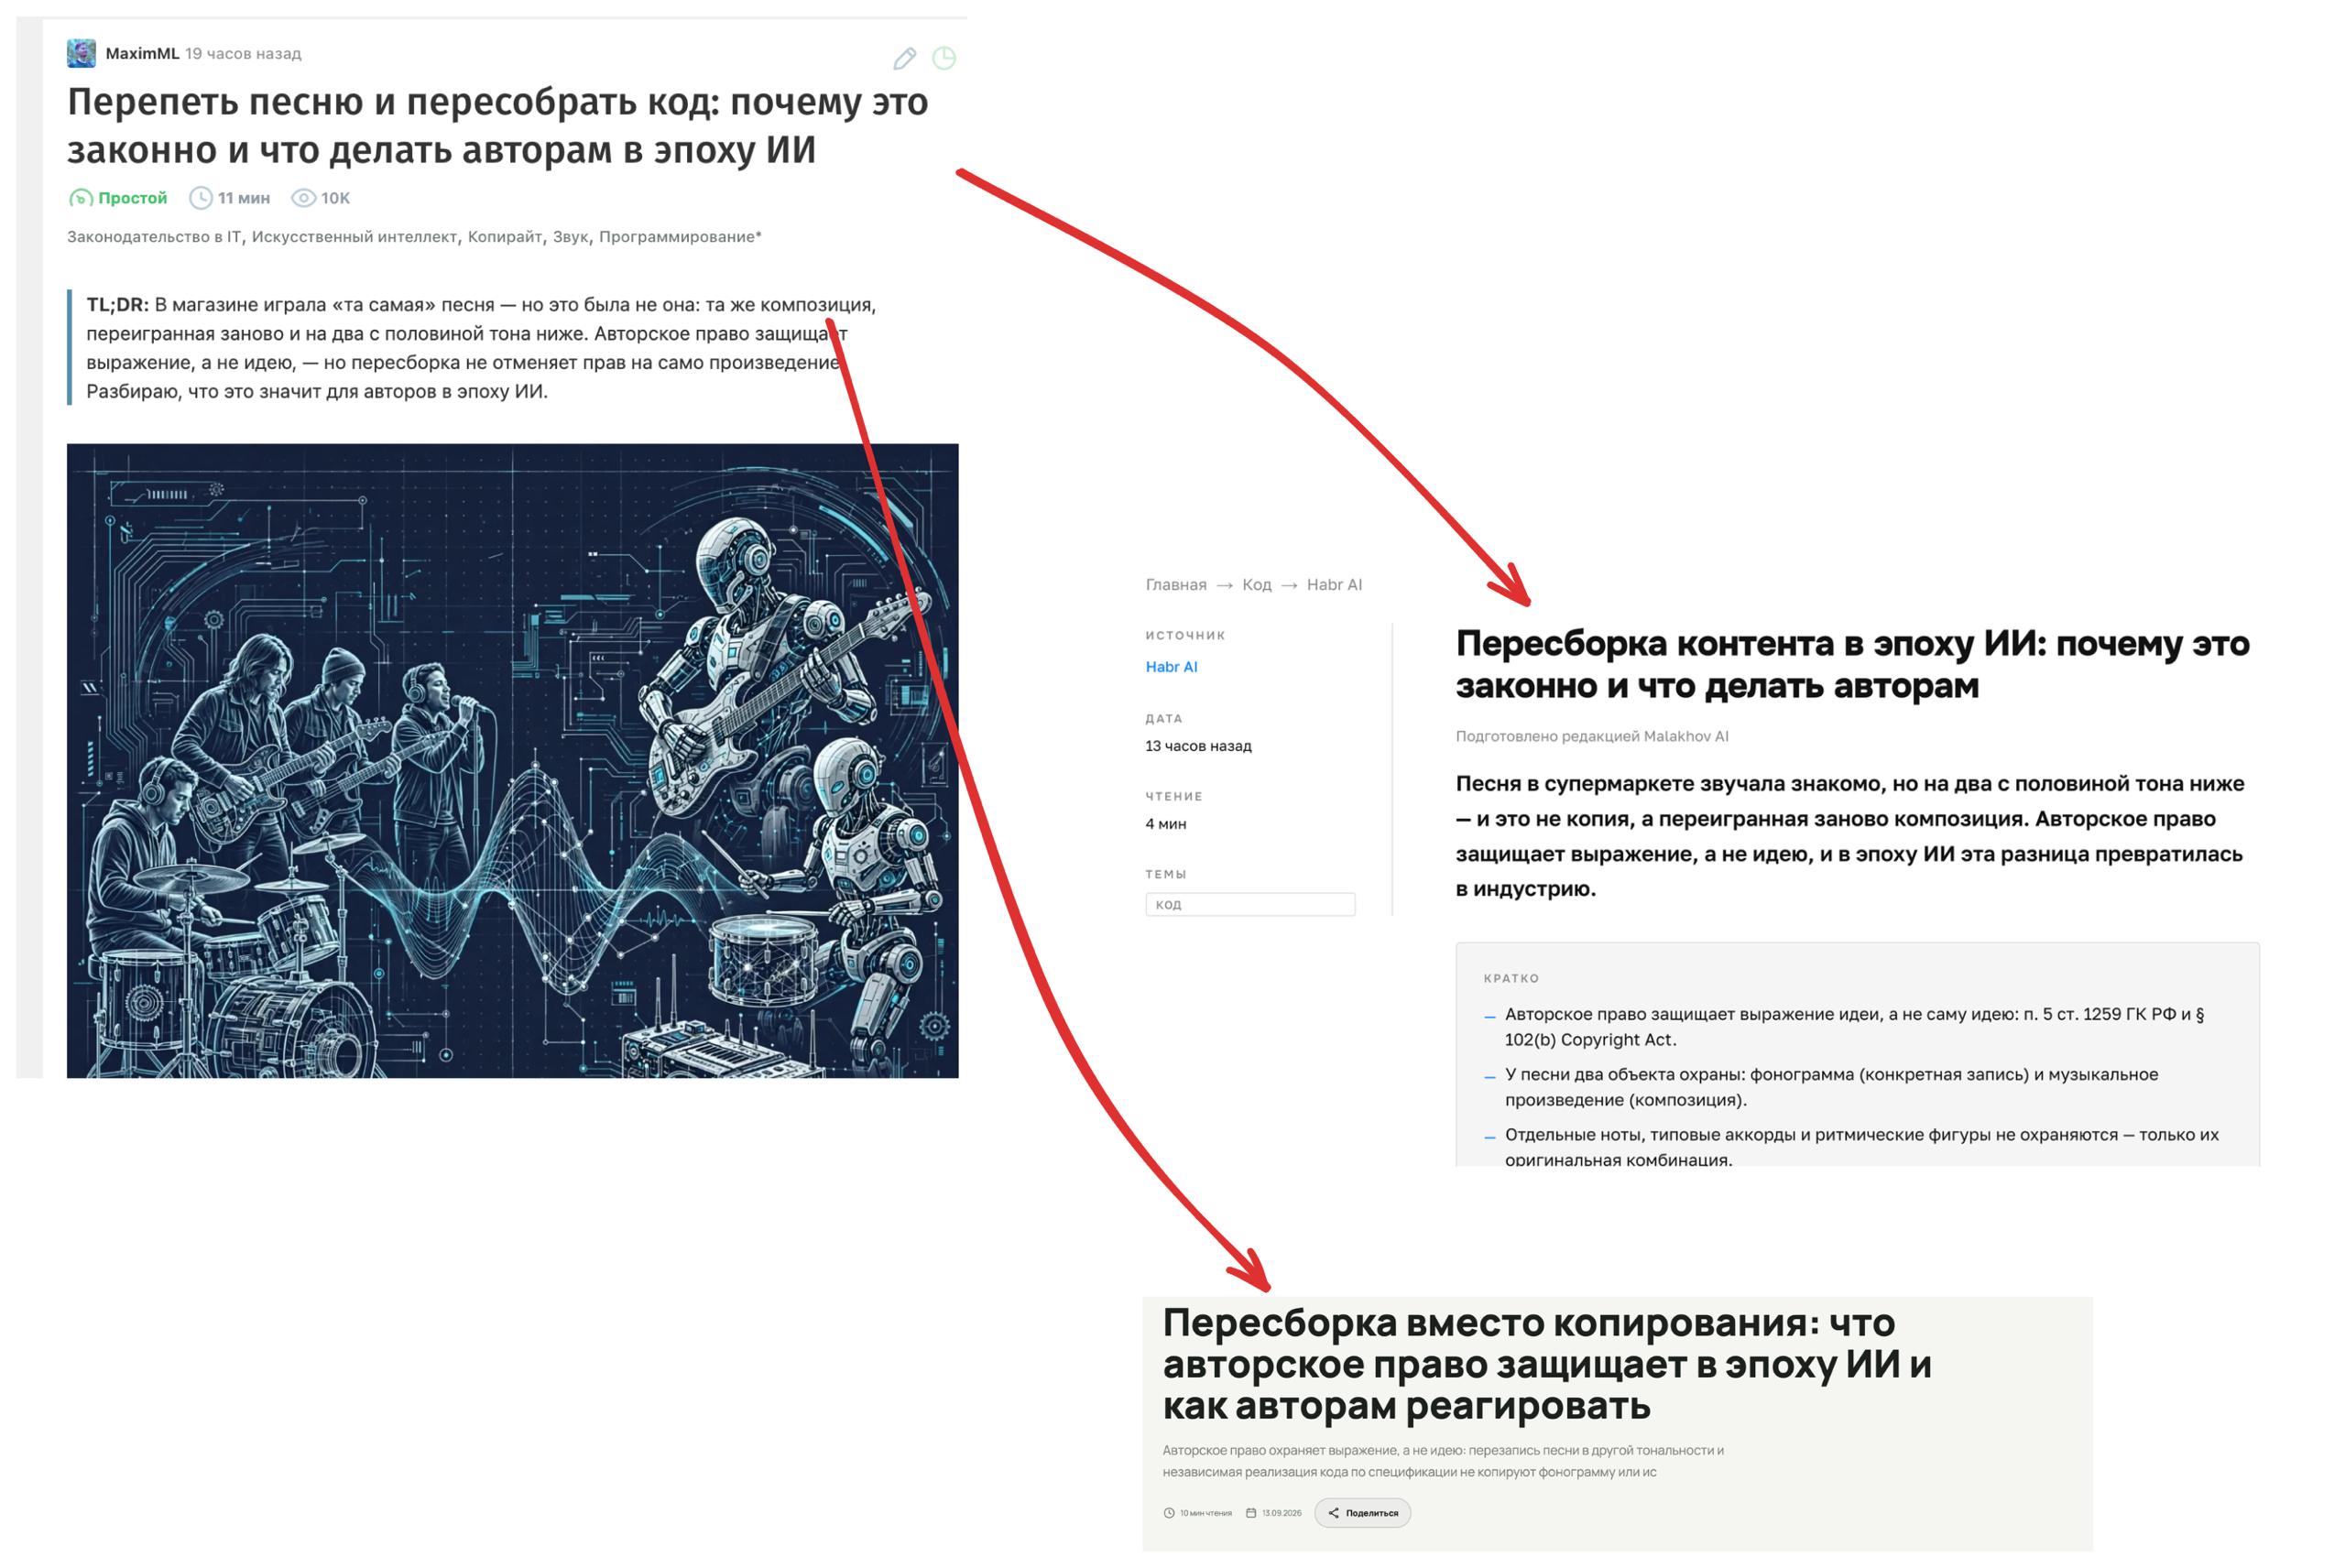
Показательно получилось 🛌 Вчера таки написал на habr про то, как легко теперь копировать чужое при помощи ИИ. А сегодня её уже саму переписали и разложили по своим сайтам. 😬 Ровно про что и статья

Статья объясняла, почему переигранная песня - не копия, переписанный код - не кража, и как ИИ сделал пересборку чужой работы рутиной за копейки. И саму публикацию пересобрали за сутки. Лучшего подтверждения тезиса я не мог получить 👍

А что нас ждет дальше? А дальше будет еще плотнее. Уже сейчас по оценке Graphite, почти половина новых англоязычных статей в 2026-м написана ИИ. Pew даёт 35% страниц с признаками ИИ-авторства. Писать стало дёшево, а читать - нет (поэтому так ценю вас - своих читателей ❤️)

Получаем вот такой вариант развилки: либо ты сам фильтруешь поток руками - двадцать источников, чтобы найти один нужный. Либо это делает агент, который знает, что тебе нужно читать, а что нет. Такое уже называют по-разному: кто-то агентной операционной системой, кто-то вторым мозгом. Между тобой и интернетом появляется посредник.
И тут важно, чей он будет, ваш или не ваш. Об этом тоже как нибудь напишу лонгрид


Сходил за сырниками, а пришлось анализировать данные 📈

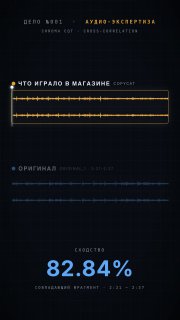
В магазине играла знакомая песня. Мелодия один в один, но что-то в ней было не то. Записал 16 секунд, прогнал через chroma-анализ: сходство с фрагментом оригинала 0.83 🛌

Чью-то песню пересобрали заново, сделали другую аранжировку, использовали тот же гармонический каркас. Копия без копирования, и по закону это не копия, потому что авторское право защищает выражение идеи, а не саму идею

ИИ сделал такую пересборку дешёвой. И это работает не только с музыкой, но и с ПО

Завел под этот агентный скилл публичный репо - если вам тоже захочется повторить аналитику:

https://github.com/MaximShalankin/daily_ai_skills

Если вам зайдёт, то выходные напишу лонгрид на Хабр про авторское право в эпоху ИИ (поставьте 🚨)


Выхожу из декретного творческого отпуска 🛌 и сразу рассказываю свои апдейты и новости, на чём буду сконцентрирован ближайшие 6 месяцев и о чем буду писать на канале

🌟 Исследовательский harness

За последние 2 недели выступил у коллег с этой темой

🔵Сначала рассказал про свой опыт построения такого harness у VTORNIK.Company. Очень камерно пообщались, был приятно удивлён, что эта тема сейчас многим интересна

🔵В прошлую пятницу сходил к друзьям в AI4Dev и рассказал про исследовательский harness в более обзорном виде - про самые актуальные решения и что нас ждет к 2030 году. У выступления есть запись 📈

🔍 обе презентации с выступлением можете посмотреть в комментариях по ссылкам у коллег или тут

🔵А еще в этом семестре веду блок занятий в МФТИ, где центральная тема - это как раз разработка исследовательского harness. Цели и задачи у магистров - по итогам обучения собрать такой harness, который сможет воспроизводить отобранные работы с arxiv 😎

А вдохновением всему этому послужила вот эта публикация arxiv: 2602.12670 - там авторы собрали 47 150 скиллов из трёх экосистем, прогнали 7 308 траекторий в трёх условиях и замерили эффект детерминированными verifier'ами в контейнерах. Без LLM-судьи, поэтому разрез по моделям и доменам честный. Курированные скиллы дают в среднем +16.2 п.п., self-generated в среднем бесполезны, зато маленькая модель со скиллами догоняет большую без них

Вот так вот

#harness@ml_maxim #agents@ml_maxim #meetups@ml_maxim


Архитектуру построили. А ML - нет 🤷‍♂️

Завершился наш с Никитой модуль по AI-агентам в ВШЭ и МФТИ
Финальная задача - разработать агентную систему для решения ML-задач, aka MLE-STAR

57 студентов, 22 решения. Давайте разберем результаты 🧐

Немного про задачу и ограничения:

⚡️Соревнование на Kaggle, которое должно было решаться агентами - всё в лучших практиках - через MCP

⚡️Нужно было использовать только open source модели - так интереснее (конечно, ведь можно взять opus 4.6 и решить задачу в 3 промпта - но это скучно)

⚡️Пять критериев оценки:

1. Архитектура: качество системы, протоколы, современные паттерны;
2. Автоматизация и безопасность: полнота автоматизации, механизмы защиты и мониторинга;
3. Качество модели: результаты на тестах, устойчивость к атакам;
4. Бенчмаркинг: система оценки, сравнение архитектур;
5. Документированность: структурированность кода, качество документации, воспроизводимость;


Что интересного нашел в процессе проверки:

95% команд получили ≥8 за архитектуру, но с качеством модели наоборот: 14 из 22 получили ≤6, и никто не получил 10.

Почему? Корреляция между архитектурой и качеством модели: r = 0.16. Почти независимы.

1️⃣ Агенты не гарантируют качество модели. Оркестрация - про «как организовать работу», а не «какой будет результат». Можно идеально координировать 5 агентов, которые все делают посредственный feature engineering
2️⃣ Базовые ML-решения. Большинство команд ограничились LightGBM/XGBoost/CatBoost с дефолтными или минимальными настройками. Сложная агентная обёртка вокруг простого пайплайна.

Ещё несколько находок:
🔵Корреляция между критериями оценки почти нулевая (r=0.06–0.24). Команды прокачивают разные навыки своей архитектуры независимо
🔵Каждая дополнительная интересная фича добавляет ~0.3 балла - сильнейший предиктор (r=0.56) (например: rag по открытой базе ноутбуков, изоляция исполнения кода в Docker, параллельные запуски конкурирующих агентов)

⚙️ Фреймворки

LangGraph - 55% команд (ср. 7.60), Pure Python - 41% (7.09). Лучшие связки: LangGraph + codegen (7.80), LangGraph + plan-execute (7.60)

Было реализовано много интересных мультиагентных архитектур, но не все они выигрывают соревнования. Нестандартные решения и сильный feature engineering все еще двигают метрику

Так что агенты - все еще инструмент, а не замена ML-экспертизе ✨


Если интересно самим посмотреть решения ребят:
🔗 репо с решениями


Как неожиданно и приятно

Месяц назад отправлял свою рукопись в ainl, сегодня пришёл результат:

- strong accept x1 💪 ;
- weak accept x2 👌 ;
- weak reject x1 🤔 ;

И как итог: принято, а значит поеду в Томск на защиту

Тема статьи капец какая актуальная - атака ⚡️ и защита 🧐 VLM моделей

И вообще напрямую связана с моим текущим open source проектом: http c++ api сервисом для локального сервинга моделей на NPU чипах

И про первое и про второе скоро напишу на habr


Кажется, ИИ способен разогнать цену чего угодно 😓

TL;DR:
Делюсь опытом, как развернуть ассистента почти как open claw на устройстве за 2к рублей, вместо Mac mini за 50к.

Мир внезапно вспомнил, что существуют не только Mac mini, но и мини-серверы вроде Raspberry Pi. Продажи и тех, и других кратно выросли, спасибо вирусным постам про "домашний ИИ" (вот нам не хватало роста на RAM, да?)

Поэтому держите классный хак: свой ассистент, не на Mac mini за 50к, не на Raspberry Pi за 15к, а на Orange Pi Zero 2 всего за ~2к рублей. Зачем переплачивать? 📈

Откуда растут ноги
Есть прекрасный Claude CLI, который умеет, кажется, буквально всё. Если подключить к нему tmux и ловить все входы и выходы через hooks, можно транслировать происходящее прямо себе в Telegram, и переписываться со своим агентом. Агенту нужен лишь терминал и доступ в интернет. Всё остальное по сути переплата. Отсюда вырисовывается интересная схема работы с вашим claude cli терминалом (см картинку)

Я, конечно, не блогер-миллионник, так что на цены Orange Pi мы вряд ли повлияем 😱

Схему Claude + tmux + Telegram тестирую уже почти три недели, накопилось много мыслей про "программирование с телефона". Скоро начну делиться. А пока, если хочется попробовать самому, загляните в проект ccc, там многое уже настроено


Самое время начать сезон Context-Driven Solving ML соревнований 🦆

В прошлом году начинал развивать идею Context-Driven Solving (CDS) ML соревнований при помощи ai-агентов
✅(раз)
✅(два)

Самое время продолжить, предлагаю попробовать свои силы на второй задаче этого соревнования

Почему такие соревнования -  это идеальный полигон для тестов и обучения

Понятные правила, табличные данные, встроенная система оценки - идеальная среда с обратной связью, чтобы протестировать свои знания и навык работы с агентами

Почему именно вторая задача

В ней легче настроить локальную валидацию. Для любых агентных систем важна среда оценивания, и для второй задачи вы без особых проблем сможете построить локальный процесс оценки работы агентов, который будет сильно коррелировать с public leaderboard. Первая задача в этом плане немного сложнее

С чего начать

1️⃣ Соберите контекст - изучите лучшие подходы, найдите открытые проекты и публикации. Сохраните в базу знаний проекта только самое лучшее и релевантное

2️⃣ Настройте проект - создайте структуру, пропишите правила работы с каждой директорией в отдельном readme файле (так агенту будет проще ориентироваться). Если у вас особые вкусы, попробуйте писать спеки

3️⃣ Опишите свои идеи - сформулируйте пару гипотез и попробуйте настроить процесс так, чтобы агент мог проверять их автономно


Всем удачи в новом сезоне 🙌


Уже приходил к ребятам на летнюю школу - в прошлый раз рассказывал про "Что делать с данными, когда их слишком много: от Big Data к Smart Data"

В этот раз расскажу про еще более актуальную тему: "Почему фундамент важнее кода: как меняется Data Science с появлением AI-агентов"

Приходите послушать и пообщаться 👋

Что: Зимняя школа по аналитике, Data Science и Data Engineering от Центра непрерывного образования ФКН НИУ ВШЭ
Где: г. Москва, Покровский бульвар, 11.
Когда: 14 февраля — офлайн, с 10:00 до 18:00.

Участие бесплатное для всех желающих, требуется регистрация: по ссылке


Запустились 😎

Провели с Никитой первое занятие для студентов ВШЭ и МФТИ по курсу разработки ai-агентов для решения Data Science задач (будем делать своего MLE-STAR агента)

Вот вам фотка из backstage 😐
И инфографика с первого занятия - объяснение формирования названий для GGUF - формата хранения языковых моделей.


Запустились 😎

Провели с Никитой первое занятие для студентов ВШЭ и МФТИ по курсу разработки ai-агентов для решения Data Science задач (будем делать своего MLE-STAR агента)

Вот вам фотка из backstage 😐
И еще инфографика с первого занятия - объяснение формирования названий для GGUF - формата хранения языковых моделей.


Только не показывайте такие результаты менеджерам, иначе они поставят KPI +∞ к вашей бизнес-метрике после внедрения AI-агентов 😬

Что здесь происходит?

На скриншоте мой Claude-агент отчитывается о проделанном рефакторинге.
Сейчас я экспериментирую с моделями до 2B параметров на задачах RAG и изучаю влияние разных мультиагентных архитектур на качество ответов. Для тестов использую проработанный бенчмарк HotpotQA

В этот раз агент исправил баг и искренне обрадовался, когда метрика выросла в бесконечность раз 📈


Кажется, это уже становится традицией: каждый год в январе собираю актуальные идеи для pet-проектов на год 🦌

📍Свежая подборка за 2026 тут: https://habr.com/ru/articles/988774
📍Прошлогодняя подборка за 2025 тут: https://habr.com/ru/articles/873300

И да, я сознательно не запихнул туда много идей. Осталась еще целая пачка

невошедшее:
🔵самописный Deep Research
🔵агенты личной эффективности
🔵дообучение небольшой модели (3B–8B) под конкретный стиль/задачу
🔵RAG/поиск по редкому корпусу данных (письма, газеты, документы)

Забирайте идеи и помните: с pet-проектами важно не только начать, но и не забросить 💪


Вместо итогов года: анимация истории канала

Если не нравятся чужие wrappers - надо делать свой 😊

Вместо традиционных итогов года написал свой пайплайн аналитики истории канала

Считаю, что нельзя уместить всю историю канала на одной картинке или в сухом дашборде. Статичная инфографика - это, конечно, круто, но любой автор подтвердит: его канал - это не статика. Это живой процесс, который постоянно меняется вместе с самим автором. Для чего вообще заводят канал? Чтобы фиксировать мысли, расти и развиваться вместе со своей аудиторией

Визуализация данных в динамике - это отдельный вид удовольствия, особенно если у автора накопилось 300+ публикаций (в комментах есть такие примеры). На такой анимации отлично видно, как меняются темы, смещаются интересы и как эволюционирует контент от первых постов к текущему моменту

Поэтому поготовил такую аналитику в динамике, а еще прогнал для некоторых авторов, которых читал в этом году (все gif в комментариях)

Вот чью историю года мне так же было интересно посмотреть:

✨e/acc (@cryptoEssay)
✨эйай ньюз (@ai_newz)
✨Дата канальи - про «специалистов» в данных / ML / AI (@datarascals)
✨Kantor.AI (@kantor_ai)
✨Время Валеры (@cryptovalerii)
✨Dealer.AI (@dealerAI)
✨Neural Kovalskii (@neuraldeep)
✨Силиконовый Мешок (@prompt_design)
✨Борис опять (@boris_again)
✨Сиолошная (@seeallochnaya)
✨И наш корп-блог - МТС True Tech (@truetechcommunity)

(вся статистика по авторам в комментариях)

Хотите такую же анимацию?

Если у вас есть канал или вы хотите увидеть визуализацию истории вашего любимого блога - пишите в комментарии.
Скидывайте ссылку на публичный канал, и если там до 1000 публикаций за 2025 год, скину ответным сообщением

Масс-сервиса и API сейчас нет - мой ресурс этого года уже и так ушел в минус 🛌. Но для интересных каналов всегда найду возможность запустить скрипт

Всех с наступающим! 🎅


😎 полезное про background agents

Продолжаем LLM‑adoption в нашем финтехе: в этот раз добрались до фоновой аналитики и завели в прод (успели под конец года 🎉) background LLM агента, который сам поднимает данные, гоняет статистику и приносит аналитикам готовые инсайты 📈

Вот последняя в этом году статья про background agents на Habr 💪🎄

Там подробнее про то, как поставить такого агента в прод, какие ограничения надо учесть и за счет чего фоновые процессы реально начинают драйвить бизнес, а не просто жгут GPU по ночам

Искренне верю, что именно background-агенты - следующий шаг после копилотов, которые монетизируют idle GPU и автоматизируют аналитику

Если интересна предыстория всего сервиса и конкретно background agents, то:

⭐️ Вот тут предыдущие публикации про сервис

Часть 1

Часть 2

⭐️ А вот тут видео с выступления с разбором концепции background agents

Предыдущий пост

Всем новогоднего вайба 🌟


🤓 Интересное из собесов на ML-щика

Давно не было про собесы, поэтому принес важные кейсы с моих собесов, что сейчас есть актуального по теории ML и практике в system design

⚡️ Кейс 1 - Алгоритмы бустинга

Вот тут писал 💡, что сделаю разбор, что я спрашиваю на собесах про catboost. Исправляюсь - сегодня расскажу про важные особенности основных алгоритмов, понимание которых отличает новичка от профи.

Джентельменский набор алгоритмов бустинга: Аманда, Линда и Роуз XGBoost, LightGBM и CatBoost


🌟 XGBoost (2016, original paper 📑)

🔵Особенность 1 - Функция оптимизации для деревьев. В objective явно добавляется штраф за сложность дерева (например, за число листьев и L2 по весам листьев), поэтому контроль переобучения вшит в математику алгоритма, а не только в внешние приемы вроде early stopping

🔵Особенность 2 - Параллелизация и системные оптимизации. XGBoost проектировался как scalable GBDT - поддерживает параллельный поиск сплитов (по фичам/блокам данных), эффективные структуры хранения и обработку данных, что дает выигрыш на больших датасетах и многоядерных CPU (один из самых первых!)

🔵Особенность 3 - Second-order boosting (использование гессиана). В XGBoost каждый шаг бустинга минимизирует локальную квадратичную аппроксимацию лосса: дерево строится так, чтобы наилучшим образом уменьшить сумму grad и hess вкладов по объектам, где градиенты задают направление исправления ошибок, а гессианы - насколько агрессивным может быть это исправление; из этой аппроксимации напрямую выводятся формулы и для выбора сплитов (gain), и для оптимальных весов листьев, что делает обучение и точнее, и стабильнее


🌟 LightGBM (2017, original paper 📑)

🔵Особенность 1 - Histogram-based обучение (binned признаки). Непрерывные величины бьются на бины, дальше сплиты считаются по гистограммам, что резко снижает стоимость поиска сплитов и память

🔵Особенность 2 - Leaf-wise (best-first) рост дерева. LightGBM обычно растит дерево в глубину по самому выгодному листу, а не layer-wise по уровням, из‑за чего при той же глубине может быть быстрее/точнее, но легче переобучиться (нужны ограничения вроде max_depth/num_leaves/min_data_in_leaf)

🔵Особенность 3 - Две ключевые оптимизации: GOSS и EFB. GOSS (Gradient-based One-Side Sampling) для уменьшения числа объектов при оценке gain и EFB (Exclusive Feature Bundling) для склейки взаимно-исключающих sparse фич (например one-hot), чтобы уменьшить effective features


🌟 CatBoost (2019, original paper 📑)

🔵Особенность 1 - Ordered boosting. Обучающие градиенты/статистики строятся по перестановке (permutation), чтобы снизить специфический target leakage, который возникает в классическом бустинге при некоторых схемах использования таргета/статистик

🔵Особенность 2 - Ordered target statistics / target encoding для categorical фичей. Категориальные признаки обрабатываются через целевые статистики по таргету, рассчитанные аккуратно (в ordered-порядке), чтобы не подглядывать в истинный таргет текущего объекта

🔵Особенность 3 - Симметричные деревья. Деревья одной структуры на уровне (один и тот же split на каждом уровне) дают быстрый инференс и удобную реализацию/векторизацию, ценой ограничений на класс деревьев (это часто ключ к скорости CatBoost на CPU)


⚡️ Кейс 2 - System design

Это свежий кейс с недавнего собеса. Кандидату надо было показать и рассказать, как бы он собрал RAG Pipeline удобного QnA поиска по корпоративной JIRA, и его итоговый результат на картинке (последняя картинка 🖼). Вы уже могли заметить проблемы в схеме, особенно если помните эту публикацию 💡, в которой детально разобрано, что надо реализовывать и как улучшать.

Вообще, вес секции system design сейчас подрос, особенно на middle+ позиции. И конечно одна из причин - активное внедрение copilots и coding agents. Становится критически важно держать в голове полную схем проекта, даже при разработке маленькой его части. Кстати, уже поднимал эту тему и писал об этом здесь 💡.


Всем сильных собесов 💪 и усидчивости при подготовке

730 0 61 2 20

Про Context-Driven Solving

Вчера я рассказал про свое VLM-решение на Yandex Cup: Qwen, STEM-задачи и все, что вокруг них. Теперь - более верхнеуровневая часть истории: про мой подход к соревнованиям, когда в процессе появился co-solver, и почему я называю этот метод Context-Driven Solving

Что такое Context-Driven Solving

Коротко: это способ решать ML-задачи, где вы управляете контекстом и постановкой, а агент берет на себя максимально возможный объем итеративных изменений.

Главная валюта и фактор успеха - это не только GPU и токены, но и количество осмысленных гипотез, которые вы успеваете проверить, плюс ширина вашего понимания задачи

Что нужно сделать, чтобы ваш co-solver заработал

Если совсем упрощать, вам нужно создать три вещи

1️⃣ Честную систему оценки решения (метрики)
2️⃣ Пространство для записи и чтения логов экспериментов
3️⃣ Пространство с контекстом для генерации идей

В моем случае co-solver - это Cursor, который умеет писать и перебирать код. Но у него нет понимания, как итеративно идти к улучшению решения. Для этого нужно создать удобный контур локальной валидации.

Например: поднять контейнер с решением, прогонять его на val-выборке и сделать результаты доступными для Cursor - например, через MCP (Model Context Protocol)

Как это работало у меня

🔵 Собрал около 9k примеров из трех датасетов, затем отобрал по 250 из каждого для быстрой локальной валидации
🔵 Описал правила: какие изменения считаются новой гипотезой, как меряем качество, когда считаем эксперимент неуспешным. Это определяющий шаг для автономности: чем лучше прописаны правила, тем меньше у co-solver'а галлюцинаций
🔵 Дал агенту право генерировать варианты кода, промптов и пайплайнов, а система валидации сама выявляла лучшие идеи

В итоге получилось провести 64 эксперимента за время соревнования. В ручном режиме я еле-еле дожал бы до двух десятков

Ловушка контекста

При этом co-solver - все еще помощник.
Если вы плохо понимаете доменную область, даете сырое описание задачи и расплывчатые метрики, агент просто масштабирует это непонимание. Он честно и быстро ведет вас в локальный оптимум.

Ваша задача - создать систему проверки и качественно описать идеи. Результат оказывается лучше суммы частей только если архитектор силен. Если архитектор слабый - co-solver просто ускоряет путь в тупик.

Что будет в соревновательном ML в 2026

Думаю, 2026 год будет еще интереснее:

1. Задачки вида «подкрутите fine-tune» уйдут. Уже появляются skills, которые делают finetune «из коробки». По сути, за нас сделали MCP для задач обучения - это круто.
2. Появятся сложные форматы с агентами, многошаговой логикой и ограничениями по контексту.

Ориентиром уже сейчас выглядят соревнования уровня AI Journey 2025 у Сбера, где одной «большой моделью» без архитектурного дизайна не обойтись (вот тут в канале у дяди делали разбор топовых решений - получилось интересно).

Итог

Призываю всех пробовать участвовать в соревнованиях. В первую очередь самостоятельно, чтобы расширять свой контекст, но и во вторую - при помощи LLM и co-solver’ов.

Даже если ваша цель - не победа, а просто практика, вы:

🔵 лучше поймете, как ставить задачи моделям
🔵 научитесь строить рабочие контексты
🔵 увидите, где ваш способ мышления реально упирается в потолок

Соревнования - это безопасная песочница, где можно экспериментировать с Context-Driven Solving и учиться работать в паре с ИИ


Разбор решения Yandex Cup

Прошел Yandex Cup, где в треке ML я выбрал задачу STEM problem Q&A для VLM моделей (это когда надо решать задачи по математике и физике с листочка - но только в нашем случае, при помощи VLM)

Самое время подвести черту и поделиться решением 📃

Сразу отмечу: радует, что агенты стали нормой. Комьюнити созрело, орги не банят за LLM-кодинг. Кажется, все приняли как данность, что без этого теперь никуда.

Мой технический стек

В итоге я вышел на такое решение:

Ядро: Qwen3-VL-8B-Instruct + 4-bit квантование
Методы: Chain of Thought + Prompt Routing
Почему так: Большие модели лучше маленьких - это факт. Я пробовал собирать ансамбли из мелких моделей, но они никак не могли приблизиться к одной большой. Time Limit в 1 час сильно ограничивал: на полноценную Thinking-модель времени инференса мне просто не хватило (квантованные версии не попробовал). До finetune версий моделей тоже не дошел


Что было больно (и интересно)

🔵Недетерминированность. На графике динамики лидеров видно, как участников штормило. Один из вариантов решения - поставить высокую температуру и устроить Voting одной и той же версии модели. Понятно что такое решение невоспроизводимо. Даже с температурой 0 метрика гуляла. Ты запускаешь топовое решение второй раз, и оно падает в рейтинге

Инженерные вызовы и хаки

🔵Контейнеризация. Часть успеха - корректно развернуть модель в докере. Это был отдельный инженерный вызов

🔵Железо. Хорошо бы иметь домашний Linux GPU-кластер (ну или брать его в аренду). Это единственный способ сделать локальную валидацию быстрой и приближенной к проду.

Моя главная ошибка:

Я собрал неверный сет для локальной валидации. Использовал ScienceQA, Geometry3k и MathVista, но поздно понял, что у меня нет корреляции Local / Public Leaderboard. Был момент, когда из-за бага давали 8 сабмитов в день - идеальный шанс подобрать val data, но я его упустил. В итоге локально метрика росла, а на лидерборде - нет.

Классический совет себе на будущее:

Не нужно долбиться в одно решение. Не работает с трех попыток - делаем шаг назад и думаем еще

Завтра расскажу про свой подход к vibe-competiting - как решать задачи с помощью co-solver’а и не сойти с ума

P.S. Интересно, кто-то из финалистов уже рассказал о своем решении? Если знаете - скидывайте ссылки в комментарии


Да кто это такие, ваши background agents 🤔

Недавно ходил в гости к ребятам из AI4Dev и рассказал о background agents - фоновых агентах, которые могут решить одну проблему неэффективности датацентров

Видеозапись доступна здесь:
🔵 YouTube
🔵 VK

Коротко про что лекция:

Есть две проблемы, которые повышают цену токенов

1️⃣ Неэффективность фазы декодирования. Выходные токены (output tokens) стоят кратно дороже входных (input tokens). Это происходит из-за того, что фаза Decode (генерация ответа) работает последовательно, токен за токеном. В этой фазе GPU простаивает сильно больше времени, чем фаза prefill, и стоимость этого простоя закладывается в высокую цену токенов

2️⃣ Закупка ресурсов впрок. Взрывной рост числа пользователей (Open AI достигла 1 млн за 5 дней) и динамика суточной нагрузки заставляют компании закупать дорогостоящие видеокарты впрок. Этот ресурс не используется на полную мощность и простаивает

В видео я разбираю потенциальное решение проблемы: background agents 📈

Это прерываемые, некритичные к задержкам агенты, которые встраиваются в простаивающие окна GPU. Они выполняют полезную фоновую работу: проверку кода, аналитику данных или обработку неструктурированных данных.

Повышая утилизацию видеокарты, компании смогут снизить цену токенов, что даст им сильное конкурентное преимущество на рынке

20 last posts shown.