Заместители


Гео и язык канала: Россия, Русский
Категория: Технологии


Цех ИИ агентов. Здесь я тестирую цифровых заместителей в разных профессиях. По пути обсуждаем актуальные новости про ИИ агентов простым языком.
Добро пожаловать в эру замещения.
Запросы -> aideputies_collab@agentmail.to.

Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


Claude Startups: Anthropic раздают Team Plan для стартапов на год и многое другое

Для команд, которые строят продукты на Claude, обновили программу поддержки. Если вы строите продукт / стартап на Claude — это маст хев! 😮

После одобрения заявки участники получают:
• Год Claude Team бесплатно — до пяти Premium-мест, если компания раньше не пользовалась Team.
• $1 000 кредитов на Claude API для разработки и экспериментов.
• До $45 000 в скидках и кредитах партнёров через новый Claude Startup Stack.
• Консультации с Applied AI-командой Anthropic, помощь с созданием и подачей плагинов и коннекторов в Claude Marketplace, доступ к мероприятиям для основателей.

В партнёрском наборе, например: $5 000 на ClickHouse Cloud, три месяца Granola Business для команды до десяти человек и скидка 25% на первый год Gamma Pro. Сумма $45 000 — максимальная совокупная стоимость предложений, посчитанная маркетологами Антропик. Но имеем в виду, что доступность каждого зависит от условий партнёра.

Подать заявку могут стартапы, основанные за последние пять лет или получившие финансирование за последние два года. Для компаний с инвестициями от фондов из партнёрской сети есть отдельная возможность получить до $100 000 дополнительных API-кредитов через свой фонд.

Условия и заявка тут. Такой аттракцион щедрости пропускать нельзя 👍

Заместители


Видео недоступно для предпросмотра
Смотреть в Telegram
Моды в Claude Code и новый портал с гайдами от разработчиков Claude

Как предсказывал Тибо (крестный отец Codex) — мы двигаемся в направлении универсального AI агента. И одна из ключевых возможностей такого AI — умение развивать собственный харнесс.

Однако, что забавно, первый шаг в этом направлении сделали Антропики. И выкатили моды — расширения, которые позволяют менять поведение Claude Code и добавлять собственный интерфейс прямо в терминале или десктопном приложении.

Технически мод — это TypeScript-модуль внутри Claude Code плагина. Он загружается один раз на сессию и подписывается на события (через хуки): отправку промпта, вызовы инструментов, начало и завершение ходов, отрисовку интерфейса.

Мод может наблюдать за событием, изменить его параметры или перехватить действие — например, запретить выполнение команды. Работает как в терминале, так и в десктоп версии.

Люди уже строят забавные и иногда полезные моды:
1. Мод, который смотрит за действиями Клода во время работы и пересказывает их в прикольном мультяшном стиле как маленькие истории.
2. Мод, чтобы читать переписки между сессиями Клода (если вы забыли — сессии в Клоде могут переписываться друг с другом) и влезать в их диалоги.
3. Мод с тамагочей, который питается кодом. Правки кормят его, успешные тесты радуют, проваленные выпускают ползающих жучков.

Создать мод можно просто попросив Claude Code.

А рассказывают все это на новом портале Claude.dev. Это портал, который Антропики выкатили специально для разработчиков и инженеров (не путать с документацией и академией — это отдельный порталы). Там выкладывают туториалы, плейбуки и статьи про лучшие практики в работе с агентами.

Мысли

На две мысли меня натолкнули эти новости.

Первая — пока что моды это инструменты для разработчиков. Но ставлю 🍋токенов, что дальше агент будет сам себе писать такие моды прямо находу. Как сейчас агент создает артефакты и HTML файлы по любому поводу — так он будет дописывать свой харнесс под задачу. Например, спрашиваешь про юридические вопросы — получаешь свой встроенный Консультант+ модуль. Интересуешься играми — свою навайбкоженую среду разработки игр.

Вторая — Claude.dev это некий возврат к истокам. Антропики как бы снова заигрывают с разработчиками, мол "это все еще мы, компания, которая строит AI специально для разработчиков". Что ж, как бы там ни было, а нам приятно, что о нас помнят ❤️ А материалы на этом портале глубокие и интересные. Так что рекомендасьон.

Заместители

987 0 41 2 13

Коты против СДВГ. AI DIY приложение, которое заработало $160К

Продолжаем нашу рубрику, где простые ребята вайбкодят крутые продукты. Сегодня смотрим на продукт от Райана и Сары, двух дизайнеров, которые ушли из бигтеха, чтобы посвятить себя своему собственному проекту. Они создали iOS-приложение Cat on Chair — уютный Pomodoro-таймер с котами, мебелью, анимациями и элементами коллекционирования. Примерно за год приложение достигло 240 000 загрузок и принесло более 160 000 долларов выручки создателям.

Всё началось с небольшой глиняной фигурки кота на стуле, которую сделала Сара. Вдохновившись ею, Райан предложил использовать название Cat on Chair для приложения.

Они объединили Pomodoro-таймер с атмосферой виртуального питомца: пользователь работает, а кот находится рядом, и присматривает за юзером, чтобы тот не прекратил фокус-сессию раньше времени. Если юзер доходит до конца таймера — получает подарок от кота. Если прерывает — мешок мусора и недовольного кота 🐈‍⬛️

Если вы не в теме — то такие приложения используют люди, которым сложно держать фокус длительное время на одной задаче или как ныне модно говорить — СДВГшники (а кто сейчас не СДВГшник то 🤭).

Разработка велась почти полностью с помощью AI агентов, так как ни один из партнеров не был разработчиком. Вайб-кодил в основном Райан, сначала с помощью Cursor, а потом перешел на Claude Code и Codex. Дизайн приложения делали в Figma сначала с помощью агентов, но в итоге допиливали руками.

Не везде AI справлялся хорошо. Например, в приложении есть фишка, что объекты "падают" в направлении, куда наклонен телефон юзера — и физика этого падения никак не давалась AI агенту. Тогда Райан просто загуглил другие приложения с подобной механикой, раскопал, что они используют в качестве движка для такой физики — и подсказал своему агенту. Этого было достаточно, чтобы после этого все начало уверенно подчиняться гравитации.

Особенно интересно, как у них прошел запуск. Перейти от Family Friends Fools до адекватного количества реальных юзеров — больная точка всех DIY проектов. Но ребята подошли к этому просто — записали тизер как работает приложение и выложили пост на Rednote (такая соцсеточка, популярная в Азии, что-то типа гибрида Pinterest и TikTok). Пост набрал 10к просмотров и привлек им первых бета-тестеров. С фидбеком первой аудитории разработчики внимательно работали. И приложение заработало свои первые положительные отзывы. А дальше его начали подхватывать всякие Инстаграм блогеры и уже нести в массы. Никакой контекстной рекламы — только реклама через контент.

И вот сейчас у них примерно 900 загрузок в день. $160К доход за год (в основном с пожизненных покупок приложения и годовых подписок).

Чему мы можем научиться у Райна и Сары

1. Разрабатывать может каждый. Но просто орать на AI "сделай хорошо" — не получится. Иногда нужно засучить рукава и пойти найти рабочий референс, чтобы AI сделал именно то, что вы хотите.
2. Ключевая фишка приложения — его эстетика, и она создается вручную. Самое сердце продукта — это самобытный hand-made, а не результат вайбкодинга. За него и платят денежку. Не всегда нужно делать приложение в минималистичном стерильном стиле как это хорошо умеют делать AI агенты. Люди соскучились по краскам и уникальности.
3. Наконец, не всегда нужен рекламный бюджет. Алгоритмы соцсетей и блогеры с радостью сами вас завирусят — они голодны до уникального контента (потому что люди тоже хотят его). Сделайте уникальную подачу вашего продукта, которая легко "разгоняется", а потом работайте с первыми юзерами, слушайте их пожелания и активно развивайте продукт. Юзеры вам этого не забудут 🥰

П.с. если захотите послушать полное интервью этой милой пары разработчиков и вдохновиться — ссылочка суда.

#AI_DIY
Заместители


AI-агент доказал, что ваш код работает. Но можно ли ему верить?

Борис Черный рассказал в Xвиттере, как проверял Claude Agent SDK с помощью Lean. Всего несколько промптов привели к 16 PR с исправлениями багов. Риторический вопрос Бориса в посте: формальная проверка — будущее разработки? Но я бы сформулировал вопрос по-другому: можно ли верить формальной проверке, которую провел агент?

Для начала разберёмся, что именно проверяется и как

Во-первых, Lean. Это язык программирования и помощник для доказательств, который моделирует что-либо, чтобы проверить утверждения о логике программы. Например: "Рассчитанная выплата никогда не превышает доступный остаток". Агент записывает функцию и доказательство на Lean, а движок Lean проверяет его для всех допустимых входов, а не для нескольких примеров из тестов.

Во-вторых, Борис также упоминает TLA+ — он проверяет поведение системы во времени. Например, два воркера (проще говоря — параллельно работающих процесса) одновременно забирают задачу в работу. Агент описывает на TLA+ их возможные шаги, а движок (TLC) перебирает порядки событий. И может так найти проблемы, как например, что будет, если оба прочитали статус до того, как один из них записал новый?

Звучит как мечта: попросил агента "докажи, что все ок" — и спишь спокойно ☕️ Но есть нюанс...

После получения "магического промпта" процесс под капотом выглядит так: агент интерпретирует программу, свою интерпретацию логики программы он пишет в виде модели на Lean или TLA+, а движки уже далее проверяют эту модель (а не исходный код!). И если при переводе агент забыл или неправильно считал условие, неверно понял транзакцию или поведение внешнего API, можно получить безупречное доказательство просто не той программы 🤡.

И вся беда в том, что откровенно говоря, процесс перевода автоматически полностью валидировать никак нельзя. Вот и получается, что процесс, который призван проверять ошибки за глючащими LLM — сам подвержен этим самым глюкам.

Получается Lean и TLA+ — фигня?

Нет. Как любил говорить мой преподаватель в универе — в математике важна "жесткость конструкции". Для проверки жесткости нужно довести написанные программы до предела, растянуть их сразу во все стороны, найти все edge-кейсы. И по задумке вообще-то это должны делать хорошие юнит-тесты. Но мы все знаем, как LLM пишет тесты: 100500 тестов, из которых 2 реально полезных, 100496 ничего не тестирующая мешура и 2 теста агент решил пропустить, потому что они не работали 😁

Поэтому Lean и TLA+ — это те самые инструменты, которые позволяют писать реально качественные тесты.

Но что делать с бедой, что LLM может просто потерять или неправильно перевести часть программы на языки Lean и TLA+ для проверок?

Хоть 100% гарантии нет, все-таки можно существенно увеличить шансы корректного перевода из кода в модель. Для этого нужно явно тянуть "красные нити" через всю разработку.

Допустим, в BRD есть бизнес-требование: "Одна заявка не должна приводить к двум выплатам". Это наша красная нить. Дальше мы начинаем ее тянуть. Сначала в TRD — там она обрастает сценариями: что делать, если два воркера, поведение при повторном запросе и тд. Далее тянем ее в архитектуру программы — архитектор выбирает механизмы реализации и защиты написанного в TRD. И наконец на последнем этапе все это реализуется в коде программы. То есть вся разработка строится вокруг красной нити, тянущейся из самого начала — из бизнес-требований.

И если разработка выстроена вдоль этих требований — то жесткий каркас вашей программы становится однозначным и детальным.

Дальше дело техники из двух частей

Первая. Эти же "красные нити" становятся опорой для агента для перевода программы в модели Lean и TLA+. На нашем примере TLA+ проверяет, возможны ли две выплаты при разных порядках событий; Lean проверяет отдельные правила расчёта; тесты воспроизводят найденные сценарии на реальном коде. У каждого шага есть ссылка на исходное требование. В таком сеттинге агенту крайне сложно потерять какое-то важное условие, тк это станет видно на каждом этапе анализа проекта.

Вторая. Отдельно нужен набор проверок того, насколько построенная в Lean и TLA+ модель реально отражает проверяемый код. Иначе это останется слепой зоной, где вы теряете весь контроль над всеми остальными тестами. В этих проверках сравниваются результаты работы кода программы и построенной модели программы на одинаковых входных данных.

Отвечаем Черному

Так что ответ на риторический вопрос Бориса Черного — конечно, да, формальная проверка станет частью агентной разработки, потому что она круто укрепляет слабое место современной агентной разработки — тестирование.

Но, чтобы реально доверять "зеленой галочке" об успешно прохождение Lean и TLA+ тестов, необходимо выстраивать прослеживаемую цепочку через всю разработку:
|→ BRD (задается людьми)
|→ TRD (валидируется людьми)
|→ Архитектура (верхнеуровнево валидируется людьми)
|→ Реализация в коде (выполняется агентами и как раз нуждается в проверке)
|→ Lean / TLA+ модели (пишется агентами)
|——> Проверка на соответствие логики модели закладываемым требованиям (осуществляется агентами)
|——> Проверка на соответствие логики модели логике проверяемого кода (осуществляется агентами)
|→ воспроизведение ошибок, найденных во время тестирования модели, на реальном коде (осуществляется агентами)

Может звучит сложно, но это новый образ качественной разработки. Ведь в условиях, когда писать код руками нам с вами уже не нужно — проработка каждого из этих этапов — и есть наша основная работа.

#ИИученьесвет
Заместители


Видео недоступно для предпросмотра
Смотреть в Telegram
Новая рубрика AI DIY. Первый гость — внебрачный ребенок Google Earth и Palantir

Запускаю рубрику #AI_DIY (или "сделано своими AI руками").

Речь не только про мои руки, а про руки всех умельцев, которые завайбкодили что-то крутое. Попутно будем смотреть, какие технологии используются и впитывать интересные идеи от создателей. Проекты я буду выбирать на просторах интернетов и делиться с вами.

А если у вас есть свой крутой проект, которым вы хотите поделиться и собрать обратную связь от аудитории канала (и моего блога на VC) — оставляйте ссылки и описания в комментариях! Про самые занятные будут выходить посты. Нам интересный контент — вашему проекту бесплатный пиар и фидбек от сообщества 👍

God's Eye View

Итак первый проект завайбкоженый соло-разработчиком Bilawal Sidhu. Это прямой "конкурент" Worldmonitor, о котором я рассказывал раньше. Однако тут сделан особый фокус на визуализацию в стиле Google Earth а-ля "разведка".

Разработчик проекта помимо всего — ютуб-блогер, поэтому проект его быстро завирусился. Он его опенсорснул, и сейчас на гитхабе у проекта больше 43К звездочек и около 100 со-разработчиков.

В нем есть базовый набор "OSINT" данных:
• погода
• инфраструктура (типа датацентров, интернет-кабелей, водяных дамб и тд)
• лайф-трекинг гражданских и военных (очевидно, только не скрываемых) самолетов
• военные базы (также публичные)
• возможность подключиться к городским камерам
• землетрясения, пожары и тд
• лайф-трекинг спутников
• лайф-трекинг космических миссий

Все данные представлены на глобусе типа Google Earth, где наборы данных включатся слоями.

Но есть пара фичей, которые круто выделяют этот проект и из-за которых мне захотелось рассказать о нем:

Во-первых, встроенный голосовой ассистент. Если подключить API токен OpenAI — ваш джарвис сможет перемещать вас по карте по вашим запросам типа "найди самый загруженный аэропорт". И расскажет о том, что вы наблюдаете. Например, объяснит, почему в этой зоне такое количество военных баз.

Во-вторых, replay событий. И это гениально! AI собирает из соцсетей видео и фото от очевидцев и ретроспективно выстраивает события и отрисовывает их на карте. например, оползень в Непале (см видео). Где-то даже не нужен AI для replay — так например можно посмотреть, как прошел запуск миссии Falcon Heavy (тоже на видео). К сожалению, я не нашел в проекте какого-то централизованного поиска по всем таким событиям, возможно оно пока что вообще одно в проекте, но выглядит это впечатляюще.

Технологическая сторона медали

С точки зрения технологий это — веб-приложение на обычном JavaScript и CesiumJS. Cesium рисует глобус и отдельные слои для самолётов, спутников, погоды и других объектов, а локальный Node-сервер получает данные от внешних источников, кэширует ответы и выступает посредником с API, откуда тянутся в реальном времени все данные.

Часть данных, кстати, недоступна, пока юзер не подключит собственные API ключи.

Выводы

Такие проекты — взгляд в будущее карт. Больше интерактивности, больше агрегации данных из разных источников и взиамодействие через AI-ассистента.

Ну а для нас с вами — для тех кто создает проекты и продукты с помощью AI — это пример того, как даже самый базовый проект (все мы вайбкодили себе какой-нибудь дашборд) можно оживить крутым визуалом и необычными небольшими фичами.

#AI_DIY
Заместители


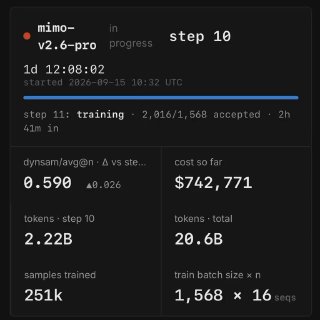
Можно вечно смотреть на три вещи: огонь, воду и как обучается новая фронтирная модель

Поэтому вот держите: Xiaomi стримят RL обучение новых Mimo V2.6 Pro и Flash.

Внутри ещё и куча внутренних метрик. Возможность заглянуть под капот, как техногиганты обучают фронтирные модели.

Заместители


Видео недоступно для предпросмотра
Смотреть в Telegram
Ex-разработчик OpenAI выкатил сверхэффективный класс моделей — идеальный тул для AI агентов

Диого Алмеида (Diogo Almeida) 2 года назад ушел из OpenAI и начал пилить свой стартап TypeSafe AI. Ребята бросили вызов современной самой мощной концепции ИИ — ЛЛМкам.

У них простой тейк — мы заставляем делать LLM то, подо что они не заточены. Так давайте сделаем модели, которые созданы специально для этого. И, похоже, сделали 😎

Чего-чего? О чем речь вообще?

Вот вы просите LLM — собери все отзывы на товары проанализируй их и опиши их. Или ставите агента отсматривать инциденты и принимать решение об эскалации. Или агент сидит в вашей почте и решает, какое письмо вам сегодня подсветить, а какое замьютить и не отвлекать вас...

Чтобы решать такие задачи вообще-то хорошо бы использовать специально обученные классификаторы. Но на все такие задачи не наобучаешься моделей, а иногда нет нужной выборки для обучения (ну вот приспичило вам классифицировать сообщения ваших коллег по психиатрическим диагнозам 😁) или просто нет времени и желания.

Вот тогда на сцену раньше выходили LLM. Но вообще-то LLM очень плохое решение для такого класса задач. Они переводят все данные в текст, сами размышляют текстом и либо выплевывают рандомную циферку, либо в лучшем случае пытаются придумать правила скоринга и потом оценивают по этой примитивной формуле. Да еще и сжигают кучу токенов и делают это очень медленно.

Возможно теперь решение проблемы — Jev

Так назвали свою первую модель ребята из TypeSafeAI. И, если вкратце, то модель берет на вход рандомный текст, а на выход позволяет юзеру предзадать любой набор классов. Модель — раскидает данные по ним.

То есть архитектура явно работает тоже через предобучение на большом количестве данных. И имеет под капотом некое представление об окружающем мире, как и LLM. Но только на выход модель выдает не текст, как LLM, а структурированный файл с заданной заранее классификацией.

Зато работает Jev почти в 200 раз быстрее топовых LLM и почти в 450 раз дешевле. А качество ответов будет на уровне Opus 5.

То есть получается такая универсальная решалка с общим знанием мира. А дальше ее можно комбинировать в деревья решений. И на выходе получается адаптивная AI система, которая напоминает те самые workflow из времен n8n. Только в n8n в "звенья" воркфлоу подключалась LLM в качестве мозга, а здесь — Jev на его космических скоростях. На выходе получаем систему, которая играет в Doom в реальном времени 🕶

Jev при этом, по заявлению создателей, был создан совершенно новым способом:
• новая архитектура
• новый sampler
• новый алгоритм обучения — RLCD (Reinforcement Learning for Calibrated Decisions)

Но детали, к сожалению, не раскрывают. Научной статьи тоже нет. Поэтому пока что приходится верить на слово. Однако стартап немного раскрывает свои эвалы, по которым оценивалась модель.

Мысли

Главная проблема этих ребят, честно говоря, — позиционирование. Они почему-то стали сразу наваливать на LLM, мол быстрее, выше, сильнее ЛЛМок. Мол AGI даже создали. Но вообще им бы хорошего продакта в команду 😁

Ведь они создали просто идеальный инструмент для LLM. Объективно, люди руками не будут придумывать классы для Jev и строить воркфлоу руками. Это в прошлом, умерло вместе с n8n. Теперь этим занимаются агенты.

А вот дать задачу агенту построить пайплайн с использованием Jev в качестве движка, и сэкономить таким образом тонну токенов и ускорить процесс в разы — это желанный брульянт всего рынка.

Сейчас это чудо заморское доступно только по листу ожидания. Заявочку я отправил, очень хочется потестить руками.

#ИИстатья #заместители

Заместители


Хакатон от OpenAI — вот что я понял

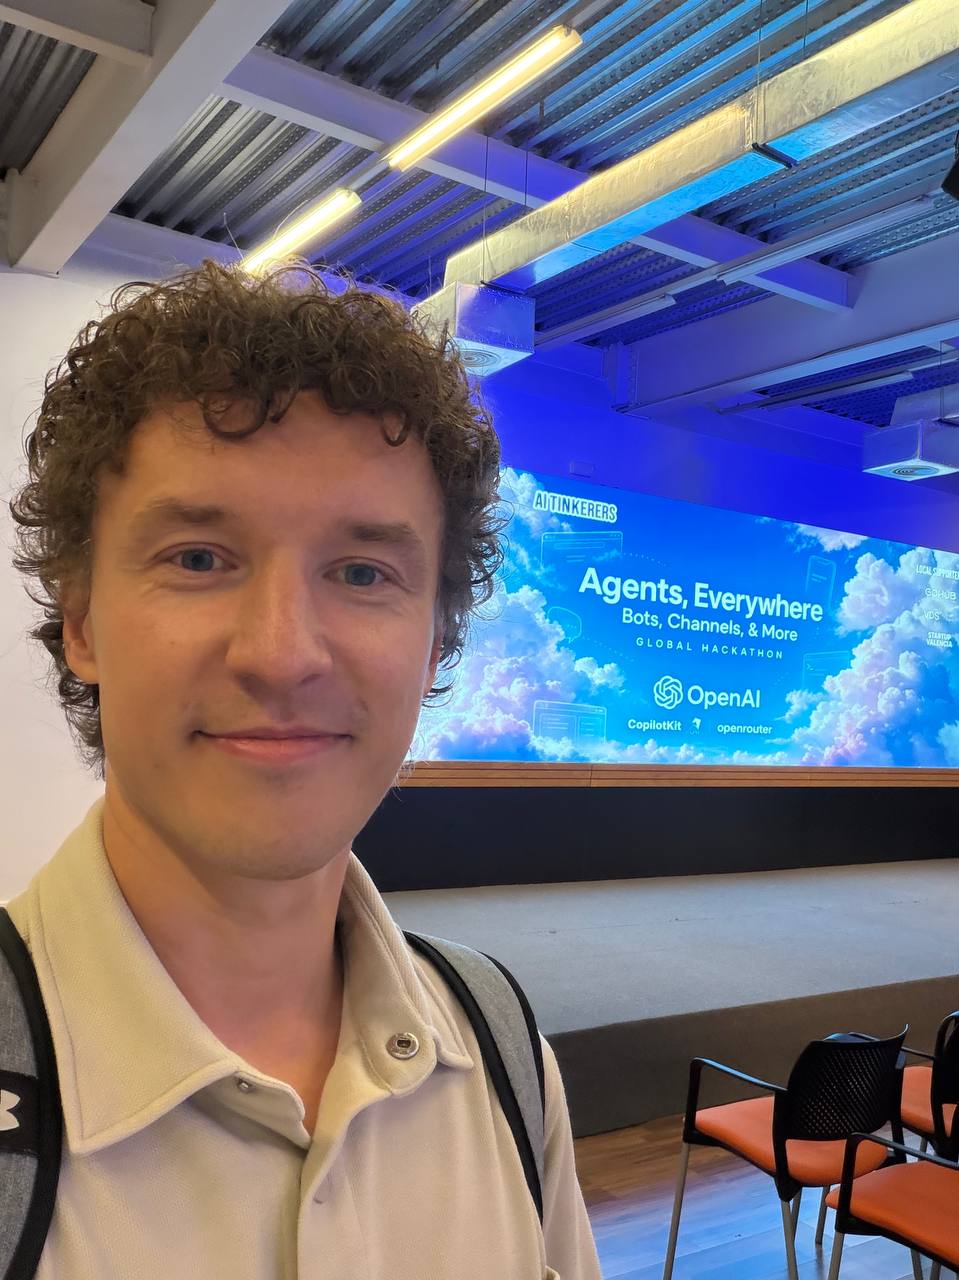
Сегодня ради фана участвовал в хакатоне от OpenAI в международном сообществе AI Tinkerers. И хочу вам сказать — хакатоны поменялись с тех пор, как я последний раз в них участвовал. Делюсь впечатлениями ⌨️

Во-первых, я угарнул с того, как теперь выглядит «напряженная работа» команд на хакатонах. Они напряженно смотрят в экраны, где GPT-6 Astra пыхтит над реализацией затеи команды 😁

Во-вторых, раньше в команде работа шла пару дней. Эх, помню эти бессонные ночи с пиццей и энергетиками… Пицца и энергетики остались, но вот время на разработку сократилось до 5 часов! За 5 часов 5 незнакомых до этого людей с нуля строят работающий MVP с несколькими интеграциями, красивым фронтэндом и, конечно же, с движком на базе AI агента внутри.

Безумно вдохновляет видеть, как реально на практике схлопнулось расстояние от идеи до работающего сервиса. Уходишь с мыслью «если это построили за 5 часов, что я могу построить за 5 дней?!»

В-третьих, в работе команд сместился фокус с чисто гиковской разработки на проработку пользовательских маршрутов, сценариев и UX. При этом в команде все ещё есть технари и бизнес люди. Но теперь это просто разные концы одного и того же спектра, а не разные «виды» участников. Каждый член команды думает о сути и каждый может участвовать в разработке.

Мой вывод из этого всего такой

Если вы технарь, который думает, что его работа просто кодить — вам осталось недолго отсиживаться. Учитесь думать о юзерах, продумывать сценарии использования продуктов и строить архитектуру на основе этого. Вы теперь — архитекторы и CPO в одном лице.

Если вы аналитик или менеджер и не построили ни одного рабочего AI-проекта хотя бы для фана — вы почти безнадежно отстали. Claude/GPT в руки и срочно пилить свой проект, причем до самого победного конца! Чтобы работующая версия была задеплоина. Поверьте, это проще чем кажется, именно поэтому это все делают.

В общем и целом, AI сжимает пространственно-временной континуум разработки по всем осям: время, необходимый опыт и знания, стоимость. Причем не на Х%, а на порядок!

И вопреки расхожему мнению, что в IT теперь зайти очень сложно, мол джуны никому не нужны — я ответственно заявляю обратное! Это джунам больше не нужны компании, чтобы зайти в IT! Каждый может построить свой цифровой продукт, легко и просто, с минимальным понимаем технической стороны вопроса.

И да, я знаю, что вы сейчас подумали: «да, конечно, навайбкодят там из гомна и палок, а на масштабе и под нагрузкой все развалится». Да, вы правы, развалится. Но какой процент проектов и стартапов вообще доходит до нагрузки? 1000 юзеров еще нужно привлечь. А если у вас есть 1000 юзеров — почему у вас еще нет инвестиций или выручки, чтобы нанять 1 архитектора с ChatGPT/Claude? 😊

Всем отдуши рекомендую поучаствовать в каком-нибудь крупном хакатоне, чтобы почувствовать эту атмосферу, особенно если вы не айтишник 🎮

Заместители


Видео недоступно для предпросмотра
Смотреть в Telegram
Artificial: человек-паук в роли Сэма Альтмана и Юра Борисов в роли Ильи Суцкевера

Вышел тизер фильма, который обещают релизнуть в январе 2027. Фильм расскажет про драматический момент OpenAI, когда Сэма уволили с позиции гендира в 2023 году, но потом он отвоевал свое место в компании назад.

Актерский состав — вкуснятина. Эндрю Гарфилд (который сыграл самого плаксивого из всех человеков-пауков) и наш слоняра — Юра Борисов — в роли Иль Суцкевера ❤️

Да, интересно, как бы все развивалось, если бы Альтман не остался у руля...

Жанр: биография, комедия и драма.

Это мы ждем, это мы смотрим 👍

Заместители


Структурный сдвиг на рынке AI — NVIDIA покупает Hugging Face 🤗 за $12.9 млрд

HF это гитхаб в мире AI — крупнейший репозиторий опенсорсных моделей и датасетов. Сейчас платформа хостит больше 3 млн моделей, 500к датасетов. А используют ее более 18 млн разрабов и 200 тыс компаний. Наверное каждый DS хоть раз в жизни да деплоил модельку оттуда ⌨️

И хоть начинали HF как просто репозиторий — недавно платформа начала предоставлять вычислительные мощности для развертывария мини AI приложений. Сейчас таких приложений хостится более 1 млн.

Тем временем NVIDIA в последнее время сильно топит за опенсорсные и локальные модели. Интерес компании понятен — они создают спрос на свое железо. В частности на свои домашние суперкомпьютеры DGX Spark.

При этом OpenAI, Google и другие AI-гиганты потихоньку пилят собственные чипы и пытаются меньше зависеть от NVIDIA. И компании нужно срочно принимать ответные меры. А на кого делать ставку, если корпоративные клиенты хотят свалить? Правильно — на того самого разраба, который скачал квен и хочет его где-то быстро и легко развернуть.

Вот и получается, что подмять под себя крупнейшую опенсорс платформу в мире AI — это шикарная возможность компенсировать потенциальную, даже пускай еще отдаленную потерю жирных клиентов типа OpenAI.

Что теперь будет?

Hugging Face до сих пор были достаточно нейтральной площадкой. Любая модель на любом железе: AMD, Apple Silicon, Google TPU и NVIDIA.

А теперь площадкой завладеет NVIDIA. Но СЕО компании, Дженсен, сразу нас успокаивает: Hugging Face продолжит поддерживать разные модели, облака и железо. NVIDIA compute для работы с платформой тоже не станет обязательным.

И я могу в это поверить. Ведь достаточно сделать так, чтобы запуск на железе от NVIDIA был бы самой удобной и выгодной опцией. Что несложно сделать, если ты владеешь всей платформой 😊

Сделку еще должны одобрить регуляторы, а закрытие ожидается в первой половине 2027 года. Но препятствий не намечается. Врядли кто-то прямо сейчас захочет ссориться с главным поставщиком вычислительных мощностей в мире.

Если все будет как обещает Дженсен, то для нас с вами тоже все станет только лучше — HF зальют железом и деньгами, а значит опенсорс получит мощный буст в развитии 📈

Заместители


GPT-6 Astra здесь

Первые впечатления. Коротко — ставка на эффективность. Тратит токенов меньше даже GPT-5.6 Sol. Но это компенсируется более высокой ценой — 10$/50$.

По интеллекту до Fable 5.1, возможно, все-таки не дотягивает. Хотя пока сказать сложно — бенчмарки противоречивые. ARC-AGI 3 модель решила полностью, сильно лучше Opus 5 (UPD все потому что это прохождение с харнессом, а не чисто модели — а таким макаром этот бенчмарк проходят многие и легко. Так что про этот бенчмарк расслабляемся). А вот на Artificial Analysis Index модель осталась на уровне GPT-5.6 Sol.

Сделали большой упор на безопасность и снижение галлюцинаций.

Также обещают феноменальное управление компьютером. Возможно поэтому ARC-AGI 3 так хорошо решен.

Рекомендую помимо официального релиза читать вот этот обзор от Artificial Analysis — там детально разложили модель по бенчмаркам.

Модель пока все еще не доступна в подписке — обещают завезти в ближайшие дни.

Заместители


Одна TimesFM вместо тысячи моделей

Google выпустила TimesFM-3, новую версию своей zero-shot модели для прогнозирования временных рядов.

Сначала, разберемся, что это за zero-shot

Zero-shot модели не нужно дообучать под каждую отдельную задачу, потому что их заранее предобучили на огромном количестве данных, и она обобщает полученные знания на другие временные ряды. Например, вот эту TimesFM-3 предобучили на 1 триллионе временных точек в разных задачах. И это позволяет просто закидывать временной ряд и получать уверенный неплохой прогноз.

Важно отметить, что специально обученные под конкретную задачу модели часто будут выигрывать у zero-shot моделей. Но во-первых, иногда важна не точность, а массовость и время до деплоя. На все задачи не наобучаешься моделей, а тут можно сразу получать приемлемый прогноз.

А во-вторых, при желании zero-shot модели можно использовать как базу для построения специализированных моделей прогнозирования.

Теперь про апдейт — он получился хорошечным

Главное ограничение предыдущих TimesFM вплоть до версии 2.5 заключалось в том, что они были одномерными. Модель смотрела на историю одной переменной и по ней предсказывала значения этой же переменной в будущем.

Например, хотим узнать продажи мороженого: загружаем исторические продажи → получаем прогноз продаж.

Но реальные задачи обычно сложнее — они многомерные. Продажи одного товара связаны с продажами других товаров, посещаемостью магазина, погодой, скидками и праздниками.

TimesFM-3 сделали многомерной и научили работать со всей этой картиной. Причем здесь есть сразу несколько сценариев многомерности.

Первый сценарий: при прогнозе модель учитывает дополнительные исторические факторы. Например, вместе с продажами можно передать прошлую посещаемость магазина.

Второй: модель учитывает известные будущие факторы. Календарь скидок, праздники или прогноз погоды помогают скорректировать прогноз на конкретные даты.

Третий: модель прогнозирует сразу несколько рядов. Можно загрузить продажи мороженого, рожков и сиропов и получить прогноз для всех трех товаров. Связи между ними модель тоже учтет.

Эти сценарии можно объединять. Например, одновременно прогнозировать несколько товаров с учетом прошлой посещаемости и будущих скидок.

В TimesFM 2.5 дополнительные факторы тоже можно было подключать через внешний XReg. В новой версии несколько временных рядов внутри самой модели.

Про технику

Ради перехода к многомерности переделали attention. Модель отдельно следит за тем, как каждый показатель меняется во времени, и за связями между разными показателями.

Изменился и сам способ построения прогноза. Раньше TimesFM генерировала часть прогноза, добавляла ее в контекст и переходила к следующей части. Поэтому ошибка на одном участке могла потянуться дальше. В третьей версии — TimesFM прогнозирует на весь горизонт за один проход. Это быстрее, а ошибки не накапливаются.

Модельку уже выложили на GitHub и Hugging Face. Интеграцию с BigQuery обещают следом. По бенчам впереди сопостовимых моделей.

Забираем в арсенал моделей для прогнозирования 📈

#ИИстатья

Заместители


Там Fable 5.1 новый выкатили

И единственное, что хочется сказать — ну выкатили и выкатили...

Хотя бы формально теперь сделали его умнее Opus 5 😁 Соотношение цены-качества постарались чутка выровнять за счет снижения стоимости чтения кеша. Обещают, что в среднем цена выполнения задачи будет на 25% дешевле чем у Fable 5.

То есть теперь всего лишь в полтора раза дороже Opus 5 и всего лишь в 3 раза дороже GPT 5.6 Sol 🤡

На фоне релизов китайских моделей по перфомансу немного отстающих от Fable при этом за сущие копейки — выглядит этот апдейт отчаянной попыткой удержать аудиторию.

Лучше бы уже релизили новый Opus. Модель всем нравится, цена адекватная, по перфомансу на реальных задачах местами даже лучше фейбла. А фейбл оставьте в лаборатории, пока до AGI не дорастет.

Fable все больше похож на концепт-кары в автоиндустрии, которые выкатывают просто чтобы поохать в соцсетях и через день забыть о них до следующей новости.

Заместители


Perplexity Computer теперь можно поселить у себя под столом

Perplexity вместе с NVIDIA выпустили Portable Computer — локальную версию своего AI-агента «Computer».

Причем локально работает не только LLM, а весь харнесс:
• специально дообученная PPLX 27B (на базе Qwen 3.8)
• оркестратор и планировщик
• поиск по локальным файлам
• вызов инструментов
• создание sandbox для безопасной работы агента

То есть можно дать агенту доступ к своим документам и коду, но данные при этом будут обрабатываться полностью локально.

Но что если 27B-модельке не хватит мозгов? 🤔

Тогда агент может обратиться за помощью к большой облачной модели. Но сделает это только с вашего одобрения и явно подсветит, какой контекст придется отправить в облако.

Получается примерно так:

PPLX 27B работает локально → упирается в сложную задачу → спрашивает Opus → получает совет → продолжает работать сама.

И они даже померили, насколько такой Франкенштейн хорош. На Terminal Bench 2.1 замерили три сетапа:

1. Если все отдать только локальной модели, то агент выбьет стыдные 59.6%.
2. А вот если дать локальному агенту консультироваться с Opus 5 то уже солидные 73.0%.
3. Чисто Claude Opus 5 выбивает, конечно, больше — 82.4%.

Но такова цена приватности. И, кстати о цене, — решение задачи в гибридном формате в среднем обходится в $0.42 за задачу против $0.65 у чистого Opus. Так что еще и экономия.

Сам подход, конечно, не новый. Уже сейчас многие распределяют работу между моделями: например, сложное планирование отдают GPT-5.6 Sol, а исполнение — более дешевой Luna.

Но тут следующий логичный шаг — исполнитель вообще переезжает из облака к вам на компьютер. А дорогую фронтирн-модель зовёт только когда уже невмоготу.

Полностью локально, но есть нюанс…

Точнее два 😁

Во-первых, пока Portable Computer официально работает только на NVIDIA DGX Spark. А это, на минуточку, домашний суперкомпьютер за $5к+ на 128 GB. Хотя самой PPLX 27B столько мощи не нужно — ей надо только 28 GB памяти.

Конечно, нужно пространство, чтобы параллельно бегало несколько сабагентов. Но потенциально даже такой сетап можно спокойно перенести на MacBook с 48–64 GB unified memory или ПК с RTX 5090 32 GB. Поддержку обычных RTX, кстати, Perplexity таки обещает завезти попозже. Но сейчас нам впаривают какую-то дичь…

А во-вторых, следите за руками: модель локальная, железо ваше (ну когда вы заплатили да него 5к), электричество ваше. А подписка Perplexity Pro или Max все равно нужна 🤡

То есть, по сути, в аренду сдают просто удобный харнесс.

И вот получается вроде ругаться хочется… осадочек какой-то неприятный. Но такая гибридная реализация сейчас из коробки только у них. И тут уж право первых…

#заместители

Заместители


Видео недоступно для предпросмотра
Смотреть в Telegram
Anthropic сделала MCP для физического мира

Компания представила Model Hardware Standard⁠ — единый стандарт, через который AI-агенты могут управлять лабораторным и промышленным оборудованием: микроскопами, роботизированными манипуляторами, дозаторами и даже компонентами квантовых компьютеров.

Интересно, что с роботами в основном идет развитие через обучение специальных моделей под управление конкретными роботами. Там это обосновано тем, что роботы только зарождаются, и мы можем их развивать параллельно с моделями. К тому же у многих разрабов робототехники есть желание сделать вендор лок на свое ПО.

А вот с лабораторным оборудованием все сложно — оно существует очень давно, оно очень разнообразное и слишком дорогое, чтобы переделывать его под какие-то новые универсальные AI модели. А обучать собственные модели и делать своих агентов желания, да и часто возможности,
у большинства производителей нет. При этом каждое устройство говорит на своем языке.

Поэтому сейчас на объединение оборудования в одну систему для экспериментов у ученых уходят недели или месяцы.

MHS предоставляет универсальный стандарт с простыми командами вроде read и write, описывает возможности и ограничения устройства, а затем отдает управление любому AI агенту — в том числе через MCP.

MHS протестили уже в реальном мире

- В Genentech — научили робота правильно наливать разные жидкости 👨‍🔬

Claude управлял автоматической пипеткой, роборукой и прибором для измерения концентрации белка. Вода и густой белковый раствор наливаются по-разному: если качать белок слишком быстро, возникают пузырьки и измерения портятся.

Claude несколько раз переливал жидкости, проверял результат и в итоге сам подобрал подходящую скорость для каждой.

Правда пока не без подсказок ученых — модель сначала решила бороться с пузырьками ровно обратным способом — перемешивать раствор ещё сильнее. Тут людям пришлось вмешаться и объяснить Клоду физику проблемы.

- В QuEra Claude научился возвращать к жизни лазер квантового компьютера 🐈‍⬛

Для работы квантового компьютера частоту лазера нужно удерживать с огромной точностью. Температура, вибрации и даже изменение давления вокруг могут сбить настройку. Обычно специалист вручную проверяет несколько регуляторов и возвращает лазер в рабочее состояние за 5–10 минут.

Claude сотни раз намеренно сбивал и заново настраивал лазер квантового компьютера. За ночь агент превратил линейный алгоритм восстановления в дерево решений. Готовый скрипт прошел 700 испытаний, восстановив лазер в 695 случаях — 99,3% успешности. И теперь восстановление лазера занимает от 0,9 до 14 секунд.

MHS пока доступен только в рисерч превью по запросу. Но позже Anthropic собирается открыть стандарт.

Большой шаг к Physical AI.

Заместители


OpenAI: «вы и ваша мама будут использовать одного AI агента»

Ещё недавно мы с вами говорили: как круто будет, когда у нас появится AI коллега, или даже команда AI агентов, которая заменит весь скучный ручной труд. А мы будем попивать джус и с телефона отправлять задачи этим агентам 😁 Но вот будущее наступило. И оказывается это не все, чего мы хотели. И вообще мы хотели как раз наоборот — никакую не команду AI агентов.

Но обо всем по порядку

Недавно xAI релизнули интересную штуку — Grok Bot. И AI комьюнити сильно возбудилось на этот счёт. Ведь это те самый AI коллеги, как по учебнику.

Идея простая: вы отдаете задачу той самой команде, состоящей из агентов-специалистов, а они решают ее в тесной коллаборации разделяя задачи между собой. Вот главный Chief of Staff, под ним рисерчер, тестировщик, дизайнер, ассистент по разгребанию почты и тд. Каждый агент настраивается. У него свой "компьютер", память и обязанности. И, конечно, они могут общаться между собой!

Ну, сингулярность наступила, подумаете вы. Но штука в том, что сингулярность уже улетела далеко вперед. А Grok Bot теперь выглядит как достаточно простой и чисто инженерный шаг от Grok Build (аналог Claude Code и Codex) — его просто размножили и настроили возможность отправлять сообщения разным сессиям друг другу.

Кстати, исходники Grok Bot утекли в сеть ровно по той же схеме, что и Claude Code. Так что, немного подшаманив, можно запустить даже с OpenRouter потестить эту штуку 🎹

Но где теперь эта ваша сингулярность?

Сформулировался новый магнум опус — единый агент, который самостоятельно адаптируется под абсолютного любого юзера и его задачи. Может показаться, что вышеупомянутые агенты уже это делают. Но речь про совершенно другой UX.

Больше никаких скиллов, геморроя с ручным описанием должностных обязанностей агентов, выбора нужных моделей с правильным эффортом и харнессом. Ведь будем откровенны — это все костыли. И даже Grok Bot на фоне этой концепции — костыль.

Суть в максимальном отказе от ручных настроек и повышении эффективности работы. Вы просто "живете" вместе с этим агентом, а он смотрит, изучет, впитывает ваш образ жизни. И потом придумывает как все это дело автоматизировать да еще и эффективно, параллеля и оптимизируя работу.

Как попасть в это светлое будущее?

Чтобы добиться такого UX понадобятся лучшие из лучших:
1. Существенно более высокая скорость и низкая стоимость вычислений. Моделям придется пропускать через себя существенно больше информации.
2. Адаптивный UI. В идеале дописываемый агентом. Codex или Claude Code — это каменные рамки. За них нельзя выйти, и толком поменять. В будущем же одному сервису понадобиться уметь подстраиваться налету под нужды любого: программиста, менеджера, врача, художника, юриста, ученого и тд. А им всем нужны свои приколы в UI. Юристу — работа с судебными делами и НПА, а врачу — просмотрщик рентген снимков.
3. Модели поумнее. Казалось бы куда уж еще. Но текущего уровня все еще маловато. Они слишком заточены под бенчмарки, слишком склонны соглашаться и тд. Все эти проблемы все еще достаточно сильно сдерживают нас.

И похоже ближе всех к этому уровню подобрались OpenAI

Об этом в интервью рассказал Тибо — батя Codex и продакт лид всей платформы OpenAI. Загибаем пальцы:
1. Ultrafast режим + их собственные процессоры Jalapeño. Быстрый режим, кстати, рано или поздно станет дефолтным для всех юзеров.
2. Адаптивный UI — их цель по словам самого Тибо. А слияние ChatGPT и Codex — шаг в этом направлении.
3. Model Astra. Та самая модель, которую в закрытом режиме показывают правительству США и все никак не релизнут. Уж не знаю, насколько она мощна, но сами OpenAI в нее сильно верят 📈

На выходе — Тибо пушит платформу OpenAI к такому виду, чтобы и вы и ваша мама или бабушка общались с одним и тем же ботом. Но со временем он будет сильно персонализироваться, сам развивать необходимые скиллы и поддерживать их актуальными, сам управлять армией сабагентов и делать это все супер-эффективно.

Вот так незаметно, как это обычно и бывает, мы подбираемся к реалистично сформулированному AGI.

Заместители


Неизвестная фронтир-модель раздается бесплатно в стелс режиме

Темная лошадка, точнее темный бычок появился на OpenRouter. Новая стелс-модель Ox Alpha. Кто её сделал — официально неизвестно. Но ее стали раздавать с беспрецедентным размахом — бесплатно отдают до 100 триллионов токенов в день 😮

Известный джейлбрейкер Pliny the Liberator, тот который Fable 5 ломанул, делает ставку на то, что под капотом скрывается новая GLM 5.x от Z.ai.

Но это пока спекуляция — разрабы тщательно скрывают модель.

А бычок то нехилый

- 1 миллион контекст
- до 131K токенов на выходе
- настоящая мультимодальность на входе: кушает текст, картинки и видео 🧐
- полноценный reasoning
- заточен под долгую работу и агентные задачи.

Похоже Ox Alpha — фронтирная модель. В независимом прогоне бенчмарка DeepSWE она выбила 63%. Это чуть чуть хуже Grok 4.6 high, и четко на уровне DeepSeek v4 pro max(!). Но только сильно эффективнее по количеству потраченных токенов — а значит потенциально еще дешевле.

Но самое важное — Ox Alpha бесплатно раздают на OpenRouter

Я гоняю ее пару дней на max reasoning в OpenCode— мне заходит! Воду не льет, действительно долго самостоятельно работает, уточняющие вопросы задает по делу.

На реддите отзывы смешанные. Но дареному коню в зубы не смотрят. Бесплатно такое мы точно забираем ☀️

Только рабочие секреты туда пока не суйте: OpenRouter отдельно предупреждает, что анонимный провайдер сохраняет все промпты и ответы.

P.s. представьте шок, если это окажется новый Гигачат на базе GLM 😁

Заместители


Помните того парня, который сделал вакцину от рака для своей собаки

Я рассказывал о нем вот тут. Продолжение истории, к сожалению, не такое радужное. Но в то же время важное.

К сожалению, у Рози после достаточно долгой ремиссии внезапно после очередной операции с новой силой активизировался рак (был ли это рак, который победили или второй, который Пол только планировал вылечить — не уточняется). И очень быстро, буквально за месяц, болезнь стала слишком серьезным противником для маленькой собачки. Хозяину, который так долго боролся за нее, пришлось признать поражение и усыпить Рози 💻

Но есть в этой истории и светлая сторона

Эта история прогремела на весь мир и стала маяком надежды для всех, кто борется с этим страшным заболеванием 🙏

И хозяин Рози, Пол, который явно не из тех, кто быстро опускает руки — несмотря на тяжелый и внезапный исход истории — продолжил свое дело.

Он основал компанию Gamgee и прошел отбор в YCombinator. А вчера получил первые инвестиции в $4 млн. Сущие копейки по меркам AI стартапа в биотехе.

Но эти деньги пойдут на две важные вещи:
1. Клинические испытания протокола по созданию персональной мРНК вакцины от рака для собак.
2. На непосредственную помощь собачкам, которым поставили этот диагноз.

То есть компания не просто пилит какое-то очередное псевдопрорывное ПО, а продолжает тестировать сработавший для Рози подход и параллельно пытается помочь другим собакенам.

И за это огромный респект Полу ☀️

Что ещё тут важно

AI все чаще используют для серьезного биотеха. Он и дизайнит новые вирусы 🦠 (безобидные и даже полезные).

И новые белки разрабатывает. Антропики пару дней назад рассказали, как Claude разработал дизайн новых белков. В данном случае minibinder — белков-связывателей. Такие «минибиндеры» используют, чтобы находить какой-то другой белок-мишень в организме, цепляться к нему и как-то на него воздействовать. Клод справился лучше кожаных: среди его кандидатов успешно справлялись со своей задачей до 35% биндеров. Среднеотраслевой саксес рейт — 15%.

До недавнего времени схема работы в биотехе в основном выглядела так:

Учёный - основной мозг процесса → пользуется специальными AI типа AlphaFold → получает от них проверки своих гипотез и придумывает новые. И так по кругу до получения набора кандидатов для испытаний в лабе.

Но теперь это становится больше похоже на процесс разработки с помощью агентов.

Учёный ставит задачу → универсальный AI агент типа Claude сам все планирует → запускает в параллель сабагентов проверять кучу гипотез → каждый агент использует инструменты, среди которых другие модели типа AlphaFold + научная литература + код и вычислительные ресурсы → на выходе готовые кандидаты вирусы и белки для тестирования в лаборатории.

Помните, все ругались на 1 китайскую лабораторию, которая недосмотрела за 1 вирусом? Теперь представьте что у нее есть агент, который штампует такие вирусы как пирожки. А, и таких лабораторий - сотни по всему миру 😐

Заместители


Грамотный GR от Anthropic в одной картинке

Обычные юзеры: Overloaded. Попробуйте позже.

Claude for Government: 100% uptime 🎰

А полез я смотреть статус работы сервисов Антропика потому что последние дни стал очень плохо работать Claude — сначала без объяснения причины не мог стартануть сессию по 10 минут. Потом уже стал просто честно писать, что сервера кончилися 🤙

Нехватка видеокарт накрывает все сильнее. Еще одна причина иметь запасную локальную модельку, на которую вы сможете переключиться в случае чего.

Заместители

Показано 20 последних публикаций.