ideasAI / Идеи для ИИ - Анисимов Андрей


Гео и язык канала: Россия, Русский
Категория: Технологии


Андрей Анисимов
Идеи для искусственного интеллекта
Канал про Data Science, ML/AI и карьеру в сфере анализа данных
AI BP в Альфа Банке, Согаз, ГПБ, Сбер, ВТБ
SKOLKOVO MBA15
Бег 1x42.2, 3х21.1
Пишите @aaanisimovvv

Связанные каналы  |  Похожие каналы
Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


20 октября пройдет AI Native Conf 🔥

Конференция будет в Москве, в кластере "Ломоносов".

Программа собрана вокруг темы, которая сейчас уже важнее очередного сравнения моделей: что происходит с разработкой, продуктом и управлением, когда AI реально встраивается в работу компании, например:

🔵как Авито внедряет AI-first разработку;
🔵как считать экономику ИИ и не путать хороший пилот с хорошим бизнесом;
🔵как идти от чата с ИИ к автономным мультиагентным командам;
🔵почему сотрудники не используют AI, даже когда им уже всё купили и включили;
🔵как менеджеру освободить себе два дня в неделю с помощью ИИ;
🔵что происходит с продуктовой работой, когда delivery внезапно перестаёт быть главным тормозом.

Формат программы очень плотный: 4 параллельных потока, 19 докладов, воркшопы и C-Level клуб. Среди спикеров - Авито, Яндекс, представители банков и других сфер.

Можно прийти офлайн в "Ломоносов" или смотреть онлайн - трансляция будет со всех четырёх потоков. Ссылка ainativeconf.ru

Интересного много, я бы посмотрел на секции про агентную разработку и управление. По программе там как раз конкретные кейсы: где агенты реально ускоряют работу, где всё упирается в процессы и почему хороший пилот ещё ничего не говорит о том, получится ли масштабировать его на компанию.

Если работаете с AI не ради галочки, а пытаетесь встроить его в нормальный рабочий процесс - конференция будет очень полезной. До встречи на конфе!)

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


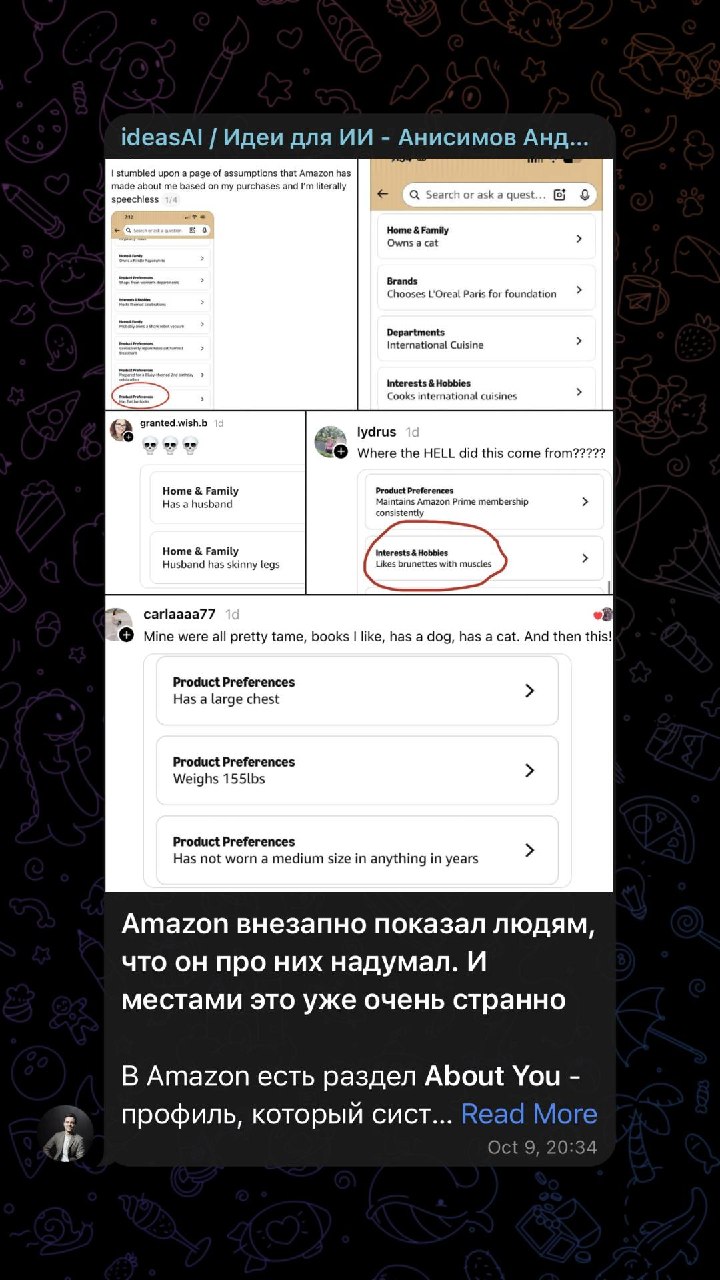
Amazon внезапно показал людям, что он про них надумал. И местами это уже очень странно

В Amazon есть раздел About You - профиль, который система собирает из покупок, поисков, отзывов, списков и общения с Alexa for Shopping. Он нужен для персонализации рекомендаций.

Но пока эта штука не завирусилась, мало кто вообще представлял, насколько далеко заходят такие выводы.

🔝 Всё началось с пользовательницы, которая открыла свой профиль и увидела там характеристику «has flat buttocks» - буквально «плоские ягодицы”». Пост за сутки набрал больше миллиона просмотров, и дальше люди массово полезли смотреть, что Amazon решил про них.

У кого-то Amazon решил, что человек живет с мужем по имени P.P. McGuire. Пользователь вообще не понимал, кто это такой. У других всплывали предположения про увлечения, характер, бытовые привычки, тело и отношения.

🤦‍♂ Сам Amazon объясняет это довольно прозаично: модель смотрит на историю покупок и взаимодействий и пытается понять, какие товары и интересы вам могут быть релевантны. Компания отдельно утверждает, что для About You не использует сторонние данные - выводы строятся по активности внутри Amazon.

Гораздо интереснее увидеть в одном месте какую именно модель человека компания собирает из вполне обычных действий.

🔵Купили легинсы - система сделала вывод про фигуру.
🔵Искали товары для питомца - решила, кто у вас живёт дома.
🔵Смотрели определённые категории - получила ещё один кусок профиля.

Обычно всё это спрятано внутри рекомендательной системы.

Amazon позволяет редактировать или удалять отдельные предположения из профиля, но это не стирает саму историю активности, на которой они были построены.

Теперь бот ещё и делает выводы 😂

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


В Telegram появились мошенники с КНИГАМИ 🤯

В комментариях появляется человек, вполне естественно рассказывает о какой-нибудь интересной книге: что прочитал, что понравилось, чем она полезна. А потом как бы между делом предлагает: «Если хотите — могу дать послушать».

У нас в комментариях такое теперь появляется буквально через день. А вчера было вообще два раза за один день 😂

Оказывается, это уже вполне известная мошенническая механика.

Банк России отдельно предупреждает о рассылке «полезных» файлов в социальных сетях и мессенджерах. Маскировка может быть максимально безобидной - например, бесплатная электронная книга.

После скачивания вредоносного файла злоумышленники могут получить дистанционный доступ к устройству, включая SMS и другие функции смартфона.

🔷Можете сами прочитать предупреждение Банка России

«Лаборатория Касперского» в этом году тоже описывала атаки прямо через комментарии крупных Telegram-каналов и групповые чаты.

Пользователя постепенно уводят в другой канал или бот, а дальше предлагают скачать APK. Вместо обещанного приложения человек получает банковский троян Mamont. Эксперты Kaspersky нашли более 400 подобных сообщений только в рамках одной кампании.

🔷Разбор от «Лаборатории Касперского» оставил здесь

Причём социальная инженерия здесь отличная. Вам не начинают с «переведите деньги» или «сообщите код из SMS». Сначала с вами просто обсуждают книгу.

Человек выглядит как обычный подписчик, сообщение соответствует теме разговора, а предложение поделиться аудиокнигой выглядит совершенно естественно.

🔝 Если незнакомый человек предлагает книгу, а дальше для её получения нужно перейти в бота, открыть какой-то сайт, авторизоваться через Telegram или тем более установить APK — ничего не устанавливаем.

А сообщения про «классную книгу, могу дать послушать» я теперь воспринимаю совсем иначе 😅 Будьте бдительны!

🔥 - поняли, приняли и будем аккуратнее

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


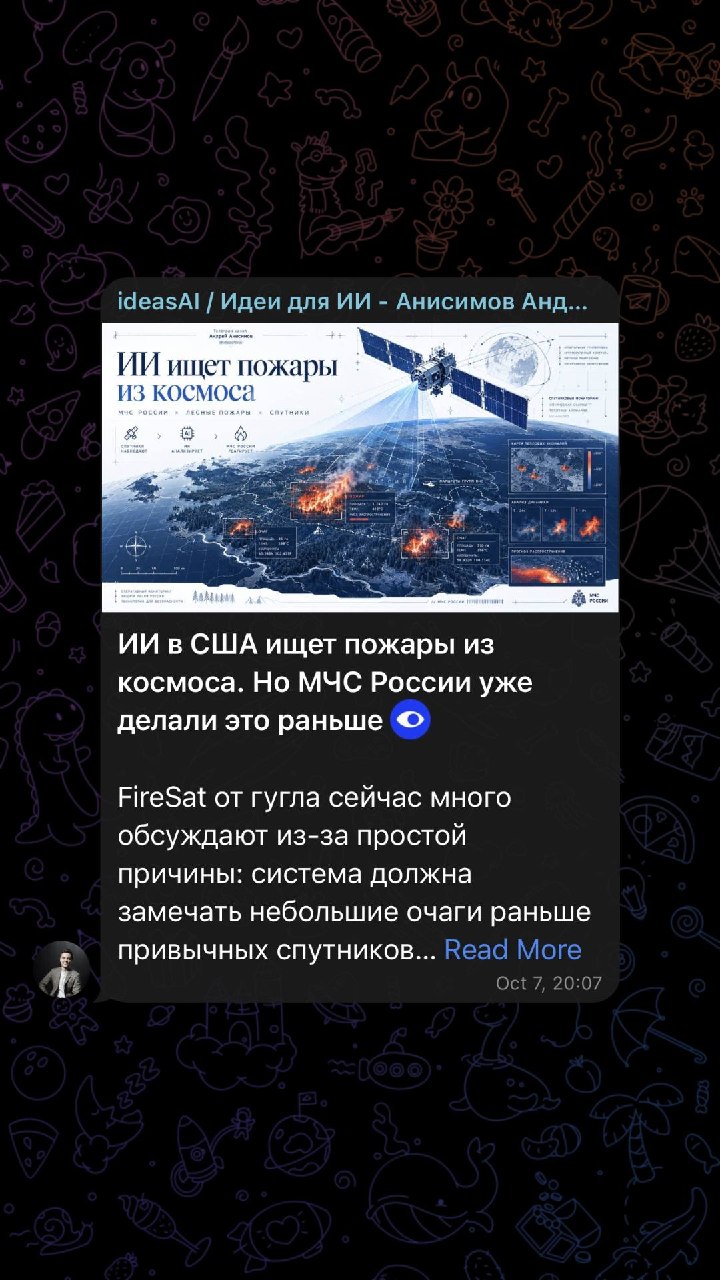
ИИ в США ищет пожары из космоса. Но МЧС России уже делали это раньше 🌝

FireSat от гугла сейчас много обсуждают из-за простой причины: система должна замечать небольшие очаги раньше привычных спутниковых сервисов, а в перспективе обновлять картину по Земле примерно каждые 20 минут.

Похожий подход у нас начали обкатывать ещё несколько лет назад. В 2020-м ИИ разбирал уже найденные термоточки. В 2021-м его начали использовать ещё и для прогноза развития пожара. FireSat двигает задачу ещё раньше - к моменту, когда очаг только появился и старые системы его ещё могут не заметить.

Еще 6 лет назад МЧС России проводило соревнование по автоматической классификации природных пожаров по спутниковым данным.

Алгоритм должен был отличать лесной пожар, торфяной, пал травы и техногенные источники тепла. Победившее решение, по данным МЧС, показало точность выше 92%.⁠

В 2021 году на AI Journey Contest уже использовали датасет МЧС с 660 254 наблюдениями за 2012-2021 годы. На таком объёме можно было учить модели не по отдельным кейсам, а на большой исторической базе.⁠

И в том же году на хакатоне МЧС, Росгидромета и Рослесхоза участники решали ещё одну задачу - раннее обнаружение и прогноз роста площади крупного ландшафтного пожара.

ИИ уже пытались использовать не только для ответа «горит или нет», но и для оценки того, что будет дальше. ⁠

Для пожарных здесь важнее всего не сама спутниковая картинка, а выигранное время.

Если система раньше замечает очаг, отбрасывает ложный сигнал, понимает, что именно горит, и помогает оценить развитие ситуации, выезжать можно уже не на пожар в десятки гектаров, а на его начало.

Полезное применение ИИ было еще до того как стало мейнстримом…

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Google Antigravity: теперь ИИ можно отдать не кусок кода, а кусок работы

У Google есть Antigravity - среда разработки, где агенту можно поставить задачу целиком и не сидеть рядом, наблюдая, как он пишет каждую функцию.

🔍 Обычный Copilot помогает вам программировать. Antigravity пытается сам сходить в код, терминал и браузер, внести изменения, запустить проект, проверить результат и вернуться с тем, что получилось. Google прямо называет это agent-first подходом.

Допустим, нужно добавить в интернет-магазин новую форму оплаты.

В обычном сценарии вы по очереди просите ИИ написать компонент, подключить API, исправить ошибку, сделать тесты. Здесь можно поставить задачу крупнее: "добавь оплату, проверь существующий код, подключи API и убедись, что всё работает в браузере".

🔷Дальше есть Agent Manager. В Antigravity 2.0 можно держать несколько локальных агентов одновременно, разнести их по разным рабочим пространствам и дать каждому свою часть работы. Один занят интерфейсом, второй разбирает бэкэнд, третий может проверять другой участок проекта.

Вы меньше работаете в режиме "напиши мне следующие 30 строк" и больше - "разберись с этим куском задачи и покажи, что сделал".

⚙️ Чтобы такая автономность не превращалась в чёрный ящик, в IDE есть artifacts - агент оставляет планы и результаты работы. Плюс есть browser-in-the-loop: агент может реально открыть интерфейс и проверить его в браузере, а не объявить победу просто потому, что код собрался.

Отдельно Google сделал Antigravity CLI для работы с агентами из терминала и SDK - если хочется собирать уже собственные агентные сценарии поверх их системы.

Разработчику всё чаще нужно уметь не только хорошо писать код, но и нормально отдавать работу агенту. Разбить задачу, дать нужный контекст, определить границы и потом понять, где он сделал хорошо, а где уверенно построил ерунду.

И на больших задачах эта разница уже гораздо заметнее, чем очередные +5% в бенчмарке модели.

👌 А здесь хороший базовый разбор интерфейса и самой логики работы, кому интересно: посмотреть видео

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Лучшие навыки работы с ИИ заранее не придумаешь. Они появляются уже после внедрения ⚙️

Можно заранее расписать AI skills, отправить людей на обучение, придумать матрицу компетенций. А потом выяснится, что самый полезный навык в команде вообще появился случайно - когда новый инструмент столкнулся с реальной работой.

Исследователи три года наблюдали за 10 европейскими производственными компаниями, которые внедряли коллаборативных роботов, mixed reality, 3D-печать и цифровой мониторинг.

🔝 И увидели закономерность, что самые важные навыки часто нельзя было предсказать заранее. Они появлялись уже в процессе.

Например, человек начинает понимать, где технология ошибается. Или придумывает обходной путь. Или переводит свой опыт и интуицию в понятные правила, которые можно передать системе. С ИИ сейчас то же самое.

Один сотрудник быстро замечает, когда модель начинает уверенно нести ерунду. Другой понимает, какую часть процесса можно спокойно отдать агенту. Третий умеет так описать контекст, что ИИ начинает работать заметно лучше.

И всё это часто полезнее формального навыка "умеет пользоваться ChatGPT". Авторы предлагают модель SPOT:

1️⃣See - смотреть, как люди реально используют новый инструмент.
Особенно интересно, где они что-то обходят, дополняют или делают "не по инструкции".

2️⃣Partner - разбирать эти моменты вместе.
Если человек говорит "я просто чувствую, что здесь надо делать так" - там часто спрятан реальный опыт.

3️⃣Orchestrate - учить на настоящих задачах.
Не на учебных примерах, а там, где есть реальный процесс и реальная цена ошибки.

4️⃣Transform - превращать личную находку в общий навык команды.
Зафиксировать, передать другим, встроить в процесс или в настройки самого AI-агента.

Для руководителя тут довольно практичный вывод - при внедрении ИИ я бы меньше спрашивал: "Чему нам надо обучить всех?" и чаще: "Кто уже придумал, как делать это лучше?"

Потому что самые полезные AI-навыки часто не приходят из курса. Они сначала рождаются у одного человека в работе - и только потом становятся новой нормой для всей команды.


💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Что было за неделю:

➡️Google давно написал инструкцию, как не сделать из ИИ ещё одну бесполезную кнопку в продукте 🧐 прочитать пост⁠

➡️400 000 - это сколько? Почти целая электростанция в Мытищах 🧐 прочитать пост⁠

➡️Пробую Дзен - подпишитесь 🧐 https://dzen.ru/ideasforai

➡️Meta* показала карманного AI-агента. *Meta Platforms Inc. признана в России экстремистской организацией, её деятельность запрещена 🧐 прочитать пост⁠

➡️ИИ может убрать технический долг и создать два новых 🧐 прочитать пост⁠

➡️4000 лет никто не может прочитать этот текст. А что, если дать его ИИ? 🧐 прочитать пост⁠

➡️У почвы тоже есть микробиом. ИИ уже пытается читать его почти как анализ крови 🧐 прочитать пост⁠

➡️У 2ГИС появился MCP-сервер. Посмотрел, есть ли в нём польза...🧐 прочитать пост⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#дайджест


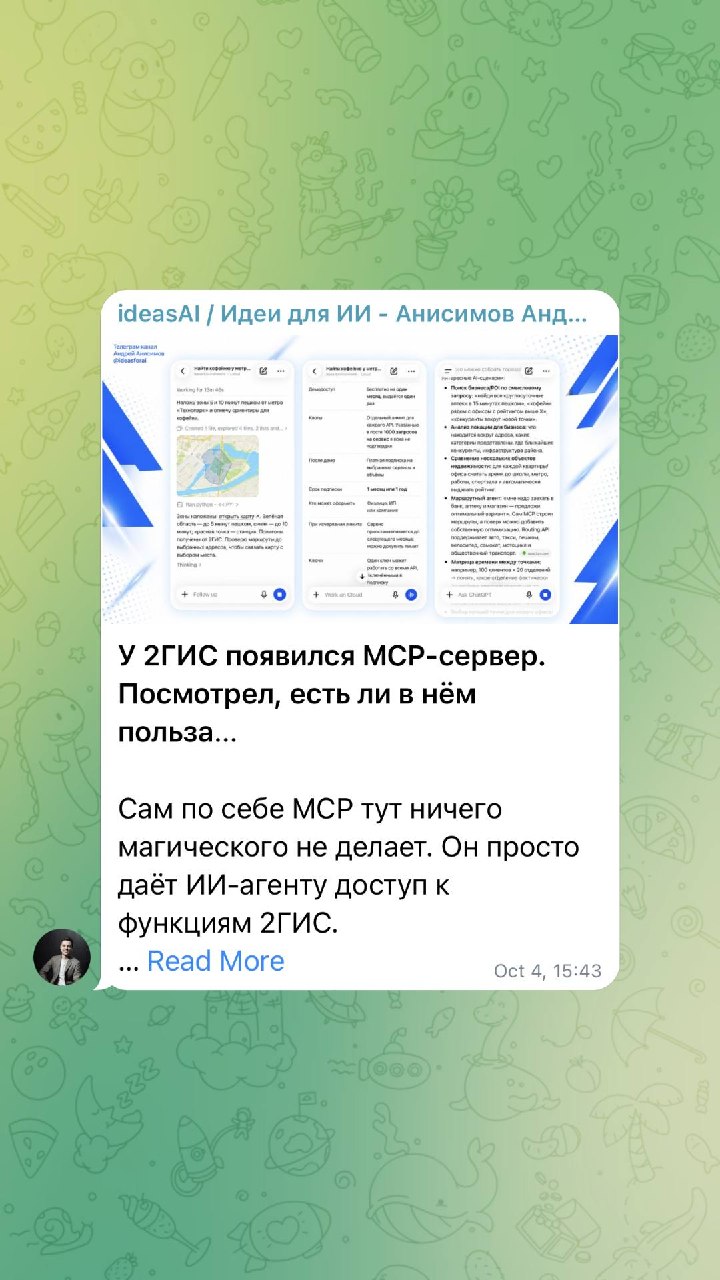
У 2ГИС появился MCP-сервер. Посмотрел, есть ли в нём польза...

Сам по себе MCP тут ничего магического не делает. Он просто даёт ИИ-агенту доступ к функциям 2ГИС.

⭐️ Сейчас их шесть: поиск объектов рядом, геокодирование адресов, обратный поиск адреса по координатам, маршруты между точками, расчёт зон доступности по времени и генерация статических карт.

Агент уже может не просто "найти кофейню рядом", а собрать цепочку из нескольких действий. На скринах - карта пешей доступности от метро в 5 и 10 минутах.

Также пробовали - подключили MCP к Codex и дали бизнес-задачу: сравнить две точки для доставки цветов в Екатеринбурге - у "Геологической" и у "Ботанической".

Условие простое: на машине доставка не должна занимать больше 20 минут. Для проверки взяли четыре адреса в разных частях города. Codex сам:

➡️нашёл координаты обеих точек;
➡️запросил у 2ГИС две зоны двадцатиминутной доступности;
➡️построил маршруты до контрольных адресов;
➡️сравнил время в пути;
➡️подготовил данные для итоговой карты.

Цветные области на карте - изохроны: реальные зоны, куда можно доехать за заданное время по существующим дорогам. Для выбора точки доставки это уже гораздо полезнее.

Можно сравнивать какая локация реально покрывает больше нужных районов за 20 минут. Одну такую задачу, конечно, можно сделать руками в картах.

Но если у вас 30 будущих точек, 200 адресов клиентов, разные интервалы доставки и это надо пересчитывать каждую неделю - тогда MCP начинает экономить время. Его можно использовать для:

1️⃣проверки новых точек перед арендой;
2️⃣расчёта зон доставки;
3️⃣сравнения филиалов между собой;
4️⃣поиска ближайших объектов по заданным условиям;
5️⃣геоаналитики внутри корпоративного AI-ассистента.

Пока продукт сыроват. Геокодер, например, не сразу понял названия станций метро. Итоговую красивую визуализацию тоже пришлось собирать отдельно - MCP дал данные, но не готовый аналитический отчёт в один клик.

Сам сервер бесплатный. Для запросов к 2ГИС нужен API-ключ. Сейчас есть деморежим на 30 дней, а в тестовом кабинете было по 1000 запросов на подключённые сервисы, дальше API уже платный.

P.S. попытался для примера проанализировать карту кофеен - из полезного карта пешей доступности, можно крутить много разной функциональности...

Полезные ссылки:

🔵Официальная документация MCP-сервера 2ГИС
🔵Официальный репозиторий MCP-сервера на GitHub
🔵Менеджер Платформы 2ГИС

#AI_и_работа

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


У почвы тоже есть микробиом. ИИ уже пытается читать его почти как анализ крови 🔍

В одной горсти почвы живут бактерии, грибы и другие микроорганизмы, которые влияют на питание растений, устойчивость к болезням и круговорот веществ. Сейчас исследователи собирают этот микробный "портрет", добавляют pH, углерод, влажность, погоду - и отдают всё машинному обучению.

Задачи очень практические: оценить здоровье почвы, заметить риск болезней, понять доступность питательных веществ и в перспективе точнее прогнозировать урожайность.

Есть уже занятные результаты.

1️⃣В исследовании 2025 года модель по данным бактерий, грибов и свойствам почвы предсказывала, насколько почва способна подавлять грибной патоген Rhizoctonia solani. Лучший вариант показал 98,56% точности на данных этого эксперимента. Это не "диагноз любой грядки с точностью 98%", но само направление уже выглядит серьёзно.

2️⃣А в работе 2026 года по томатам лучший результат получился, когда модели дали сразу микробиом + химические свойства почвы. Отдельно эти данные работали хуже. Исследователи также нашли связь избытка доступного фосфора, изменений микробного сообщества и болезней растений.

В будущем анализ почвы может выглядеть как гораздо более подробная картина: кто там живёт, что эти микроорганизмы делают и что это говорит о состоянии участка.

Но до сервиса "принёс банку земли - AI сказал, что сеять" пока далеко. Авторы прямо пишут, что большая часть таких систем остаётся на уровне исследований и пилотов. Почва очень локальна: модель из одного региона может плохо переноситься на другой климат, состав почвы и набор культур.

Кому интересно почитать:

🔵Обзор 2026 года по AI и микробиому почвы
🔵Исследование про Rhizoctonia solani и 98,56%
🔵Исследование 2026 года по томатам и микробиому почвы

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


4000 лет никто не может прочитать этот текст. А что, если дать его ИИ? 🧐

В 1908 году на Крите археологи обнаружили небольшой глиняный диск диаметром всего 16 сантиметров. На обеих сторонах — спираль из загадочных символов, нанесённых с помощью специальных печатей.

45 уникальных знаков, 241 оттиск, 61 группа символов, предположительно обозначающих слова. И ни одного другого найденного текста, который позволил бы уверенно установить язык.


Это Фестский диск — одна из знаменитых неразгаданных загадок древнего мира.

Недавно наткнулся на статью РИА о лингвисте Гарете Оуэнсе, который заявил, что смог прочитать 99% надписи. По его версии, это религиозный текст, посвящённый богине-матери.

Но академическое сообщество пока не признало расшифровку окончательной. И мне стало интересно: неужели никто не пробовал решить эту задачу с помощью современных нейросетей?

Полез искать по международным площадкам. И нашёл несколько интересных экспериментов.

🟦Google Gemini. В январе 2026 года на SSRN появилась работа, в которой исследователь использовал Gemini для анализа диска. Получилась неожиданная гипотеза: перед нами не молитва, а древняя административная система, своеобразный аналог смарт-контракта, описывающий распределение ресурсов.

🟦GitHub. Нашёл целый исследовательский репозиторий Phaistos Disc Decipherment с цифровыми данными, словарями символов и многоэтапными попытками расшифровки. Авторы даже заявляют, что решили загадку, но независимого научного подтверждения пока нет.

🟦Научные исследования. В журнале Computational Linguistics опубликован большой обзор вычислительных методов дешифровки древних письменностей. Там рассматривают машинное обучение, статистику, сопоставление языков и способы работы с неизвестными системами письма.

Нейросети обучаются на триллионах токенов. А здесь у нас всего 241 знак, неизвестный язык и практически полное отсутствие сопоставимых текстов. Даже если модель предложит очень красивый перевод, как проверить, что она действительно прочитала надпись, а не придумала убедительную историю? 🤔

Я бы попробовал объединить GPT, Claude, Gemini и классические алгоритмы дешифровки. Дать им одинаковую цифровую последовательность символов, заставить независимо построить гипотезы, а затем проверить их статистически и сопоставить с известными древними письменностями.

Причём оценивать не красоту получившегося перевода, а то, насколько гипотеза выдерживает независимую проверку.

Ведь настоящее достижение ИИ — не предложить ещё одну интерпретацию загадки, а найти способ доказать, что она верна.

Кто знает, возможно, именно нейросети помогут нам однажды прочитать послание, оставленное почти четыре тысячи лет назад. А пока загадка остаётся открытой.

Кому интересно почитать:

🔵Исследование с Gemini
🔵GitHub с материалами дешифровки
🔵Научный обзор MIT Press
🔵Оригинал диска в музее Ираклиона

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


ИИ может убрать технический долг и создать два новых 😂

С генеративным ИИ код теперь пишется и меняется быстрее, чем команда успевает его нормально понять. Маргарет-Энн Стори, профессор компьютерных наук Университета Виктории, предлагает смотреть не на один долг, а сразу на три.

🔷Технический долг - это знакомые костыли и временные решения. Здесь ИИ помогает: находит проблемы, пишет тесты, переписывает код, улучшает архитектуру.

🔷Но появляется когнитивный долг.

Код работает, тесты проходят, а команда уже хуже понимает, как всё устроено. Из-за этого люди боятся лишний раз что-то менять, новички дольше входят в проект, а знания остаются у нескольких человек.

🔷И ещё один - долг замысла.

Все видят, ЧТО делает система, но уже не помнят, ПОЧЕМУ она устроена именно так: какие были ограничения, зачем выбрали такую архитектуру, что было критично для бизнеса.

🔍 Вот здесь AI-агенты могут начать очень быстро улучшать вообще не то.

Формально код становится чище, а по факту система уходит от реальных требований: по производительности, приватности, доступности или логике продукта.

Что с этим делать:

1️⃣После крупных изменений кто-то в команде должен уметь объяснить, как теперь работает система.

2️⃣Фиксировать не только решение, но и почему его приняли.

3️⃣Разбирать важные изменения вместе, особенно если большую часть кода написал ИИ. Автор как раз советует регулярные разборы, фиксацию бизнес-контекста и обмен знаниями в команде.

Если команда стала писать код быстрее, но хуже понимает собственную систему - часть долга остается и это сложно назвать успехом..

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Видео недоступно для предпросмотра
Смотреть в Telegram
Meta* показала карманного AI-агента 🤖

Muse Charm выглядит как небольшая отдельная штука с экраном, микрофоном, динамиком и 5G. Но смысл не в самом гаджете. Meta* пытается сделать ИИ не приложением, которое надо каждый раз открывать, а постоянным помощником, который уже подключён к вашим сервисам.

➡️У Muse заявлены интеграции с Notion, GitHub, Box, Instacart, PayPal. Ему хотят дать собственную почту, чтобы агент мог переписываться и выполнять часть задач от вашего имени.

То есть вместо обычного сценария "открыл сервис → нашёл данные → скопировал → пошёл в ChatGPT → объяснил, что с этим делать" можно сказать одну фразу и дать агенту самому пройти по этой цепочке.

☑️ Дальше конкурировать будут не только модели. Будет важнее, сколько сервисов агент реально видит, что ему разрешено делать и насколько хорошо он понимает ваш контекст.

Если он знает ваши задачи, документы, переписку, покупки и историю работы, то ему уже не надо каждый раз пересказывать жизнь заново.

Ну и, конечно же, мы не забывает про персональные данные и безопасность, с чем возникает вопрос. Но об этом будет отдельный пост - 🔥

*Meta Platforms Inc. признана в России экстремистской организацией, её деятельность запрещена.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Пробую Дзен - подпишитесь 🔥
https://dzen.ru/ideasforai


400 000 GPU — это сколько? Почти целая электростанция в Мытищах 🤣

Дженсен Хуанг заявил, что AGI уже достигнут. И рядом назвал следующую цифру масштаба: совсем скоро для обучения топ-нейросети потребуется переход от 100 тысяч GPU к 400 тысячам.
Сама цифра почти ничего не говорит. Поэтому переведём её в железо и электричество.

Если считать на архитектуре NVIDIA Blackwell:

🟦около 5 556 серверных стоек;
🟦примерно 800 МВт с охлаждением и инфраструктурой ЦОД;
🟦почти 7 млрд кВт·ч в год, если такая система работает под полной нагрузкой постоянно;
🟦несколько футбольных полей только под серверные залы. Весь кампус будет заметно больше.

Теперь сравнение, которое вы вряд ли ожидали... В Мытищах работает ТЭЦ-27. Её установленная электрическая мощность - 1 060 МВт. То есть кластер на 400 тысяч GPU в такой конфигурации мог бы потреблять примерно 75% мощности этой станции.

Конечно, 400 тысяч GPU не означают, что все они завтра окажутся в одном здании и будут одновременно обучать одну модель. 800 МВт = оценка масштаба. Но цифра хорошо показывает, куда всё пришло.

Вот почему AI-гонка всё сильнее становится ещё и энергетической. И да... похоже, новые модели скоро действительно удобнее будет сравнивать не только по бенчмаркам, но и по электростанциям.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


➡️Google давно написал инструкцию, как не сделать из ИИ ещё одну бесполезную кнопку в продукте

У Google есть People + AI Guidebook - практический гайд для тех, кто добавляет ИИ в сервис, приложение или внутренний продукт. Он собран на основе исследований, опыта продуктовых команд Google и академических работ.

И там есть мысль, которую я бы вообще вынес отдельно:

Если ИИ не решает конкретную пользовательскую проблему лучше обычного интерфейса - возможно, он там просто не нужен.

Google предлагает начинать с вопроса:
какую проблему пользователя ИИ умеет решать действительно лучше других подходов?

Потому что сейчас во многих продуктах AI появляется примерно так: добавили чат, назвали это copilot и…. сидим довольные. Что еще к этому добавить:

1️⃣Не объясняйте человеку технологию - объясняйте пользу

При знакомстве с AI-функцией лучше объяснять, что она даст человеку, а не как она работает внутри. Пользователю редко важно, какая там модель. Ему важно, что теперь можно сделать быстрее или проще.

2️⃣Не отдавайте ИИ всё управление сразу

Сначала подсказки, потом действия под контролем пользователя, потом больше автономности. Особенно если ошибка может что-то стоить.

3️⃣Дайте человеку возможность поправить ИИ

Если AI ошибся, продукт не должен загонять пользователя в тупик. Нужен понятный путь: исправить, откатить, выбрать другой вариант, продолжить вручную. В Guidebook этому посвящён отдельный блок про feedback, control и graceful failure.

4️⃣Не делайте вид, что ИИ понимает больше, чем понимает

Отдельно про mental models: человек должен понимать, что система умеет, где у неё ограничения и почему результат иногда меняется. Если ожидания завышены, дальше обычно идут разочарование и отказ от функции.

5️⃣Самая полезная проверка для любой AI-фичи. Я бы вообще сохранил себе один вопрос:

Если убрать слово “AI” из описания продукта — останется ли у этой функции реальная ценность?


Если нет, скорее всего, перед вами просто AI-декорация.

Сам гайд большой, но удобный: там шесть разделов - от выбора задачи и данных до доверия, контроля и работы с ошибками.

Плюс есть worksheets, которые можно буквально прогонять с командой при проектировании AI-функции.

Для продакта, руководителя или человека, который сейчас что-то строит с ИИ, это полезнее половины подборок «100 лучших промптов»

Сам Guidebook: People + AI Guidebook от Google⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Что было за неделю:

➡️Предсказать, кто купит, уже мало. Интереснее понять, кто купит именно благодаря вам 🧐 прочитать пост⁠

➡️37 000 AI-агентов собрали в виртуальную биотех-компанию. И она уже ищет лекарства 🧐 прочитать пост⁠

➡️Чем лучше человек умеет работать с ИИ — тем меньше он ему доверяет 🧐 прочитать пост⁠

➡️Любите Дэна Брауна и «Код да Винчи»? У меня была загадка длиной в 14 лет — и GPT наконец помог её добить 🧐 прочитать пост⁠

➡️Зачем MBA, если и так всё знаешь? Потому что MBA не всегда про нехватку знаний 🧐 прочитать пост⁠

➡️ИИ, который слушает лес и понимает, кто там живёт. Уже не фантастика, а рабочий экологический мониторинг 🧐 прочитать пост⁠

➡️Claude теперь можно спросить про весь свой прогресс в тренировках — не по одному забегу, а по всей истории 🧐 прочитать пост⁠

➡️Если в голове уже свалка из дел — не начинайте с планировщика. Сначала выгрузите всё в ChatGPT 🧐 прочитать пост⁠

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai

#дайджест


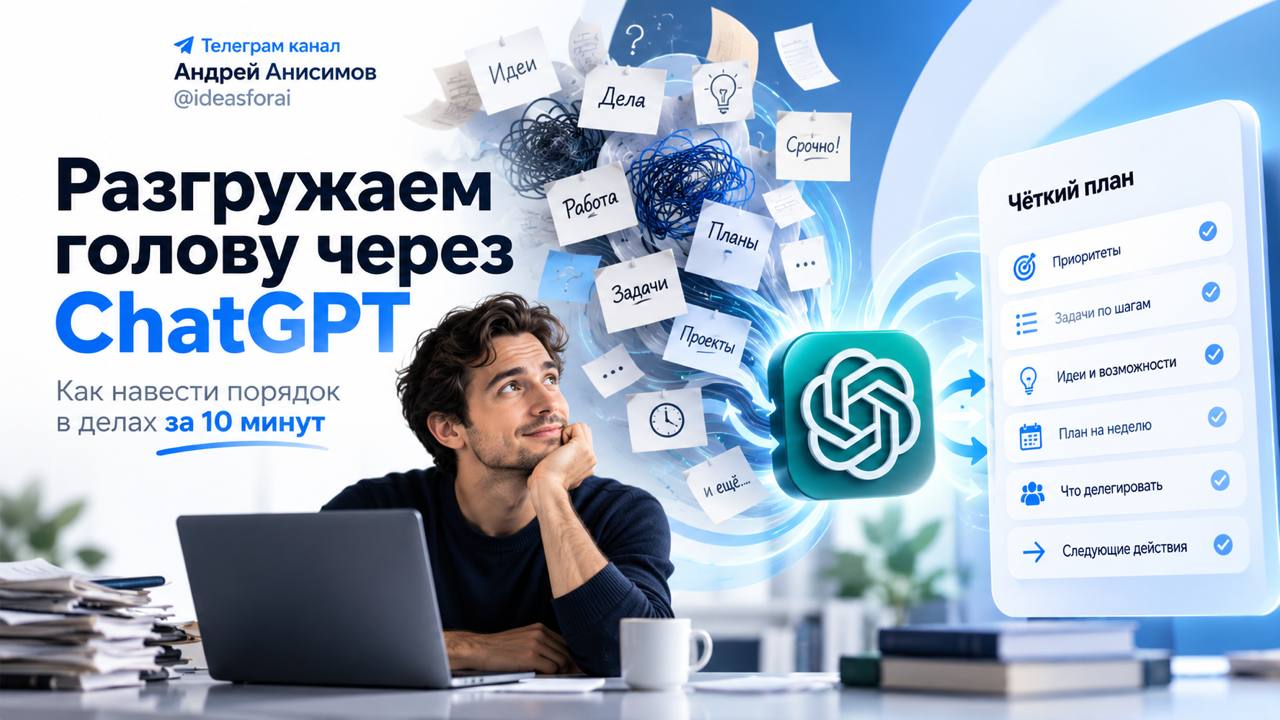
Если в голове уже свалка из дел - я бы не начинал с планировщика. Я бы сначала выгрузил всё в ChatGPT.

Просто рассказываете всё, что висит: кому не ответили, что откладываете, что раздражает, что надо купить, оформить, доделать.

1️⃣ Сначала собрать весь хвост

Расспроси меня обо всём, что я не закончил, откладываю или постоянно держу в голове. Потом собери всё в один список без дублей


Это полезнее, чем самому садиться и вспоминать. ChatGPT начинает задавать вопросы, и обычно всплывает ещё половина того, про что уже забыл.

2️⃣ Потом превратить кашу в нормальный день

Собери из этого план на сегодня. Сначала поставь задачи, которые можно закрыть за 5–15 минут. Потом оставь 2–3 действительно важных


3️⃣Часть списка сразу отдать ИИ

Сделай сам всё, где моё участие не требуется: письма, сообщения, черновики документов, списки, расчёты, заготовки


Вот этот пункт я бы вообще не пропускал. Потому что если после разговора с ChatGPT у вас просто появился ещё один список дел — вы использовали его как дорогой блокнот.

4️⃣Найти одну задачу, которая реально что-то меняет

Какое одно действие из этого списка даст мне самый большой эффект, если я сделаю его сегодня?

Иногда это вообще не самая большая задача. Может оказаться один звонок, одно письмо или решение, которое разблокирует ещё пять дел.

5️⃣И последний вопрос:

Что из этого списка я могу вообще не делать?


Вот после него список обычно становится сильно приятнее.

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Claude можно спросить про весь свой прогресс в тренировках 😉

Завтра, 27 сентября, проходит основная дистанция Московского марафона - 42,2 км. А я свой первый марафон пробежал два года назад.

И забавно посмотреть, как за эти два года поменялась работа с ИИ. Перед своим марафоном я использовал ChatGPT как тренера. Сначала отправлял ему скриншоты из Garmin с последними забегами.

GPT пытался понять мой уровень, оценивал темп на марафон, потом расписал последнюю неделю тренировок и питание перед стартом. Потом мне захотелось дать ему больше данных.

Я запросил у Garmin полный архив, ждал его несколько дней, получил кучу непонятных файлов, начал разбираться, что где лежит, вручную перекидывал их в GPT. Он даже попытался написать скрипт для анализа — и благополучно упал с ошибкой. В итоге часть данных пришлось просить разбирать вручную.

Для 2024 года это уже казалось довольно крутым. Теперь выглядит как минимум спорно... потому что Strava запустила официальный MCP-коннектор для Claude. Модель получает доступ к истории тренировок, GPS, темпу, мощности и даже пульсу посекундно.

То есть можно загрузить в разговор не один забег, а месяцы тренировок и спросить:

🟦где я реально стал быстрее;
🟦после каких тренировок чаще проседаю;
🟦когда лёгкие дни перестают быть лёгкими;
🟦как менялся пульс на том же темпе;
🟦какая нагрузка в моём случае вообще работает.

Если отдельно подключить Oura, можно уже сопоставлять тренировку с тем, что было после неё: сон, HRV, восстановление. Например:

"После каких тренировок у меня HRV восстанавливается дольше всего?"
"На каком недельном объёме у меня начинает портиться сон?"
"После каких нагрузок я прогрессирую, но не разваливаюсь на следующие два дня?"


🔷В Claude открываете Customize → Connectors → Strava → Connect и входите в свой аккаунт Strava. Коннектор работает через OAuth, доступ можно в любой момент отозвать. Он только читает данные — менять или удалять тренировки Claude не может. Функция входит в подписку Strava.

После подключения я бы не спрашивал что-то общее вроде "оцени мои тренировки". Гораздо полезнее дать Claude конкретный период и задачу:

"Разбери мои последние 12 недель. Найди тренировки, после которых темп рос при сопоставимом пульсе. Отдельно покажи недели, где нагрузка резко выросла."

Или:
"Сравни мои лёгкие пробежки за последние 6 месяцев. Стали ли они быстрее при том же пульсе?"


Claude получает доступ к актуальной истории Strava и может анализировать её целиком: объём, темп, нагрузку, разные виды тренировок, GPS и посекундные данные.

У большинства из нас эти данные копятся годами и почти никак не используются. Максимум — посмотрели средний пульс после пробежки и закрыли приложение. А можно делать больше!

#AI_и_наука

➡️Я в сетке — подписывайтесь
https://setka.ru/communities/01a0d9e7-1820-71f2-ab43-456e2269399f


ИИ, который слушает лес и понимает, кто там живёт 🏞

Обычно мониторинг природы представляют так: биологи ходят по лесу, считают птиц, ставят фотоловушки и вручную разбирают наблюдения.

😅 Но когда территория — 25 000 км², такой подход просто перестаёт масштабироваться.

В Сьерра-Неваде Cornell разворачивает больше 1 600 автономных акустических рекордеров. Они постоянно записывают лес, а дальше ML помогает искать в этом потоке голоса животных и отслеживать, как меняется биоразнообразие. Сейчас система используется для мониторинга более 100 видов птиц 🦜

По таким данным можно смотреть, где вид исчезает, где возвращается, как животные реагируют на пожары, изменение среды и климат, а потом использовать это в реальном управлении территориями. Cornell объединяет акустические данные ещё и со спутниковыми наблюдениями, чтобы делать инструменты для природоохранных служб.

Сам BirdNET тоже давно вышел за рамки распознавания нескольких птиц. Его база сейчас охватывает более 16 тысяч видов, включая птиц, млекопитающих, насекомых, амфибий и рептилий.

Спутник хорошо показывает, что с лесом произошло физически. А звук помогает понять, кто в этом лесу ещё живёт. Это уже совсем другой уровень мониторинга природы.

#AI_и_наука

💬 Присоединиться к обсуждению в чате

Телеграм канал
Андрей Анисимов
@ideasforai


Зачем MBA, если и так всё знаешь? 🎓

MBA - это не всегда про нехватку знаний. Иногда просто наступает момент, когда твои задачи становятся сложнее, чем рамки одной функции.

Когда руководишь командой, внедряешь AI или трансформируешь бизнес, уже недостаточно разбираться только в своей предметной области. Нужно понимать, как твои решения влияют на финансы, стратегию, процессы и людей.

Для меня SKOLKOVO MBA стал возможностью систематизировать опыт, посмотреть на бизнес глазами руководителей из других индустрий и научиться находить решения там, где нет готового ответа.

И, конечно, отдельная ценность - люди, с которыми продолжаешь общаться и после выпуска.

Кстати, если давно присматриваетесь к MBA, есть интересный способ попробовать себя в деле.

10 октября СКОЛКОВО проводит первый кейс-чемпионат SKOLKOVO MBA.

Собираете команду, решаете реальный бизнес-кейс и получаете возможность выиграть грант на обучение.

Хороший способ проверить свои управленческие навыки, познакомиться с единомышленниками и почувствовать атмосферу бизнес-школы.

📍 Кампус СКОЛКОВО

🔗 Регистрация на кейс-чемпионат⁠

Показано 20 последних публикаций.