RAntiquity


Гео и язык канала: Россия, Русский
Категория: Блоги


Об античности на языке R и не только
@locusclassicus

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Блоги
Статистика
Фильтр публикаций


продолжая тему "кто ты из диснеевских принцесс в мире DH"

сегодня так: Белоснежка и семь субагентов


Мы предлагаем поговорить о технологическом детерминизме в DH. Занимались бы мы исторической семантикой, если бы у нас не было методов векторного представления слов? Пытались бы мы решать проблемы атрибуции, если бы не существовало Stylo? Где грань между использованием инструмента как «лупы» для решения классической задачи и ситуацией, когда инструмент сам диктует нам повестку?


друзья, а вы же помните про 8 октября? планируется живая или полуживая (сколько хватит сил) дискуссия, приходите пообщаться о насущном ☕️🥯

нужна регистрация! (по ссылке)


Репост из: Antibarbari HSE
🌋 Если вы вдруг пропустили доклад Антона Репушко про битву программистов с Везувием за папирусы, запись встречи уже доступна онлайн!

📖 А еще раньше на тему папирусов у нас был доклад Алены Чепель! Алена и Антон недавно запустили новое приложение для распознавания греческих папирусов, про него вчера тоже немного поговорили с обоими создателями.

💙 А если вас больше интересует тема машинного обучения в антиковедении, напоминаем, что ранее в серии из серии #antibarbari_colloquia было два доклада об этом:

✅Лев Шадрин — об автоматической расшифровке древнегреческих дневников Хазе
✅Светлана Яцык — о распознавании рукописных текстов

Спасибо, что вы с нами 💙
Antibarbari Colloquia # 15 Антон Репушко: Vesuvius Challenge: как машинное обучение сделало возможным чтение обугленных свитков
Во время извержения Везувия в 79 г. пирокластические потоки обрушились на Помпеи и несколько других городов с разной скоростью. Благодаря этому в Геркулануме папирусные свитки в частной библиотеке обуглились, но не были полностью уничтожены. Со времени обнаружения виллы с библиотекой в 1750 г ученые...


Репост из: Antibarbari HSE
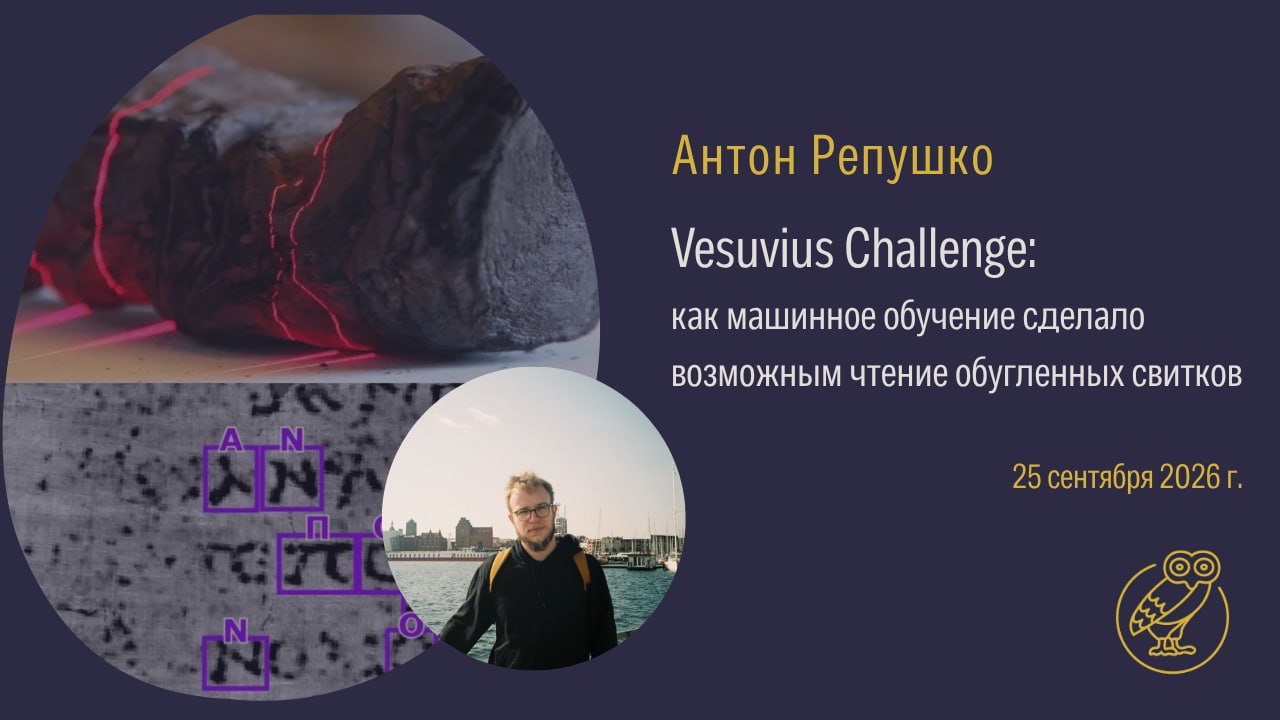
🌋 Vesuvius Challenge: как машинное обучение сделало возможным чтение обугленных свитков

🌟 Антон Репушко, Head of Research в Revolut, ex-разработчик в Vesuvius Challenge, автор проекта Anagnostes в гостях у #antibarbari_colloquia

Во время извержения Везувия в 79 г. пирокластические потоки обрушились на Помпеи и несколько других городов с разной скоростью. Благодаря этому в Геркулануме папирусные свитки в частной библиотеке обуглились, но не были полностью уничтожены. Со времени обнаружения виллы с библиотекой в 1750 г ученые пытались развернуть свитки и прочитать содержащиеся в них античные произведения. Это часто приводило к тому, что папирусы рассыпались в прах и были потеряны для науки. В 2023-2026 годах участники проекта Vesuvius Challenge впервые с помощью технологий машинного обучения смогли виртуально развернуть несколько свитков без физического вмешательства. О том, как стал возможен этот научный прорыв, расскажет в лекции Антон Репушко.


🗓 25 сентября 2026 г., начало в 18:30 (мск). Встреча пройдет онлайн (Zoom).

🔗 Участие свободное. Регистрация по ссылке.

Мероприятие организовано Греко-латинским клубом
Antibarbari HSE совместно с магистерской программой "Цифровые технологии в гуманитарных исследованиях" НИУ ВШЭ.

Встречу проведет к.ф.н., доцент О.В. Алиева.


Репост из: Системный Блокъ


1. Приготовилась, жду, когда кто-нибудь скажет, что правильный ответ: не использовать.

2. Удивительно, как быстро переходишь от состояния "я никогда не позволю какому-то подозрительному агенту хозяйничать в моих файлах" до "не спрашивать разрешения на каждое действие, разрешать автоматически".


Репост из: Antibarbari HSE
Как филологу-классику использовать нейросети?


Канал @antibarbari совместно с @rantiquity собрал для вас несколько советов ⬇️

Сначала о формате работы.

⏩Чаты удобны для обсуждения отдельного места: задаем вопрос, проверяем ответ, уточняем. Claude и GPT позволяют привязывать чаты к проектам. Это удобно тем, что у каждого проекта есть своя библиотека: файлы не надо каждый раз загружать в чат. Но у таких библиотек есть ограничения (примерно 20 файлов, в зависимости от объема и подписки).

⏩Агентный режим — для поручений с файлами: обработать подборку материалов, собрать таблицу, подготовить документ. Один из таких инструментов — Claude Cowork. Коворки умеют работать с разными форматами, но самый удобный и быстрый для промежуточных результатов -- не docx, а md (маркдаун).

⏩Скрипт на R или Python — для повторяющихся операций над корпусом. Нейросеть может помочь его написать и запустить.

🫥🫥🫥🫥🫥🫥

✨ Анализ разночтений

Что: развернуть сжатую запись аппарата, сопоставить варианты, выяснить, как каждый из них меняет синтаксис и смысл.

Как: в чате - дать текст и аппарат нужного издания, попросить разобрать каждое чтение; в коворке - дать доступ к папке с изданиями; можно попросить собрать такие разборы в таблицу с указанием места и источника.

Особенности: Сиглы лучше задавать явно, а не надеяться, что нейросеть угадает. Текстовый слой у старых pdf скорее всего плохой, и каждая страница будет обрабатываться как изображение - это высокий расход токенов.


✨ 2. Грамматика и перевод

Что: проверить неоднозначный оборот, возможные антецеденты местоимения, сравнить несколько переводов.

Как: через чат для отдельных затруднений или в коворке с доступом к переводам.

Особенности: модель может незаметно исправить неудобный текст или предложить перевод, который скрывает грамматическую проблему. Полезно требовать, чтобы возможные исправления обсуждались отдельно.

✨ 3. Сопоставление научной литературы

Что: поиск интерпретационных развилок.

Как: В чате удобно обсуждать отдельные вопросы; в коворке можно поручить собрать в маркдаун сравнительную таблицу: автор — тезис — аргумент — разбираемое место — страница.

Особенности: важно просить подтверждающие выдержки с номером страницы для проверки. Нейросети умеют различать печатную страницу и номер страницы PDF.

✨ 4. Работа с корпусом

Что: собрать конкорданс, сделать частотный словарь, найти частотные сочетания или сделать предварительную разметку контекстов или именованных сущностей.

Как: попросить нейросеть написать скрипт для R или Python (для частотностей) или добавить разметку в файлы txt / xml. Современные нейросети умеют подтягивать источники с Perseus и делать конкорданс безо всякого кода.

Особенности: обязательно сравнивать источник до и после разметки: нейросети могут исправлять текст, который они размечают. Могут быть ошибки в пагинации.

✨ 5. Библиография, ссылки и оформление

Что: привести записи к единому виду, найти ссылки без библиографических записей, подготовить BibTeX, проверить перекрестные отсылки.

Как: коворк с текстом и библиографией. Полезное поручение: «Сопоставь ключи цитирования в документе с файлом библиографии и выведи несовпадения».

Особенности: форматирование и установление библиографических данных — разные операции. Недостающие год, страницы или DOI нужно сверять с изданием. В рабочем результате лучше оставить явный пропуск, чем получить правдоподобно заполненную запись.

🫥🫥🫥🫥🫥

❗️Хорошее поручение обычно содержит четыре вещи: материал, конкретный вопрос, формат результата и способ проверки.


Делитесь своими секретами в комментариях! 💙


Репост из: Antibarbari HSE
Дорогие друзья! Мы запустили Анагноста - с помощью ИИ он может делать транскрипцию греческого текста на папирусе по цифровому изображению. Это первый подобный инструмент в истории папирологии, и он уже очень хорошо работает: находит строки, распознает буквы и специальные знаки, в том числе в курсивных почерках, разделяет текст на слова, предлагает реконструкцию лакун и раскрывает сокращения. Мы будем и дальше тренировать модель, чтобы результаты были еще лучше.

Самую точную транскрипцию Анагност дает для литературных папирусов и хорошо сохранившихся фрагментов птолемеевского и римского времени.

Сейчас на сайте можно протестировать до 5 папирусов. У нас пока нет финансирования, поэтому просим экономно отнестись к этой тестовой фазе (да, расшифровка каждого папируса - это вычислительные мощности и тоже расходы).

Большое спасибо всем, кто помог нам осуществить этот проект в такие короткие сроки, и особенно нашим замечательным волонтерам, которые приняли участие в ручной разметке папирусов: Полине Маловой, Дарье Колер, Яну Шаврину, Антонине Калининой, Дарье Долгобородовой, Ольге Троицкой, Ольге Голуз, Анне Грешных и другим! 🚀💕

Алена и Антон


еще у меня сегодня две новости из мира айти.
1) статистика телеграма нарисовала мне котика
2) чат жпт составил от моего имени письмо и подписал: Ольга ИИ


Репост из: Vox mediaevistae
Проект GREgORI и Calfa, единственная известная мне компания, которая оказывает услуги по автоматической транскрипции текстов на редких языках, опубликовали корпус объемом почти 6 млн слов на древнегреческом языке, созданный на основе Patrologia Graeca.
Туда вошли тома PG, которых не хватало в Thesaurus Linguae Graecae — прежде всего позднеантичные и византийские тексты.

CER, по их словам, достигает 1%. Данные доступны в нескольких форматах, в том числе с лемматизацией и POS-разметкой. Корпус можно использовать для полнотекстового поиска, анализа текстов и как silver data для обучения LLM.

GitHub проекта
Статья "The Patrologia Graeca Corpus: OCR, Annotation, and Open Release of Noisy Nineteenth-Century Polytonic Greek Editions"


На прошлой неделе закончился наш летний буткемп по R #summeR Для меня это был первый подобный опыт работы не со студентами, а с коллегами -- преподавателями и исследователями, знающими и в хорошем смысле требовательными.

Усиленная работа летом - всегда спорный выбор, потому что в нашей гуманитарной жизни это часто единственная возможность немного выдохнуть. Но, как оказалось, меня занятия в такой аудитории заряжают энергией не меньше, чем кабачковая жизнь 🌸 Надеюсь, что и участникам наши пятничные созвоны были не в тягость.

А еще я очень рада приходящим отзывам, которыми -- с разрешения авторов -- делюсь в карточках. Спасибо, друзья! Forever 🖼️

Кто все пропустил, курс пока доступен в записи.


Невозможно не откликнуться на приглашение, если мероприятие называется "Сумма технологии" 😇🫠💘

Будем говорить с коллегами о технологическом детерминизме и liberum arbitrium. Предполагается дискуссия, так что приходите не столько послушать, сколько пошуметь.

Шумим 8 октября. Нужна регистрация.


Международно-политическая обстановка и низкие acceptace rates не ободряют нас писать на английском, но мы все равно пишем, потому что охота пуще неволи.

Поставила в демо-режиме плагин GPTZero. Работает в Chrome, дружит с Google Docs. Исправляет, оценивает вероятность автоматической генерации, поддерживает разговор по тексту, толково объясняет стилистические нюансы. Можно поставить на сканирование целый документ и смотреть, как невидимый редактор вносит правки (все в режиме "советовать"), пока ты пьешь чай.

Работает хорошо с английским, с другими языками не пробовала. Стоит иностранных деняк.


✉️ Пришел отзыв на мастер-класс по LLM, подтверждающий, что встроить большие языковые модели в исследовательский пайплайн вполне реально, даже не имея опыта программирования. Делюсь с разрешения автора. Еще не поздно попробовать.


Дорогие студенты, спасибо вам большое 🥰🥰🥰
https://www.hse.ru/best/2026_hum

Мне прислали ваши отзывы (анонимные), я очень тронута. Особенно я тронута тем, что там вперемешку отзывы на R, латынь и греческий. Ну и ну, вот времена настали. Постараюсь и дальше не подкачать.


когда-то крестьяне переезжали в города, теперь так


Снова коллеги из DHRI раскопали хороший текст про ИИ.

Автор, Марк Хамфрис, - историк, преподающий также курсы по ИИ; вот его страничка. В комментариях к статье есть интересный тезис

I think we are entering a phase where there are people who know how to use LLMs to get the best results (who ask it to come up with the best prompt first, rather than writing it on their own or just dropping the prof's assignment in, and who add all kinds of instructions to Claude Cowork, etc.), and people who don't. Those who don't know will give the impression that LLMs are not capable of doing what historians can do (and that makes us feel like we still have a place/role). However, it's the papers written by the people who DO know what to do that we need to pay attention to.


Пока не комментирую. Надо осмыслить.


Если вы пропустили мастер-класс «R + LLM: практический мастер-класс для гуманитариев», его теперь можно приобрести в записи.

Что входит в комплект?


✳️видеозапись трехчасового мастер-класса: устанавливаем Ollama, подключаем языковую модель к R и последовательно собираем рабочий исследовательский пайплайн;

*️⃣шесть подробных шпаргалок со всеми скриптами, которые разбирались на занятии;

✳️содержательно: готовые решения для одиночных и пакетных запросов, извлечения данных из текстов, работы с JSON и сведения результатов в таблицу.

Мы начинаем с настройки инструментов, а заканчиваем обработкой большого массива текстов. Все этапы показаны на реальном гуманитарном материале: от первого запроса к модели до воспроизводимого анализа множества документов.

Запись подойдет тем, кто хотя бы немного знаком с R и хочет использовать LLM не только в чатах, но и как часть исследовательского пайплайна. Все модели доступны без подписки, VPN для работы (пока) не требуется.

Приобрести запись и материалы можно по ссылке через PayWall. Сервис принимает иностранные карты.


Дорогие друзья,

меня несколько раз спрашивали, когда будет второй поток курса по R.

Во-первых, спасибо -- мне очень приятно, что курс оказался востребован. Надеюсь, в ближайшее время он поможет вам изрядно бустнуть ваши научные и образовательные проекты.

Во-вторых, второго потока я пока не планирую из-за большой нагрузки. Но материалы прошедшего курса (видео и скрипты) теперь можно приобрести через PayWall. Сервис принимает иностранные карты.

Курс рассчитан в первую очередь на гуманитариев, в том числе на тех, кто начинает работать на R с нуля: от базовых операций мы постепенно переходим к обработке и анализу текстовых данных.

Как это работает: вы один раз покупаете доступ к курсу, без каких-либо ограничений по времени, и получаете ссылку на облачное хранилище с видео и скриптами. Скрипты, специально созданные для этого курса, можно скачивать и запускать; видео доступны только для просмотра.

Всего в курсе 10 видео продолжительностью от полутора до двух часов и 9 шпаргалок со скриптами.

Внимание: десятое видео курса будет загружено 25 августа. Покупать курс можно уже сейчас: видео автоматически появится в хранилище и будет доступно всем, кто приобрел материалы раньше.

Показано 19 последних публикаций.