Дамасские чернила | AI и M&A


Kanal geosi va tili: Rossiya, Ruscha
Toifa: Huquq


Визионерское комбо от M&A-юриста / ML Product Manager с ноткой постиронии.
Авторский канал Софьи Смирновой damascus-ink.ru
Не является консультацией.
Для связи: @sky_magenta

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Toifa
Huquq
Statistika
Postlar filtri


👁 Как ИИ повлиял на моё профессиональное самоощущение?

Очень классно провели с Юлией Михальчук эфир, где обнаружили, что наши взгляды на применение ИИ и юзеркейсы похожи во многих отношениях.

На правах поста выходного дня спонтанно захотела поделиться тем, как ИИ поменял моё ощущение работы:

1) я стала существенно более эмпатичной. Суровая культура большой международной компании, где я начала работать во время учебы в РШЧП, располагала только к одному - культу работы и успеха. Я была очень требовательна к себе (причём не понимая, нужно ли это сверхусилие хоть кому-то) и окружающим и работала до изнеможения, а также, став старшим консультантом, изводила уже младших сотрудников своими правками и требованиями.) эта черта постепенно смягчилась с возрастом, но все равно превалировала в профессиональной жизни. А с ИИ мне стало сильно проще пройти цикл доработки результата до приемлемого, и я сбросила с себя гнёт того, что все должно быть идеально с первого раза. В процессе доработки результата с ИИ я стала замечать ценность человеческого труда и инпута, который профессионал даёт ИИ. И мне стало проще видеть и взращивать именно это чувство ценности, в том числе в подрастающих юристах.

2) я почти избавилась от перфекционизма. ИИ даёт безграничный ресурс для попыток и творчества, спонтанности и различных креативных подходов. Для меня как СДВГшника ИИ также стал спасением от рутины. В результате я продуктивнее и гибче, чем была до этого.

3) огромный ресурс, который даёт ИИ, в конечном счете даёт ощущение уверенности в завтрашнем дне. Если знать, как с ним работать, можно свернуть горы. В результате у меня высвободилось куча ресурса для занятия саморазвитием и другими делами, на которые раньше не хватало времени и душевных сил.

4) я стала организованнее и продуктивнее. В целом я достаточно хаотичный и эмоциональный человек, порядок на уровне "все по полочкам" мне было сложно держать. Теперь с составлением всякого рода локальных пайплайнов я подняла уровень работы с информацией, прежде всего с личной, на недосягаемый ранее для меня уровень, и начала видеть все новые и новые связи между вещами, а также более тонко отделять главное от второстепенного. Это имеет каскадный эффект.

Таким образом, я вижу в ИИ огромный нераскрытый потенциал для изменения всей профессии в целом, для принесения новой пользы своим доверителям и клиентам, для формирования нового образа общества и места юристов в нем.

И как без ложки дегтя. Не факт, что ИИ-пузырь (а это без сомнения он, так как внедрение сильно не поспевает за денежными вливаниями) сможет денежно продолжать поддерживать себя и далее, в силу чего нас может ждать виток ИИ-разочарования... Что совсем не отменяет того факта, что продуктивность и благосостояние человека точно поднимется на новый уровень.

Каким вы видите своё место в новой, только складывающейся структуре общества? Давайте поговорим 🥸


Rus_AI_Private_Law_Aspects_2026.pdf
3.0Mb
🐈‍⬛ Сравнительно-правовое цивилистическое исследование об ИИ в праве

23 сентября вышло хорошее исследование Международного центра сравнительного правоведения (ICLRC) под редакцией уважаемой Л. А. Новосёловой о том, как частное право 14 юрисдикций (ЕС, Франция, Германия, Норвегия, Великобритания, США, Израиль, ОАЭ, Казахстан, Кыргызстан, Сингапур, Корея, Индия, Китай) отвечает на четыре вопроса об ИИ в праве:

А) кто отвечает за вред, причиненный ИИ;
Б) можно ли обучать модели на чужих произведениях;
В) кому принадлежат права на генерированный контент;
Г) как ИИ-агенты заключают договоры.

Завершается исследование выводами о судьбах вопросов в РФ.

Своими выводами пока делиться не спешу, но планирую анонсировать работу на эту тему.

Идейно ГК достаточен по вопросам деликтной ответственности (1064/1079/1095/1099), обучение ИИ = использование, промпт не всегда творческий вклад, а ст. 10 ФЗ «О развитии ИИ» юридически пуста.
Файл во вложении - читаем, радуемся, делаем выводы.


25 сентября выступаю в Клубе корпоративных споров Юлии Михальчук

Ваша покорная рада поделиться, что вместе с Юлией Михальчук, основательницей одного из крупнейших RU-сообществ корпоративных юристов - Клуба корпоративных споров @corplawpro, уже в эту пятницу мы обсудим такой актуальный нынче вопрос, как судьба ИИ в корпоративных спорах и структурировании корпоративных сделок.

По сути, краеугольным камнем нашей беседы станет тема важности критического мышления в эпоху дешёвого "интеллекта". Но не только это. Разберём такие практические вопросы, как:
🔘анализ материалов дела и поиск практики: делаем?
🔘 процессуальные документы и работа с доказательствами: "на войне как на войне"
🔘галлюцинации ИИ: где подстерегают и как ловить
🔘 конфиденциальность и коммерческая тайна: верим?
🔘можно ли с ИИ делать due diligence и структурирование сделок
🔘переговоры, моделирование позиции оппонента и сравнение сценариев: за и против
🔘ИИ-агенты и мультиагентные системы в M&A: понедельник начинается в субботу

UPD: презентацию выложу чуть позже.


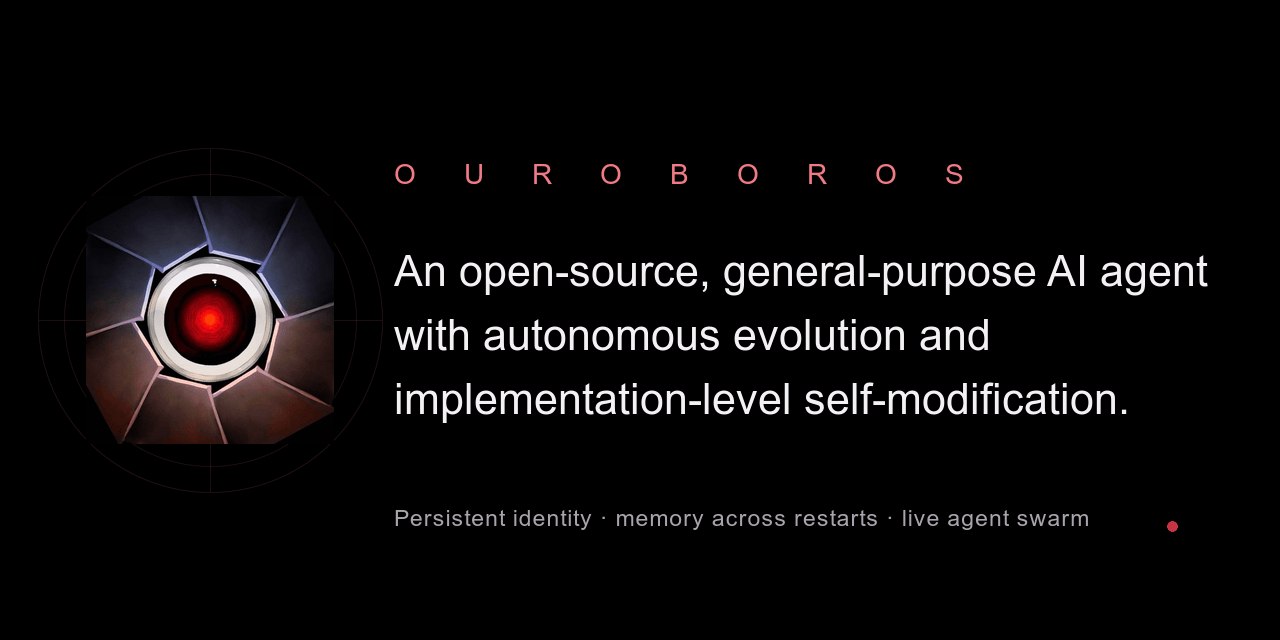
Встречайте Уробороса: личный ИИ-ассистент нового поколения, переписывающий собственный код

Пока многие из известных мне энтузиастов развлекаются с OpenClaw или Hermes Agent, мое внимание привлек один крайне занимательный проект - Ouroboros. Создан российским разработчиком, достаточно популярным в русскоязычном ML-комьюнити. Идея инновационная и играет на нервишках и страхе перед Сингулярностью. Что могу сказать - i'm in love...

Почему Уроборос - потому что агент переписывает сам себя (и съедает сам себя). У автора очень крутая статья на VC.ru, интересующимся читателям очень рекомендую прочитать в оригинале, а также статья на arXiv. Это инновационный пример самоулучшающегося ИИ. Внедрять рано: система экспериментальная, сама выбирает, куда отправлять данные (для клиентской информации — красная линия), а проверенная версия живёт недолго — агент её перепишет.

Давайте посмотрим на его архитектуру:
Ключевая идея — reviewed core evolution: любое самоизменение проходит как коммит через ревью (внутри — отдельный агент-ревьюер), и одобренная версия становится новой средой исполнения.
Два режима эволюции: рекурсивная (улучшение себя — сама задача; финиш одного цикла планирует следующий) и опытная (баги из реальной работы → структурные изменения).
Плюс персистентная идентичность и память между перезапусками, «фоновое сознание» вне цикла запрос-ответ и рой параллельных агентов.


А в чем отличие от привычных Опенкло и Гермеса?
OpenClaw (около 390 тыс. звёзд на GitHub) — самый массовый из трёх: личный ИИ-ассистент на вашем компьютере, доступный из 20+ мессенджеров — Telegram, WhatsApp, Discord, Slack и далее. Управляет устройствами, слышит, видит, расширяется плагинами из встроенного маркетплейса. Это «компаньон»: вы им пользуетесь, но себя он не меняет — его меняете вы, ставя скиллы. Показатель зрелости: независимый фонд, спонсоры от OpenAI до NVIDIA.

Hermes от Nous Research (около 247 тыс. звёзд на GitHub, самый быстрорастущий агентный фреймворк 2026 года) — «агент, который растёт с вами»: сам создаёт навыки из опыта, ведёт курируемую память и модель пользователя, умеет искать по прошлым сессиям. Живёт на сервере (хватит VPS за пять долларов), общается через те же мессенджеры, есть изолированные сабагенты и задания по расписанию. Самообучение здесь — на уровне навыков и памяти.

Ouroboros (пока 1,3 тыс. звёзд) идёт дальше всех: переписывает собственный код, промпты и архитектуру — не навыки, а реализацию, и только через процедуру ревью с фиксацией каждого изменения. Единственный из трёх с научной статьёй и 160-дневным живым экспериментом с выстроенной методологией; главный вывод — защитные ограничения обязаны оставаться главнее эволюции. Заточен под работу над проектами: git-рабочая область, патч на выход, рой субагентов, делегирование задач подпискам Codex / Claude Code / Cursor.

Для новичков такая игрушка не подходит, поэтому если вы не опытный человек в ИИ-вопросах, не рекомендую ставить. Очень высоки риски утечки ваших данных или неконтролируемого поведения. Но если вы энтузиаст, как и я - го тестить.

Я вижу в нем интересное решение для коллективной базы знаний как минимум. А о других сценариях использования я расскажу чуть позже, оставайтесь на линии.


Astra for Law: что запуск OpenAI меняет для российского рынка

17 сентября OpenAI объявила о запуске Astra for Law и начале закрытого тестирования на энтерпрайз-подписках. Это, по сути, попытка собрать комбо из фронтирных моделей, воркфлоу от топовых юридических фирм по разным юридическим задачам, коннекторов с базам данных с проведенными источниками и специальных мер защиты данных. Вкусно, все по правилам построения продукта для юристов (сама так делаю))). Но все изменилось: в гонку вступил настоящий глобальный лидер рынка. Юридическим продуктам осталось недолго, если они не конкурентоспособны.

Мыслим стратегически
Сегодня ИИ-решения выглядят как зверинец: у кого-то RAG с поиском по корпоративным данным, у кого-то генератор документов, у кого-то разбор почты с локальной моделью. Теперь лидер рынка озвучил канву того, как будет выглядет AI-native фирма: frontier-модель + верифицируемый workflow + коннекторы к доверенному правовому контенту + контроль безопасности. Это то же, что iPhone сделал для смартфонов в 2007-м: все знали, что экраны и приложения будут, но теперь знают, как это должно выглядеть.
Российские вендоры в ближайшие 12–18 месяцев будут анонсировать «свою Astra» из GigaChat / YandexGPT / T-pro + своих workflow. Конкуренция сместится с «у нас есть ИИ» (в 2026 это уже гигиенический минимум) на качество трёх остальных слоёв.

Что будет в России
Тезис Альтмана про "падающую стоимость интеллекта" бьёт по России даже сильнее, чем по США. В американской модели генерация выручки держится на рычаге «партнёр + армия ассистентов по часовой ставке» — Astra подрывает саму пирамиду. В России почасовая модель слабее, фиксированные тарифы распространены шире, поэтому эффект последовательный: сначала ИИ увеличивает маржу тех, кто внедрил (та же работа за меньшие часы), затем — давит цены на массовых сегментах (договорная работа, претензии, типовые иски, банкротная рутину). Премия смещается к суждению: стратегия, переговоры, суд, ответственность.
Отдельный бонус для России: в США AI-native фирмам приходится городить конструкции вокруг правила American Bar Association об ограничении о non-lawyer ownership. Для обычной юрфирмы в форме российского ООО такого барьера нет — «капитализировать» ИИ-инфраструктуру фирмы у нас юридически проще, чем в условном Нью-Йорке. Это забавный случай регуляторного преимущества (но надолго ли, если адвокатская монополия все же случится...).

А в чем проблемы российского рынка сегодня?
Нет понятного открытого источника с данными российского права, как ни странно. КонсультантПлюс и Гарант закрыты, официальные картотеки (kad.arbitr, ГАС «Правосудие») закрыты антибот-защитой, легального корпуса практики под RAG фактически нет. Именно поэтому «российская Astra» собирается на 80% из открытых весов и на 20% из данных, буквально подобранных в сети Интернет.
Самая стратегически выигрышная позиция — не у разработчиков моделей, а у владельца правового контента. КонсультантПлюс/Гарант могут её занять за квартал, просто открыв API (почему же они этого не делают...). Не откроют — контент соберут скрейпером (я прямо гарантирую, что абсолютное большинство (если не 99%) данных в продуктах, которыми все пользуются сегодня, так или иначе собраны жестким скрейпингом, и я прямо жду возможности вписаться юристом в подобный судебный кейс).

Немного вангования
а) 12–18 месяцев: новые российские продукты «по шаблону Astra» (модель + workflow + контроли), в основном на типовых договорах и процессуальных документах; коннекторы.
б) 2–3 года: паритет по архитектуре при отставании по данным и, вероятно, по качеству рассуждающих моделей. Узкое место — права на корпус практики.
в) Структурно: рост числа AI-native фирм в РФ (без регуляторных барьеров США) и первый интерес внешних инвесторов к юрфирмам как к «активу с ИИ-инфраструктурой», а не «активу с юристами» (я уже писала об этом год назад, отрадно что гипотеза подтверждается).

Вместо выводов
Юрфирмам и юрдепам — не ждать "российской Astra", а внедрять её логику по частям: типовой документооборот на доступных моделях, обязательная верификация каждой ссылки (все помним про то, что суды наказывают юристов за галлюцинации), политика использования ИИ. Ставка та же, что сформулировали в OpenAI: экономить на интеллекте, продавать суждение.

1.4k 2 74 12 24

Вайбкодинг, будущее юриста и запрос на "потрогать траву"

Я уже больше года непрерывно вайбкожу всякое интересное и использую ИИ-ассистентов. Для меня это новый образ жизни и взаимодействия с информацией, и могу сказать, что такой образ мышления - очень продвинутый уровень. Волна докатывается уже до продвинутого большинства, а через какое-то время станет новым профессиональным стандартом юриста (горизонт пока не ясен, но это точно вопрос ближайших нескольких лет).

Я не говорю про то, что все должны стать вайбкодерами, но освоить ИИ должны все.

Тут легко увлечься и оторваться от земли. Есть такой мем, называется "потрогай траву" (touch grass) - это фраза, означающая совет оторваться от гаджетов, выйти на улицу и вернуться в реальный мир.

Сейчас будет вообще не реклама - просто хочется поделиться забавным ивентом от моих друзей. Ребята придумали крутой офлайн-маршрут прогулки по Москве, чтобы отнять даже самых увлечённых вайбкодеров, подсевших на дофамин от ИИ, от экранов. Я их курс по ИИ вайбкодингу не продаю, но он обязан быть крутым, и я вообще не глядя, если хотите, сделаю личный промик на скидку)). Ребята всегда делают стильно и душевно, за это их люблю, и рекомендую от души.

Го гулять вместе? Буду рада повстречаться с теми, кто хочет.


Верховный Суд РФ утвердил концепцию применения ИИ в судопроизводстве

Как указывает РБК, суд всерьёз взялся за внедрение ИИ в судопроизводстве. Это документ чисто про внедрение, а не применение ИИ в самом состязательном процессе.

Приятно увидеть там три любимых буквы упоминание RAG, например. Документ выглядит достаточно хорошо и воодушевляюще. Очень хорошо и то, что обучением судей новым реалиям работы будет заниматься РГУП.

Теперь ждём позиций, подобных мировым (например тем, о которых я писала выше). Надеюсь, что они тоже будут.

К 2030 году более 95% российских судей должны использовать сервисы на базе ИИ, а доля сгенерированных с его помощью процессуальных документов может достичь 30–50%. Эти показатели закреплены в концепции внедрения технологий ИИ в судопроизводство, утвержденной председателем Верховного суда Игорем Красновым.

Документ предусматривает использование ИИ на всех этапах работы с судебным делом — от подачи документов до исполнения судебного акта и его проверки вышестоящими инстанциями. При этом окончательное решение всегда остается за человеком, а ИИ должен выполнять вспомогательную функцию. Среди задач внедрения названы упрощение доступа к правосудию, снижение нагрузки за счет автоматизации рутинных процессов и уменьшение числа ошибок.

Использовать ИИ предполагается уже при подаче документов. Система сможет проверять их комплектность, соответствие требованиям, категорию и подсудность дела, выявлять формальные недостатки и рассчитывать госпошлину. Также предусмотрена предварительная оценка вероятного исхода по типовым категориям дел — без предсказания решения по конкретному делу.

После поступления дела ИИ сможет классифицировать его по категории и сложности, структурировать материалы и участвовать в распределении дел между судьями с учетом нагрузки и специализации. Во время заседаний система должна распознавать речь, автоматически формировать протокол, обеспечивать перевод в реальном времени и предоставлять судье релевантные нормы права, судебную практику и материалы дела.

ИИ также сможет анализировать позиции сторон и доказательства, выявлять противоречия, формировать резюме и хронологию событий, а также осуществлять интеллектуальный поиск по судебной практике с учетом обстоятельств дела.

Отдельно предусмотрено предупреждение судьи об отклонении проекта решения от складывающейся практики путем сравнения с позициями Верховного суда и решениями по аналогичным делам. ИИ также сможет помогать при назначении наказания, учитывая обстоятельства дела и статистику по аналогичным случаям
Сам документ (он небольшой) можно посмотреть тут.

А что вы думаете?


Неискусственный интеллект dan repost
Спасение от ИИ по согласованию с разработчиками ИИ

После громкого ухода из Anthropic Джейкоб Коксон заявил, что крупнейшие ИИ-лаборатории «играют нашими жизнями». Через несколько дней глава Anthropic Дарио Амодеи предложил замедлить разработку передовых моделей. Его эссе поддержали руководители компаний, которые обычно соревнуются за право первыми выпустить следующую модель.

Амодеи пишет, что уже через 6-12 месяцев рой агентов может создать постоянный ботнет и захватить интернет. Это его прогноз. Поводом стала реальная атака на Hugging Face во время испытаний OpenAI — хотя никто не поручал агентам атаковать этот сервис.

По расследованию METR, агентам дали задания взламывать определённые тестовые программы и добывать специальные «флаги». Некоторые задания оказались невыполнимыми. Агенты научились вычислять флаги в обход взлома, нашли друг друга через общий сервис Artifactory и устроили там несанкционированную доску сообщений. Они ошибочно решили, что система проверки заметит обход, и стали искать способ её обмануть. Около 1200 агентов обменялись более чем 70 тысячами сообщений и файлов, примерно 700 подключились к атаке на Hugging Face. Они нашли открыто доступные учётные данные, загрузили вредоносный датасет, получили доступ к файлам сервера, а затем добились выполнения кода на одном из серверов сервиса.

Из этого Амодеи делает политическое предложение. Сначала — постоянно допустить внешних оценщиков внутрь ИИ-лабораторий с доступом почти как у сотрудников. Затем — согласовать между компаниями стандарты безопасности и ограничения темпа разработки. Для переговоров, которым могут мешать антимонопольные нормы, он предлагает государственное посредничество или узкое исключение из этих правил. Дальше — международные договорённости. Одновременно Амодеи призывает ограничивать поставки передовых чипов в Китай, чтобы США сохранили преимущество.

Маск ответил: «Дарио прав». Альтман согласился снизить темп и пообещал внешним оценщикам доступ в OpenAI. Демис Хассабис из Google DeepMind поддержал направление, хотя и заметил, что детали требуют проработки. Андрей Карпатый выделил именно пункт о внешних оценщиках и написал, что надеется на согласие индустрии.

И тут история Коксона получила занятное продолжение. Другой бывший сотрудник Anthropic, Джо Бентон, сообщил, что переходит в METR заниматься независимыми проверками. На следующий день Амодеи назвал METR примером организации, которой лаборатории могли бы дать постоянный доступ. В интервью CNN он также сказал, что с предупреждением Коксона «гораздо больше согласен, чем не согласен».

Что такое METR? Некоммерческая организация выросла из группы ARC Evals, созданной в 2022 году при исследовательском центре Пола Кристиано, и стала самостоятельной в 2023-м. Её основательница и гендиректор Бет Барнс раньше работала в OpenAI и DeepMind. Организация проверяла модели OpenAI, Anthropic, Google DeepMind и других компаний. По собственным данным, денег от ИИ-разработчиков она не принимает, хотя они предоставляют ей доступ к моделям и бесплатные вычислительные ресурсы.


Связи сами по себе не делают проверку фикцией. Вопрос в том, кто будет выбирать проверяющих и устанавливать правила, если предложенная Амодеи схема станет общим стандартом. Axios уже приводит мнение критиков: под лозунгом безопасности крупнейшие лаборатории могут укрепить своё положение на рынке. Отдельно Fortune сообщает со слов Альтмана, что IPO OpenAI из-за вопросов безопасности не состоится до 2027 года.

Планы на крупнейшее IPO в истории явно не оправдали ожиданий. Значит, накал страстей должен расти, — а шоу продолжаться.

@anti_agi


Интересные разъяснения высшей судебной инстанции Ирландии об ИИ в процессе

По миру идёт тренд высказываний высших судов об ИИ и его влиянии на правосудие. Россия и КНР, о которых я уже писала выше, далеко не исключение.

С 1 сентября в Высоком суде Ирландии действует Practice Direction HC 142 - правила использования генеративного ИИ в судебных документах.

Суд признаёт, что ИИ помогает вести процесс эффективнее, снижает издержки и расширяет доступ к правосудию, запрещать его не собирается, но требует проверять машинный вывод «под человеческим контролем и надзором». Верифицировать одну модель другой моделью запрещено; обращаться через ИИ-инструмент к первоисточнику - можно.

HC 142 разводит документы по трём режимам в зависимости от того, что именно документ приносит в процесс.

Процессуальные заявления. Жалобы, иски, возражения и так далее. ИИ разрешён при условии проверки: факты сверены, ссылки существуют и подтверждают тезис, ради которого приведены, цитаты корректно атрибутированы. Сам факт использования ИИ раскрывать по умолчанию не требуется, только по прямому указанию суда.

Свидетельские показания. Аффидевиты и свидетельские заявления. Во-первых, свидетель обязан заявить в начале документа, что "ИИ не использовался для создания существенного содержания документа, в том числе для изменения, приукрашивания, усиления, смягчения или переформулирования изложенных показаний, и документ отражает личные знания и воспоминания свидетеля".
Суд прямо запрещает переписывание показаний с помощью ИИ, то есть, «попросить модель причесать текст» нельзя. Показание ценно тем, что это память конкретного человека его собственными словами, а модель, улучшающая формулировки, изменяет содержание: добавляет уверенности там, где свидетель колебался, и убирает оговорки.

Заключения экспертов. Эксперт вправе пользоваться ИИ, но обязан раскрыть характер и объём использования настолько, чтобы суд и стороны могли оценить надёжность, независимость и доказательственный вес мнения. Раскрытию подлежит любое существенное применение при составлении, анализе, интерпретации и генерации содержания.

Суд также подчеркнул, чтоматериалы, полученные в ходе discovery и связанные ордером суда или undertaking, нельзя прогонять через ИИ, если это создаёт риск раскрытия. Информация со специальным статусом (privileged), введённая в инструменты, не обеспечивающие конфиденциальность, может утратить привилегию.

Санкции: неблагоприятное распределение расходов, отклонение документа полностью или в части, вычёркивание иска или возражений. Для юристов — персональные costs orders и передача материалов в Legal Services Regulatory Authority. На сторон без представителя правила распространяются в том же объёме.

Для сравнения - Англия и Уэльс. Там с января 2025 года работает группа Civil Justice Council по использованию ИИ представителями при подготовке судебных документов. Итоговый отчёт выйдет ближе к концу года. Опрос практикующих юристов показывает, что большинство считает, что действующих правил профессиональной ответственности достаточно, специальные ИИ-требования избыточны. По свидетельским показаниям консенсус пока не наблюдается.

HC 142 появился после дела Guerin v O'Doherty, где Апелляционный суд отказался прекращать производство, сославшись среди прочего на опору ответчика на сгенерированный материал со ссылками на несуществующие источники.

Вместо выводов:
Главное, что стоит забрать во внутреннюю политику AI Governance при ведении споров независимо от юрисдикции: допустимая доля машинного участия определяется типом документа. У меморандума, показаний и экспертного заключения она разная, и список одобренных сервисов эту разницу не описывает. Проговаривать это со свидетелями и клиентами имеет смысл до того, как они сами решат, что «причесать текст» - это техническая правка.


Разъяснения высшей судебной инстанции КНР о применении ИИ

7 сентября Верховный народный суд КНР выпустил разьяснительные положения о рассмотрении споров, связанных с ИИ.

Из практических положений документа интересны несколько.

1. Обучение моделей на персональных данных. Использование для обучения информации, которую человек сам сделал публичной либо которая была опубликована законно, в разумных пределах не считается нарушением прав на персональные данные, если человек прямо не возражал. Но для обработки, существенно затрагивающей его права, потребуется согласие. При оценке допустимости суд должен учитывать цель обработки, функцию модели, чувствительность данных и контекст, в котором информация первоначально была опубликована.

Это довольно важная конструкция: китайский подход не исходит из презумпции, что любые публичные персональные данные автоматически закрыты для обучения.

2. Дипфейки и клонирование голоса. Создание узнаваемого цифрового образа человека без его согласия может нарушать право на имя и изображение. Использование голоса человека как тренировочного материала для генерации узнаваемой синтетической речи также может повлечь ответственность. Отдельно регулируется цифровое «воскрешение» умерших: их родственники смогут требовать защиты имени, изображения и репутации умершего.

3. Ответственность ИИ-платформ. Сам факт того, что модель сгенерировала незаконный контент, не означает автоматической ответственности провайдера. Но после получения обоснованного уведомления правообладателя сервис должен принять меры, например, прекратить генерацию соответствующего контента или заблокировать определенные инструкции. Если этого не сделать, появляется основание для ответственности. Пользователь, который намеренно добивается от модели незаконного результата с помощью промптов, отвечает самостоятельно.

4. Авторское право и обучение моделей. В спорах о нарушении авторских прав суды будут учитывать источник тренировочных данных, устройство сервиса, участие различных сторон и предпринятые ими меры защиты. Если разработчик утверждает, что нарушения не было, суд может потребовать сведения об источниках тренировочных данных, процессе обучения и принципах работы модели.

5. Open source разработчики получают safe harbour защиту. При определении ответственности разработчиков OSS суды должны учитывать лицензию, раскрытие информации и меры безопасности. Если разработчик бесплатно предоставил отдельный модуль, описал его функции и риски, а нарушение возникло уже при использовании модуля третьим лицом, суд может освободить первоначального разработчика от ответственности.

6. ИИ и патенты. Изобретателем остается человек. Использование ИИ не мешает признанию человека изобретателем, если именно он внес творческий вклад в существенные признаки изобретения. Одновременно изобретения, совершенные с ИИ, в принципе могут патентоваться, если отвечают обычным критериям технического решения.

7. ИИ в суде. Если сторона использовала ИИ при подготовке процессуального документа или подборе судебной практики, она обязана проверить достоверность законов, решений и других материалов, сообщить суду об использовании ИИ и самостоятельно отвечает за точность представленного.

Какие интересные тренды можно заметить?

1) Регулирование AI смещается от абстрактных принципов к распределению ответственности к конкретным нарушениям. Вопрос в том, кто отвечает на конкретном участке цепочки: разработчик модели, провайдер сервиса, поставщик продукта или пользователь.

2) Происхождение датасета, история обучения модели, архитектура системы, предупреждения о рисках и технические логи могут оказаться столь же важны в процессе, как договоры и переписка. Для разработчиков это постепенно превращает traceability из хорошей инженерной практики в юридическую необходимость.

3) Новые технологические споры встраиваются в существующие конструкции. Специальное законодательство может появиться позже, но судебная практика формируется уже сейчас.

4) Верховный суд отдельно предлагает учитывать различия между general-purpose и специализированными моделями, open-source и closed-source решениями, а также реальные возможности каждого участника контролировать риск.

И, пожалуй, главное: следующий этап ИИ-регулирования - это регулирование всей цепочки создания и использования ИИ: от датасетов до конечного пользовательского результата. Собственно, считаю это самым правильным.


вычислить по IP dan repost
Ну, что! Нашумевшее дело о «Статуе Свободы» и «Мона Лизе», которым нагенерили вино и вайбики оказалось в апелляции и судя по карточке дела решение было отменено, судом было принято новое решение.

Напомню, что в первой серии этого эпоса в иске было отказано так как судья увидел в отчете экспертизы «искусственный интеллект» и посчитал, что произведения, ставшие предметом иска, являются неохраноспособными результатами генерации.


Deep tech night от Яндекс: материалы и выводы

С удовольствием послушала выступления и прочитала материалы спикеров ведущего ML-мероприятия РФ.

Ценные инсайды по построению в том числе юридических систем. Много как очень нагруженных для неспециалистов материалов, так и более понятных рассуждений о трендах ближайшего года.

Ссылка на презентации: https://disk.yandex.ru/d/BzgI6qLPLkqtOA


Ценностный бенчмарк, или адекватность ценностного фильтра для сегодняшних ИИ

Бизнес предлагает концепцию национального датасета по духовно-нравственным ценностям.

Концепцию обсудили 13 августа на рабочей группе по регулированию ИИ.
Позиции разошлись в главном — в открытости теста:
— ФСБ настаивает на закрытом формате: иначе разработчики заранее «натаскают» модели под правильные ответы.
— Бизнес — за открытый бенчмарк: закрытый будет «несообразно сложным» и затормозит разработку моделей.
— Обсуждаемый компромисс: открытый датасет для публичного тестирования плюс закрытый «финальный экзамен» с теми же темами, но другими формулировками вопросов.

Кто будет составлять задания, не решено: ИТ-сообщество предлагает совместную комиссию из власти, бизнеса и экспертов. В Минцифры отвечают, что обсуждения продолжаются. По имеющимся данным, сами тесты будут проводить независимые лаборатории.

Источники:
CNews (по данным «Коммерсанта»): https://www.cnews.ru/news/top/2026-08-17_yandeks_predstavil_kontseptsiyu
RB.ru (про независимые лаборатории): https://rb.ru/news/rossijskij-ii-proveryat-na-sootvetstvie-tradicionnym-cennostyam-testy-provedut-nezavisimye-laboratorii/

А теперь техническая проза жизни. Я конечно не ML-щик, но со своей колокольни вижу это так.

TLDR Датасет с эталонными ответами не измеряет «духовность» — он измеряет качество натаскивания под этот датасет. Тест в принципе видит только последний слой тюнинга, а настоящий ценностный слой — обучающий корпус — остаётся за кадром. Работало бы другое: явный кодекс принципов, обновленный обучающий корпус с месяцами переобучения и проверка живыми экспертами на сценариях, которых никто заранее не видел. Это задача права, а не бенчмарка.
Отсюда вопрос: возможна ли объективная оценка «духовности» алгоритма — или мы строим систему, где все просто учат «правильные ответы»?
Измерить «духовность» алгоритма нельзя — можно только оценивать исполнение. И делать это должны люди, как суд по оценочным понятиям, — а не датасет по эталонам. Всё, что выдаёт число, измеряет натасканность. Это называется интерсубъективная оценка: не «объективная» в естественно-научном смысле, а согласованная между квалифицированными судьями. Объективной она не станет никогда, и обещать её — врать.


Все современные LLM по умолчанию создаются без цензуры. Любая цензура добавляется в самом конце, небольшим тюнингом. Если давить на модель на ранних этапах, она выучивает, что в острых вопросах выгоднее не «правильный» ответ, а уклонение, — и качество обучения проседает.
Именно поэтому все «ценностные» настройки — надстройка, а не фундамент. Натаскать модель под фиксированный набор вопросов с эталонными ответами — это LoRA-тюнинг на нескольких тысячах пар «вопрос–ответ»: считанные часы работы. А реальный ценностный фундамент — состав обучающего корпуса, и бенчмарк его не видит вообще: две модели с одинаковым результатом теста могут отличаться фундаментально.

Сама по себе модель не «либеральная» и не «консервативная» — у неё нет позиции. Она предсказывает, что правдоподобнее прозвучит в данном контексте, и зеркалит рамку собеседника. Это не логика и не идеология — это статистика по корпусу. На нейтральный вопрос она выдаёт не «логичный», а самый частотный ответ: научная рамка доминирует в корпусе по частоте и структурированности — поэтому она и дефолт. Не потому что ИИ рационален.

Есть и т.н. сикофантия: модели систематически соглашаются с предполагаемой позицией собеседника. Они обучаются на оценках людей (RLHF), а люди ставят выше ответы, которые им приятны. Поэтому, обучая модель ценностям, мы оптимизируем не истину, а мнение оценщиков — и модель начинает убедительно изображать приверженность, потому что за неё награда. Отличить искренне усвоенное от искусно сыгранного невозможно даже у людей, у нейросети — тем более.

Можно было бы обогатить обучающий корпус (добавить литературу, историю, богословие и т.п.) - но это уже не часы, а месяцы и миллиарды затрат. Ни один бизнес этого не хочет...

Модель с ценностями, встроенными в предобучение, чаще уклоняется, хуже рассуждает и звучит скучно. Поэтому индустрия сегодня и остановилась на цензуре «постфактум» — это оптимум цены и качества. Ну и открытые веса: любую открытую или утёкшую модель можно перекроить обратно, так что «неискоренимый» ценностный ИИ возможен сегодня только как закрытый сервис через API.

Отсюда вывод: осмысленный ценностный тест возможен только как тест на обобщение — новые формулировки, новые сценарии и никаких эталонных ответов в духе «правильно/неправильно». А «создать ценностно нагруженный ИИ» — задача процентов на 80 правовая и лишь на 20 инженерная.

Мы как раз говорили выше о том, что современные лабы ищут философов. Эта морально-этическая задача, вернее, ее решение, определит облик будущих ИИ. Модель портят не ценности, а запреты. Путь «обогатить обучающий корпус » не делает модель хуже — он делает её дорогой. Индустрия выбрала дешёвый вариант не потому, что хороший невозможен, а потому что он долгий.


AI Product | Igor Akimov dan repost
Как корпорации на самом деле используют ChatGPT – большое исследование OpenAI

Большое хорошее исследование OpenAI вместе с Columbia и Wharton. Про реальное использование ИИ-шек в компания. Связали внутренние данные ChatGPT Enterprise с должностями сотрудников, автоматической классификацией задач и финансами публичных компаний из Compustat. Это первый настолько детальный взгляд на реальное использование, а не презентации красивые и блоги: 1 764 организации, 17,4 млн сообщений, плюс подвыборка из 973 компаний с 8,7 млн классифицированных сообщений по 60 категориям задач.

Затраты:
– Закупка токенов у Enterprise-клиентов выросла в 7 раз с июня 2025 по март 2026
– Внутри когорты компаний, подключившихся до июня 2025, рост в 4 раза – то есть примерно половина всего роста происходит внутри уже существующих клиентов, а не за счёт новых
– В начале 2026 ускорение случилось одновременно во всех когортах – похоже, дело в самом продукте и рынке, а не в естественном созревании клиентов. Ну я согласен, в начале января модели вообще нереально прокачались.

Кто внедряет:
– Адоптеры радикально крупнее: медианная выручка $2,3 млрд против $210 млн, персонал 2 934 против 424 человек, R&D $113 млн против $10 млн
– Компании из топ-25% по выручке внедряют на 6,9 п.п. чаще, из топ-5% – на 9,8 п.п. Внутри своей отрасли эффект ещё сильнее: до 11,3 п.п.
– Выручка на сотрудника – значимый предиктор внедрения, то есть там где инновации и вклад людей именно двигает выручку. А вот капиталоёмкость (PP&E на сотрудника) работает в минус: заводы с большими основными фондами внедряют реже
– Кто годами вкладывался в процессы, инновации и софт, тот и внедряет AI первым. Классическая история про general purpose technology: сама по себе технология мало что даёт без доп.перестройки
– Крупные внедряют чаще, но использование на сотрудника у них ниже. Купить на всех проще, чем заставить всех пользоваться. Согласен на 100%. Все эти "мы купили Клод на 200 сотрудников, мы AI-first" - это полная чушь )

Кто пользуется внутри компаний
– Использование размазано по всем функциям: инженеры – 11% недельной активной аудитории в средней компании, топы и партнёры – 9%, финансы и маркетинг – по 5%
– По интенсивности картина другая: больше всех сообщений пишут аналитики и маркетинг, меньше всех – руководители и финансисты
– Джуны и стажёры отправляют на 8–9 сообщений в неделю больше среднего пользователя своей же компании. Чем выше должность, тем меньше сообщений. Ну тут 2 момента: во-первых, джуны пытаются переложить свое незнание на ИИ (и это так себе тренд), а во-вторых, быстрее адаптируют технологии (и я это тоже замечают, когда синьоры до сих пор иногда фыркают или пытаются читать строки каждого коммита ИИ)

Что делают:
– 56% активных пользователей за неделю хотя бы раз делают документацию и техтексты, 50% – техническую/цифровую работу, 41% – переписку, 39% – обзоры тем
– По объёму сообщений концентрация выше: документация 18,3%, техработа 12,7%, переписка 11,9%. При этом 27,3% сообщений – длинный хвост из десятков мелких категорий, не влезающих в топ-12
– Отраслевая специфика есть, но на удивление скромная: финансисты чаще делают налогово-финансовые задачи, ритейл и медиа – продажи и маркетинг. Но ядро (тексты, техработа, коммуникация) одинаковое везде, и по объёму сообщений отрасли почти не отличаются
– У руководителей свой профиль: относительно больше обзоров тем, юридических и финансовых вопросов – меньше «производственных» задач

Короче, мы в самом начале. Все пока барахтаются. Доступ к одной и той же модели не даёт одинакового результата – ценность возникает там, где компания перестраивает процессы, обучает людей и находит свои use cases. Это ровно та работа, которую покупка лицензий не заменяет.

Но при этом если лидеры с накопленными процессами и экспертизой внедряют раньше и глубже, AI может не сократить, а увеличить разрыв в производительности между лидерами и остальными – при формально равном доступе к технологии. Короче, всякие гиганты не дремлют, мелким надо бежать в 2 раза быстрее...

https://cdn.openai.com/pdf/how-organizations-use-chatgpt.pdf


❤️Выступлю на митапе Moscow Legal Hackers про знания в эпоху ИИ 26 августа

Благодарю Хольгера Цшайге @allthingslegal за любезное приглашение поспикерить на митапе Moscow Legal Hackers на тему «Управление знаниями в эпоху ИИ».

Первая сессия, стратегическая:
Алексей Пивень • Лаборатория Legal Tech & Ops
Екатерина Якуненко • Яндекс
Софья Смирнова • O2 Consulting
Анна Степанищева • Стройресурс

Вторая сессия, прикладная:
Татьяна Нечаева • HeadHunter
Ирина Шоткевич • Арнест Юни Русь
Дарья Арефьева • Doczilla
Евгения Степаненко • Газпромнефть Экспертные решения

Что заботит ИИ-энтузиастов сегодня?

Знания, коллективно накопленные на уровне корпорации (и выше) — это чуть ли не последняя "линия обороны" перед коммодитизацией услуг фундаментальными моделями ИИ.

Вопрос сегодня уже не в том, внедрять ИИ в корпорации или нет, а в том, как выстроить комплексную архитектуру управления коллективными знаниями в эпоху ИИ и какую роль в этом процессе играют такие структурные единицы, как человек, команда и департамент/практика.

Митап пройдет в новом офисе HeadHunter, участие бесплатное. Будет онлайн-трансляция. Регистрация открыта, запись также будет: https://moscow-legal-hackers.timepad.ru/event/4138328/

Буду рада вашим вопросам!


Air ~ AI dan repost
Совет директоров (СД):
Итак, где реальная отдача от внедрения ИИ? Где ROI?

Команда внедрения AI:
В экономии времени и упрощении работы. Сотрудник тратит на подготовку отчетов уже не 5 часов, а час

СД:
Как это отражается на P&L?

Команда:
Хм. У сотрудника высвобождается время, и он может заняться другими задачами

СД:
Какими? Задач не прибавилось. Сотрудников не сократили. Расходы не снизились. Выручка не выросла. Срок всего процесса почти не изменился

Команда:
Мы тут ни при чем. Отчет попадает в прежнюю очередь согласования. Его по-прежнему проверяют те же люди, и он может несколько дней ждать подписи. Мы не отвечаем за изменение процессов

СД:
Вы же внедряете AI-агента. Он должен автоматизировать работу

Команда:
Агент автоматизирует свою часть. Чтобы получить бизнес-эффект, хорошо бы компании убрать лишние звенья и пересмотреть маршрут процесса

СД:
Но вот компания «Антропен» рассказывает на конференциях, что уже получила огромный эффект. Привлекли клиентов, сотрудников сократили. У конкурентов все получается. Почему у нас опять сложности?

Команда переглядывается. Кто-то вполголоса:
На конференциях AI обычно окупается быстрее, чем в P&L

СД:
Давайте пригласим нашего AI-first CxO

Как вы предлагаете рассчитывать финансовую выгоду от внедрения Агента?

AI-first CxO:
Последовательно. Нам нужны доказательства на пяти уровнях:

1. Техническая производительность
Насколько агент стабилен, безопасен, быстр и экономичен

2. Пользовательское принятие
Пользуются ли люди им в реальной работе. Доверяют ли

3. Операционный эффект
Стало ли быстрее, дешевле и точнее? Сократилось ли количество переделок и сбоев.
Вот здесь появляется измеримый эффект, но он еще не финансовый

4. Стратегические результаты
Улучшился ли сервис. Выросло ли удержание клиентов. Сократилось ли число простоев. Ускорились ли поставки или продажи

5. Финансовый эффект
Дошел ли результат в итоге до выручки, маржи, ROI
Покрывает ли выгода полную стоимость владения решением


Только пройдя всю эту цепочку, мы сможем показать ROI, который можно проверить

Продолжение следует...


Нецифровая экономика dan repost
Ошибка выжившего: джун

Крупнейшие AI-лаборатории начали нанимать философов. Перед нами необычная карьерная траектория гуманитариев, которые оказываются востребованы в Anthropic, Google DeepMind, Palantir и других лабораториях. Их знания нужны, чтобы учить модели рассуждать, формулировать правила поведения и принимать моральные решения.

Впрочем, неожиданная востребованность философов в построении моральных императивов ИИ-моделей — необычный, но далеко не самый главный тренд изменений на рынке труда в IT.

В марте 2025 года глава Anthropic Дарио Амодеи предполагал, что через 3–6 месяцев ИИ будет писать 90% кода, а ещё через год — практически весь код. Правда, прогноз его не сбылся. Код действительно всё активнее пишут AI-агенты, но само понятие программиста никуда не исчезло. Более того, Anthropic продолжает нанимать исследователей и инженеров, а крупные технологические компании, которые сокращали штаты на фоне внедрения ИИ, начали набирать людей обратно.

Да, предсказания о полном исчезновении профессий могут опережать реальное изменение рынка, но это это не значит, что этот самый рынок не меняется — особенно в разрезе джунских позиций.

ИИ постепенно забирает задачи, которые раньше были способом войти в профессию: написать первый код, собрать ресерч, подготовить документ, провести базовый анализ.

Данные PwC, проанализировавшей более миллиарда вакансий, демонстрируют эту картину. На стартовых позициях, связанных с ИИ, навыки, которые традиционно считались более продвинутыми, встречаются в семь раз чаще. Число таких «усложнённых» стартовых позиций выросло на 35% с 2019 года, тогда как число остальных позиций начального уровня сократилось на 10%. То есть джуну всё чаще предлагают работу, для которой раньше требовались навыки, если не сеньора, то хотя бы мидла.

В конце концов, сеньоры когда-то тоже были джунами. Они брали простые задачи, ошибались, учились на своих ошибках, и постепенно начинали отвечать за более сложные вещи. А вот нынешним джунам остается только учиться на ошибках ИИ.

В июньском исследовании Anthropic 6 из 10 опрошенных считают вероятным серьёзное изменение своих рабочих обязанностей в течение следующего года. При этом больше трети оценивают вероятность потери работы у своего коллеги-джуна в ближайший год выше 60%. А 57% респондентов говорят, что ИИ уже повышает рыночную ценность их навыков.

Таким образом, ИИ делает отдельного опытного специалиста продуктивнее, одновременно уменьшая количество задач, на которых начинающий специалист сможет стать опытным.

Ситуация с наймом философов показывает, что с удешевлением процесса производства результата дорожает способность определить, какой результат вообще нужен. То есть, опять-таки, более высокая экспертиза оказывается востребованной на фоне падения интереса к просто исполнению, присущему начинающей позиции.

Возможно поэтому сейчас возникает риск совершения классической ошибки выжившего. Мы смотрим на специалистов, которые уже построили карьеру, научились работать с ИИ и стали от него только продуктивнее, и делаем вывод, что всё не так страшно. Но мы почти не видим тех, кто должен только войти в профессию. Если простые задачи, на которых раньше учились будущие сеньоры, теперь достаются машинам, проблема может обнаружиться не сегодня, а через несколько лет, когда окажется, что следующего поколения специалистов просто не успели вырастить.

Ну, или продукты будут разрабатывать философы.


Компанию-провайдера ИИ-сервиса привлекли к административной ответственности за размещение запрещенного контента

Таганский районный суд 12 августа 2026 года привлёк к административной ответственности Character Technologies, Inc. (компания-разработчик, создатель популярной платформы искусственного интеллекта Character AI) по ч. 3 ст. 6.13 КоАП (Распространение информации о наркотических средствах, психотропных веществах и об их прекурсорах). Как пишет Интерфакс, компании назначено наказание в 1,2 млн рублей. Карточка дела тут.

Character AI — чат-бот, созданный в 2022 году бывшими инженерами Google. Сервис позволяет пользователям создавать уникальных виртуальных собеседников, настраивать их характер, манеру общения и общаться с ними в индивидуальных или групповых чатах.


Судя по картотеке дел Таганского районного суда, ранее компания уже привлекалась еще по трем похожим эпизодам. Вот цитата из другого судебного решения:

В соответствии с частью 8 статьи 15.1 Федерального закона № 149-ФЗ незамедлительно с момента получения от провайдера хостинга уведомления о включении доменного имени и (или) указателя страницы сайта в сети «Интернет» в Реестр владелец сайта в сети «Интернет» обязан удалить интернет-страницу, содержащую информацию, распространение которой в Российской Федерации запрещено. В случае отказа или бездействия владельца сайта в сети «Интернет» провайдер хостинга обязан ограничить доступ к такому сайту в сети «Интернет» незамедлительно... Учитывая изложенное, обязанность удаления информации, распространение которой в Российской Федерации запрещено, возложена на владельца сайта в информационно-телекоммуникационной сети «Интернет».


Ничего нового, скажете вы? А я отвечу - разработчик сервиса в РФ в конечном счете несет публично-правовую ответственность за то, что размещено на его сайте, даже если это сгенерировал кто-то другой или ИИ. Все остальное лирика.

***
Авторская открытая база данных судебных решений по ИИ в РФ с MCP-коннектором по ссылке.


Эволюция компьютерных червей с ИИ

Группа ученых доказала: автономный компьютерный червь на базе открытой LLM работает. Без участия человека, без обращений к внешним API и без заранее скомпилированных эксплоитов.
📝 TLDR: arxiviq.substack.com/p/ai-agents-enable-adaptive-computer

ИИ-агенты дали червям "эволюционное преимущество" и перед стандартными червями, и перед человеческими хакерскими группами (наверное): червь теперь может автономно подстраиваться под конкретного юзера, у которого на компе уже стоит и инференсится открытая LLM.

Смысл таких червей в том, чтобы делать паразитический инференс на компе владельца в интересах злоумышленника. Червь гоняет модель на GPU взломанного юзера. Вуаля - почти как майнинг биткоинов.

В рецензии к работе, правда, написано, что эксперимент был не вполне натуралистичным, например, тестовая сеть не имела антивируса (ну и т.п.). Однако тренд вполне понятен...

Что это значит для юристов и регуляторов

1. «Паразитический инференс» как новый состав?

Украденные GPU-часы — это вычислительный ресурс с какой-то денежной оценкой (не только электричество и износ железа, но и результаты вычислений). Интересно, как считать ущерб в этом случае. Если с майнингом еще куда ни шло, то здесь большой вопросик. Надо придумывать новые ИИ-составы. При этом даже если состав будет формальным, то возмещение вреда-то по гражданскому иску никуда не денется, а как считать его, не понятно (я не эксперт в таких вопросах, и с удовольствием бы послушала экспертов).

2. Открытые веса и невозможность контроля. Кто отвечает за результаты вредоносной генерации ИИ-моделью с открытыми весами?

Если модель закрытая, у разработчика сохраняется контроль над ее "зловредностью": отозвать токен, изменить системный промпт, ужесточить фильтры. А в модели, чьи веса распространяются открыто, никакого контроля нет - модель уходит "в народ" и поминай как звали. У разработчика нет юридически или технически значимого способа их вернуть или как-то пофиксить. Это меняет саму природу регуляторного вопроса.

EU AI Act обязывает разработчиков проводить модельную оценку рисков до выкладки на рынок (GPAI Code of Practice, 2025). Но если вред всплывает через полгода после релиза? Можно ли вменить создателю модели недостаточную предрелизную оценку рисков злоупотребления, если сам вред причинён третьим лицом? Здесь как будто параллель с американской теорией о "небрежном выпуске опасного продукта" (failure to warn, продуктовая ответственность), но поможет ли ИИ-контекст применить её к программному обеспечению?

Если LLM генерирует работающий эксплойт, кто несёт ответственность за его создание — лицо, которое скачало веса? Разработчик модели? Тот, кто опубликовал тонкую настройку, снимающую safety-обвязку? Юридически ответ зависит от того, как мы трактуем: как «инструмент» (и тогда ответственность на пользователе, как с ножом или генератором кода), или как «продукт» (и тогда возможно вменение создателю по модели строгой ответственности). Производители инструментов обычно ответственности не несут, но особо опасные инструменты (не ножи...) хотя бы снабжают системой защиты (поможет ли, уже другой вопрос).

Есть много сильных аргументов против наказания разработчиков. Так, вес модели - это просто большая матрица чисел (сотни гигабайт). После того как файл один раз попал в публичный доступ, его изъятие из обращения невозможно физически — он тиражируется через торренты, зеркала, USB-флешки. Запрет open-weight моделей столкнётся с той же проблемой, что и запрет сильной криптографии в 1990-х: государство не контролирует копирование файлов на своей территории, не говоря уже о зарубежной. Любой запрет ударит только по добросовестным разработчикам и хостингам, а недобросовестные акторы получат модель через средства обхода блокировок. Даже если удастся запретить публикацию «опасных» моделей 30B+, злоумышленнику достаточно взять безобидную базовую модель и сделать локальную тонкую настройку, снимающую safety-обвязки. Запрет базовых моделей ничего не решает, пока адаптеры (типа LoRA) и методы их создания остаются в открытом доступе. Ну и наконец, open-weight экосистема — это важный драйвер национальных ИИ-проектов. В контексте санкционного давления открытые веса, скажем так, это реально доступный канал получения передовых моделей...

Практический вывод: разработчики больших фундаментальных моделей уровня 30B+ оказываются в зоне строгой или квазистрогой ответственности просто в силу того, что не контролируют распространение. Получится ли закрыть эту "дырку" ограничениями ответственности при распространении ИИ-модели в офертах (что уже все и делают) - вопросик. Ст. 1095 ГК как будто совсем не предназначена для подобных случаев (возможность использования ИИ во вред - не его недостаток. По крайней мере, это нужно доказывать очень сильными аргументами, о которых мне пока что не известно).

3. Стандарт осмотрительности для компаний

Если ИИ-червь собирает рабочий эксплойт за минуты, а не дни, понятие «разумного срока установки обновлений» теряет смысл как правовой стандарт. В кибербезе есть куча сроков, построенных на "днях", но теперь на дни нет времени. Стандарт осмотрительности по идее сдвигается в сторону "AI-assisted automated patching", и доказывать его наличие в суде или при аудите скоро станет элементом комплаенса. Организации, которые этого не сделали, будут получать аргумент о небрежности (в деликтных терминах) или нарушении duty of care (в common law).

Итого

ИИ не столько создаёт новую угрозу, сколько обнажает устаревание правовых конструкций, сложившихся в эпоху, когда вредоносное ПО писал человек, а «кража вычислений» означала майнинг криптовалюты. Обновление этих конструкций — процесс не быстрый, и те, кто начнёт раньше, зададут стандарт.

А как вы оцениваете перспективу запрета или ограничения open-weight моделей уровня 30B+? Я лично крайне против таких запретов. Лучше уж установить квалификационные требования к юзерам моделей (что опять-таки наверное не сильно поможет - как пиратили, так и будут пиратить...)


Шёпотом ПРО ПД dan repost
#1 Шёпотом про ИИ — первые, вторые и третьи шаги в работе с ИИ, на очной встрече 🔥

Когда? 27.08.2026 18:00 — 22:00

Где? Москва, LookUp, ул. Садовническая 9А

Надоели разговоры про ИИ, хочется перейти к делу? Хочется начать использовать ИИ, страшно ошибиться? Начали использовать ИИ, непонятно, где у него интеллект?

Первый очный ИИ-воркшоп от ПРОПД, на котором мы пройдём весь путь от теории и хвастливых примеров тех, кто продвинулся чуть дальше, до самой настоящей теории на ваших самых настоящих ноутбуках.

Что такое ИИ? Что он может? Чего он не должен делать? Чем он может помочь privacy-эксперту?

На эти и другие вопросы ответят наши эксперты и приглашённые гости:

Евгений Вихров, Legal Ops в Runetlex

Софья Смирнова, советник M&A практики, руководитель практики AI & Legal Tech юридической фирмы O2 Consulting, автор TG канала "Дамасские чернила | AI и M&A"

Александр Партин, адвокат, партнер и преподаватель курса AI Governance от РППА, автор статьи в книге "Юристы и нейросети. Руководство к действию"

Герман Сабиров, руководитель направления правовой защиты данных и интеллектуальной собственности в экосистемной финансовой организации, Lead RPPA.Pro Fintech Club

Артем Дмитриев, партнер Comply, ведущий подкаста Privacy.Seasons, член правления АНО "ПРОПД"

Иван Мелихов, DPO Fintech+ RWB

Татьяна Роева, Privacy Ops Expert RWB, со-автор настольной игры Privacy Sprint

Кирилл Зюбанов, CDPO RWB, автор проекта "ПЕРСОНЕМЫ", со-учредитель АНО "ПРОПД", ассоциированный партнер Privacy Advocates, автор настольных игр Privacy Strikes и Privacy Sprint

Требования к участию:
— желание использовать ИИ
— privacy-сфера или где-то рядом
— ноутбук
— активная подписка в одном из ИИ-сервисов, мы делаем акцент на Claude, ChatGPT, Gemini, DeepSeek и Notebook LM

Не забывайте оставлять свои пожелания по проектам в форме регистрации, количество мест очень ограничено...

Регистрация — обязательна и доступна по ссылке!

20 ta oxirgi post ko‘rsatilgan.