Из Solidity в AI и дальше


Гео и язык канала: Россия, Русский
Категория: Технологии


Обучение Solidity. Уроки, аудит, разбор кода и популярных сервисов

Связанные каналы  |  Похожие каналы
Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


Вторая сложность — как доказать, что установилось именно опубликованное. В первом варианте плана человек должен был сравнить скачанный архив с архивом, собранным из открытого кода. Это оказалось невыполнимо: сервер упаковывает архив сам, и байты сжатия могут отличаться. Решение такое: подписывается не архив, а опись версии — список файлов с правами и отпечатком SHA-256 каждого. Подпись делается ключом minisign (Ed25519 поверх хеша BLAKE2b), тем же, которым подписываются обновления приложения, и приложение не ставит версию без годной подписи. Приватная половина ключа хранится только на компьютере разработчика и никогда не попадает ни на сервер, ни в CI. Каталог версии в открытом репозитории — содержимое архива байт в байт, разложенное тем же кодом, которым сервер этот архив раздаёт. В репозитории лежит небольшая утилита на Go: одна команда проверяет подпись, сверяет каждый файл с описью, проверяет, что все образы закреплены дайджестом, а с ключом - archive сравнивает с тегом скачанный архив файл за файлом. Подпись можно проверить и стандартной программой minisign — публичный ключ лежит в репозитории, а его отпечаток опубликован ещё в двух независимых местах.

Третья часть — образы Docker. Раньше я собирал их на своей машине, и связь «этот образ собран из этого кода» держалась на моем честном слове. Теперь образы агента и Caddy собирает GitHub Actions самого открытого репозитория по метке agent- или caddy-, сразу для amd64 и arm64. Go кросс-компилируется, а не собирается в эмуляции: под QEMU он у нас однажды намертво зависал. Каждый образ получает аттестацию происхождения через Sigstore — подписанную запись о том, из какого коммита и каким процессом он собран. Проверить её можно командой gh attestation verify. По дороге обнаружилось, что сборка Caddy брала сторонние модули «самые свежие на сегодня», и из одного и того же кода в разные дни получался немного разный результат. Теперь модули закреплены точными версиями, а базовые образы — дайджестами.

На каждую метку версии GitHub запускает публичную проверку. Она сверяет подпись и опись, проверяет аттестацию наших образов и сравнивает исходники агента в коммите, из которого собран образ, с исходниками в метке версии, а заодно ищет в коде случайно попавшие секреты. Красный крестик у метки видят все. Сам CI защищён: все сторонние действия закреплены полным хешем коммита, а не тегом, который автор может передвинуть. У процессов минимальные права, сборка из чужих pull request не запускается вовсе. Опубликованные метки нельзя удалить или передвинуть никому, включая нас, поэтому ошибка в выпущенной версии исправляется только следующей версией. Так и случилось с первым выпуском: мы опубликовали его не в том порядке, и исходники агента в нём на пару комментариев новее образа. Переписывать опубликованное не стали, а написали об этом прямо в README. Начиная со следующей версии такое расхождение ловит автоматическая проверка.

Публикует всё это скрипт: он собирает зеркало строго по белому списку каталогов, сам гоняет те же проверки и откажется публиковать, если нашёл адрес наших серверов, путь с машины разработчика, приватный ключ или токен. Ссылки на открытый код есть на главной сайта (расскажу о нем позже), в документации, на странице загрузки и в самом приложении: на шаге проверки сервера ещё до установки и на экране установки — со ссылкой на метку именно той версии, которая поедет на ваш сервер.

Если все вышесказанное обобщить в пару слов то: я постарался сделать так, чтобы весь код, который будет установлен на сервере клиента мог быть проверен как вручную, так и автоматически. Кроме того, построена достаточно сильная защита от подделки пакета на каком-либо этапе.

Думаю, нужно добавить, что я сам бы такую систему не смог бы придумать, и всю работу сделал Claude Code, объясняя мне каждый этап и отвечая на вопросы "почему и как".

На самом деле, нейронки могут вас очень круто обучить новым сферам разработки, если вы будете не просто соглашаться со всем, что он предлагает, а задавать вопросы и также погружаться в тему.


Задача с полуоткрытым кодом

На днях, в процессе создания одного приложения, столкнулся с интересной задачей, кейсом которой хочу сегодня поделиться с вами.

История разработки долгая, поэтому опишу ее кратко: в работе я пришел к потребности отслеживать состояние сервера vps и сайтов в каком-нибудь "одном окне". Существующие решения меня не устроили и я захотел создать свое приложение, которое будет решать мои задачи. Ну, и в последствии сделать проект доступным для каждого.

Суть заключается в том, что ты ставишь пакет с опенсорс решениями к себе на vps и приложение может читать данные на основе запросов этого пакета. По сути, это полностью независимое локальное приложение. Данные никуда не уходят к третьим лицам. Только прямая связь между приложением на компьютере и личным vps. Работает без облака, без регистрации и смс.

И вот встала проблема доверия. Я-то понятно, создал приложение, собрал пакет, знаю, что там и как работает. Но если кто-то попросит меня установить к себе на сервер vps какое-то опенсорс решение без возможности изучить его, я просто пошлю подальше такую просьбу.

Задача осложнялась тем, что я не хотел открывать фактический код приложения. В идеале предполагалось, чтобы пользователи могли заранее изучить, все то, что будет ставиться на их сервер (сами или с нейронкой) и, что еще важнее, быть уверенными, что это будет именно тот пакет, который был открыт. Дальше будут технические подробности решения.

Граница проведена так: открыто всё, что работает на сервере клиента. Это установочные файлы (скрипты установки, обновления и отката, шаблон docker-compose, конфиг Caddy), исходники агента мониторинга на Go, наша сборка Caddy с модулями ограничения частоты и DNS, а также каждая команда, которую приложение отправляет по SSH: поиск сайтов и сертификатов, копии, проверка безопасности, чтение журнала установки. Само приложение для компьютера остаётся закрытым. Проверить, что закрытое приложение отправляет именно эти команды, по репозиторию нельзя — но всё выполненное на вашем сервере видно в журнале sudo или auditd.

Первая сложность была в самих командах. Они жили строками внутри кода приложения на Rust и собирались на лету, а выложенная копия рано или поздно разошлась бы с тем, что реально выполняется. Пришлось вынести все 36 скриптов в отдельные файлы. Приложение встраивает их в себя при сборке без изменений и добавляет только две вещи: параметры строками вида ИМЯ='значение' в начале файла и данные (содержимое загружаемого конфига или текст SQL-запроса) на место специальной метки — только вызовами функций, объявленных в самом файле. К каждому скрипту есть строка в описи SERVER-SIDE.md: когда запускается, что читает, что меняет. Автоматические тесты следят, чтобы опись не отставала: каждый файл назван в описи, каждый модуль приложения, который ходит на сервер по SSH, тоже в ней есть, а скрипт, собранный строкой в коде на Rust, роняет тесты. Все скрипты прогнаны на настоящем Linux, включая полный запуск установки.


Какой язык программирования учить сейчас?

На днях в Твиттере увидел небольшой пост о развитии нейронок и агентов для программирования и то, как это влияет на текущий тренд в использовании языков для разработки проектов. Кратко говоря, там говорилось, что при стирании границ между сложностью изучения языков, ведь для llm вообще без разницы, что использовать, чаша весов будет склоняться в сторону более быстрых и оптимальных языков программирования, вроде Rust или Go. Python же может отойти на второй план.

В общем, мне кажется, что это имеет смысл.

Я работаю сейчас над двумя своими новыми задумками, и с развитием моделей вроде Opus 5 / Fable 5.1, я перестал контролировать выбор языка для написания приложений. После нескольких итераций по архитектуре приложений, выбор был сделан в сторону Rust в одном случае, и Rust / Go в другом. И выбор аргументировался тем, что с ними будет меньше проблем при реализации кода, а также они намного быстрее работают.

К чему это может привести на рынке?

1. На мой взгляд, в течение последующих нескольких лет крупные игроки также начнут оптимизировать свои платформы, снижая затраты на оборудования и нагрузку на него.
2. Знания языков, в плане технических интервью, могут отойти на второй план. На собеседованиях могут начать спрашивать не столько самому написать код, сколько написать запрос в нейронку на создание блока кода с определенным техническим решением. И тут от кандидата потребуется знать намного больше "общей" информации о языках и программировании, чем о формировании циклов в Python или Rust. Нужны будут знания алгоритмов, сетевых архитектур, базовой математики, работы dns и cdn, и т.д.
3. Оценены будут только сеньоры с опытом до бума программирования с нейронками. Вероятно, только они смогут создавать абсолютно новые решения, тем самым двигая и развитие нейронок.
4. Для нас с вами появятся места для поддержания и развития продукта, мелкой разработки и оркестрации потоков агентов.
5. При этом вполне вероятно, что задачи в компаниях уже будут распределяться не тимлидами и руководящими должностями, а другим типом нейронок типа Jev. Это сделает процессы более быстрыми и прозрачными.

Вообще очень интересно к чему это действительно приведет. А какие у вас прогнозы?

#langs


Интересная модель Jev

Буквально пару дней назад в Твиттере многие начали обсуждение новой модели Jev от TypeSafe. Вообще, сначала появился небольшой пост на HackerNews, а затем пошел какой-то невиданный ажиотаж вокруг этой недо-llm пере-ml. Далее расскажу, что в ней особенного.

Jev показался мне интересным не столько как очередная AI-модель, сколько как попытка переосмыслить интерфейс между AI и обычным софтом.

Классический ML обычно решает конкретную задачу: классификация, ранжирование, регрессия. Если появляется новая задача, под неё часто приходится собирать данные и обучать отдельную модель.

LLM пошли в другую сторону: одна универсальная модель может решать огромное количество задач, но взаимодействие с ней обычно происходит через генерацию текста. Даже когда мы просим JSON, внутри всё равно остаётся token-by-token генерация, а значит появляются задержки, стоимость, парсинг и проблемы с надёжностью интерфейса.

Jev предлагает промежуточный вариант. Вместо генерации произвольного текста модель возвращает типизированное решение и вероятность этого решения. То есть AI становится чем-то вроде "вероятностной функции" внутри программы.

Условно:

input → model → { decision, probability } → application logic

То есть модель не генерирует произвольный текст. Вместо этого разработчик задаёт пространство возможных решений, а модель возвращает структурированный результат и confidence.

В таком виде AI становится похож на "вероятностную функцию" внутри обычного software:

if model(x).probability > threshold:

Это особенно интересно для AI workflows и агентов, где не обязательно отдавать модели контроль над всем процессом. Можно декомпозировать workflow на десятки небольших решений: routing, classification, risk assessment, tool selection, human escalation и т.д.

При этом Jev не заменяет классический ML там, где есть много хорошо размеченных данных и одна стабильная задача. И это не замена LLM для сложного reasoning или генерации текста.

Интереснее другое: может появиться отдельный слой между task-specific ML и большими генеративными моделями — достаточно универсальный, чтобы не обучать новую модель под каждое решение, но достаточно специализированный, чтобы работать намного быстрее и дешевле LLM.

Если такой подход действительно удастся масштабировать для реальных приложений, у разработчиков может появиться новый базовый инструмент для создания ИИ-систем — не чат-бот и не обычный классификатор, а модель, которую можно напрямую встраивать в логику программы и использовать для принятия отдельных решений.

На данном этапе модель находится в стадии листов ожидания, и подать заявку можно здесь: https://typesafe.ai/

А буквально утром, пару часов назад, они выкатили доступ и на OpenRouter: https://openrouter.ai/~typesafe/jev-latest

#jev


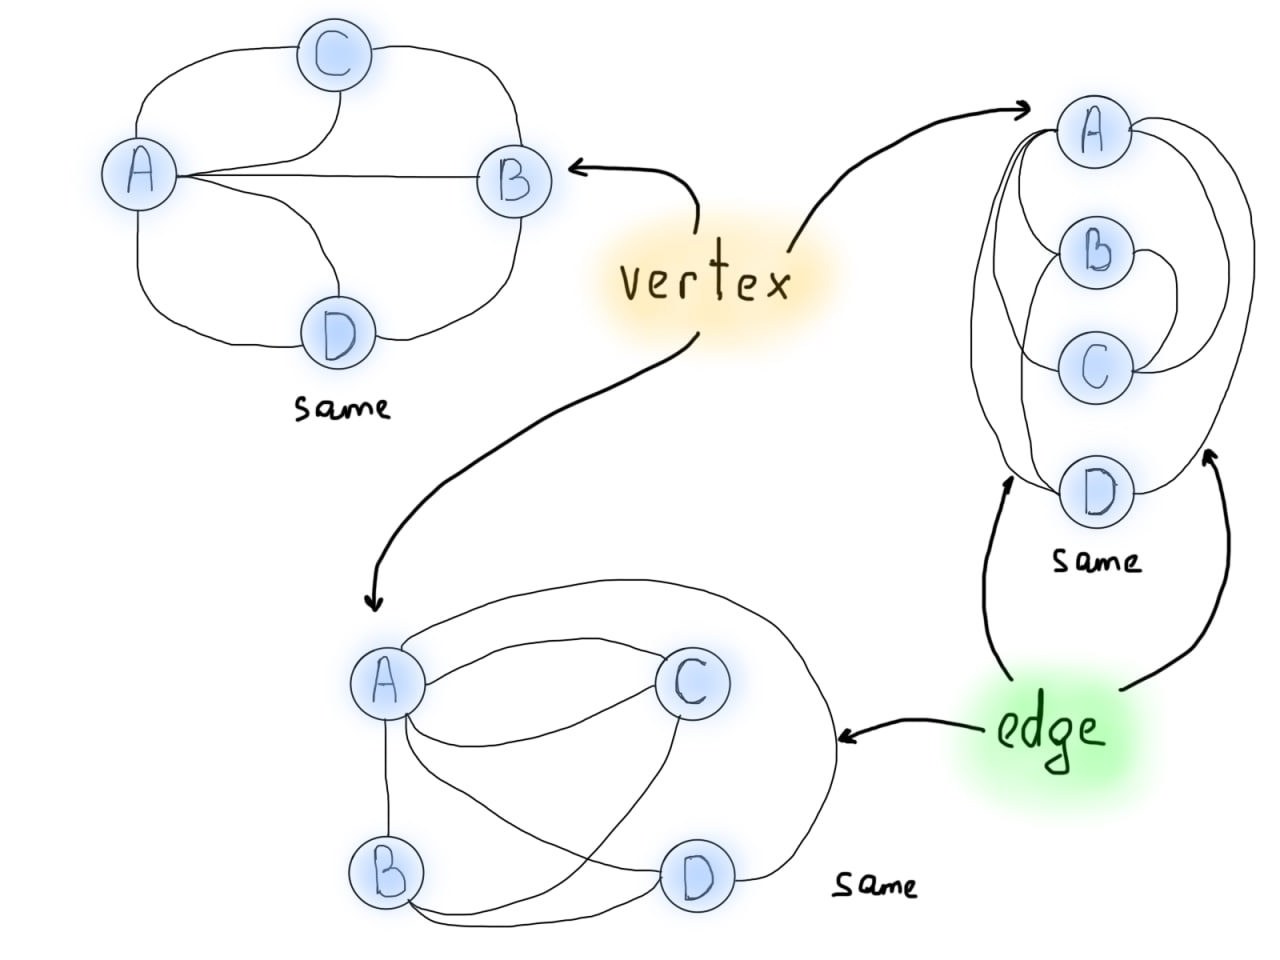
Графы повсюду

Если вы также следите за новостями в мире ИИ, то наверняка уже все чаще встречаете слово "граф": graph Rag, графовые нейронные сети, графовые агенты и т.д. Даже популярный блогер - математик Tivadar Danka обращал внимание, что "самый недооценённый факт линейной алгебры заключается в том, что матрицы - это графы, а графы - это матрицы".

И тогда я задумался, что, вероятно, графы это не просто схематическое изображение чего либо, а какая-то неизученная мной сфера. И оказалось, что есть полноценная математическая область посвященная исключительно изучению графов - Теория графов.

В то же время мне на Озоне попалась книга "Введение в теорию графов" от Робина Уилсона, пятое издание. После быстрого изучения содержания книги и радости, что там много рисунков графов, я решил купить ее. Далее пару слов скажу о книге.

Если вы не математик и не любите математику, то не покупайте эту книгу. Только поначалу она кажется понятной, но чуть дальше идут сплошные теоремы и их доказательства. Это действительно сложно читать, если вы не собираетесь сильно погружаться в детали. Все эти обороты: "тогда и только тогда, когда...", "из следствия выше исходит, что..."... Очень мало понятной теории.

Лучше посмотрите видео на Ютуб по теории графов...

В общем, графы оказались куда более глубокой и интересной темой. И результаты работ по этой области окружают нас повсюду: от нейронных сетей до навигации по картам в городе!

Это сложно (пока что) объяснить, но при понимании структур графов (узлы, грани, вершины, листы, циклы и петли) начинаешь по другому смотреть на некоторые концепции линейной алгебры и манипуляцией с пространством в ней: растяжение, сжатие и повороты. Понимаешь, что "самый быстрый маршрут" на карте, это проработанный алгоритм Дейкстры, и в основе его те же взвешенные графы и поиск пути между вершинами. Удивляешься, что графы можно легко переложить в матрицы и проводить матричные операции.

А если вы научитесь понимать продвинутые концепции теории графов типа матроидов и трансверсалей, то даже сложные алгоритмы вам покажутся очень логичными и простыми.

Если вы хотели получить новые интересные теоретические знания за пару недель, то очень рекомендую обратить внимание на теорию графов и изучить базис.

#graph


GTA6, Cyberleek, блокчейн и безопасность

Увидел несколько постов (тут и тут) про Cyberleek — хакера или группу, стоящую за утечками материалов по GTA 6, — и решил сделать пост на канале, так как это высший уровень анонимности и профессионализма!

У них довольно необычная система контакта, построенная вокруг Session и Monero.

Пройдусь кратко, о чем узнал из твитов.

На странице Contact сайт сначала генерирует новую анонимную учётную запись Session и выдаёт recovery-фразу из 12 слов. Её нужно сохранить самостоятельно: если потерять эти слова, восстановить аккаунт уже невозможно, и Cyberleek не сможет связаться с вами.

После этого генерируется уникальная сумма в Monero. Например, на скриншоте — 400.818811529987 XMR. И здесь самое интересное: Cyberleek прямо пишет, что цифры после десятичной точки являются уникальным ID. Отправить нужно именно эту сумму, без округления.

Получается, 400 XMR — это contact fee, а 12 цифр после запятой используются как идентификатор конкретного Session-аккаунта. По описанию системы, эта информация генерируется на стороне клиента, поэтому после получения платежа Cyberleek может определить соответствующий Session и связаться с отправителем.

Именно поэтому они рекомендуют отправлять Monero с личного кошелька вроде Cake Wallet или Feather, а не с биржи. При выводе с exchange дробная часть суммы может быть округлена или изменена, и тогда идентификатор перестанет работать.

При этом это не совсем тот ransom-сценарий, который можно было представить из новостей о хакере. На самом сайте Cyberleek отдельно подчёркивает, что это не выкуп за прекращение утечек. Они заявляют, что привлекают средства через поддержку сообщества и стратегические партнёрства, а Monero-платёж используется как плата за установление контакта. Через Session можно обсуждать рекламные размещения, например watermark'и в видео, или заказывать эксклюзивные и кастомные игровые материалы для конкретных брендов.

Интересно устроен и сам сайт. Он размещён через Arweave — децентрализованную сеть хранения данных, а доступ к нему осуществляется через множество gateway сети ar.io. Поэтому отключение одного сервера или gateway не означает, что сайт исчезнет: тот же контент продолжает храниться в Arweave и может быть доступен через другие точки входа.

В итоге получается довольно необычная комбинация: Session для приватной коммуникации, Monero одновременно как платёж и механизм идентификации контакта, а Arweave — для устойчивого размещения сайта.

Это, конечно, само по себе не доказывает, что Cyberleek — именно группа профессиональных хакеров. Но их инфраструктура явно отличается от банальной схемы с Telegram, обычным криптокошельком и арендованным сервером. Здесь заметен осознанный упор на приватность, децентрализацию и устойчивость инфраструктуры.

И что особенно интересно — за довольно троллинговым образом Cyberleek скрывается достаточно продуманная техническая часть.

P.S. Сайт хакеров не хочу распространять, поэтому ссылок не будет.

#leak #monero


Работа с чистой энергией

Дисклеймер

Сегодня ава и название канала, наконец, поменялись. Я долго колебался на этот счет и думал оставить "как есть", но лучше уже сделать этот шаг и перейти более регулярным постам на темы, которые заходят и нравятся мне самому. Надеюсь, вам все также будут заходить формат.

---

Мне нравится, что когда коммерческая технология заходит в тупик, она ищет новые пути решения намного эффективнее, чем какая-либо другая структура. Она нанимает специалистов из смежных областей, открывает гранты и лаборатории, старается найти решение в местах, куда другие даже не смотрят.

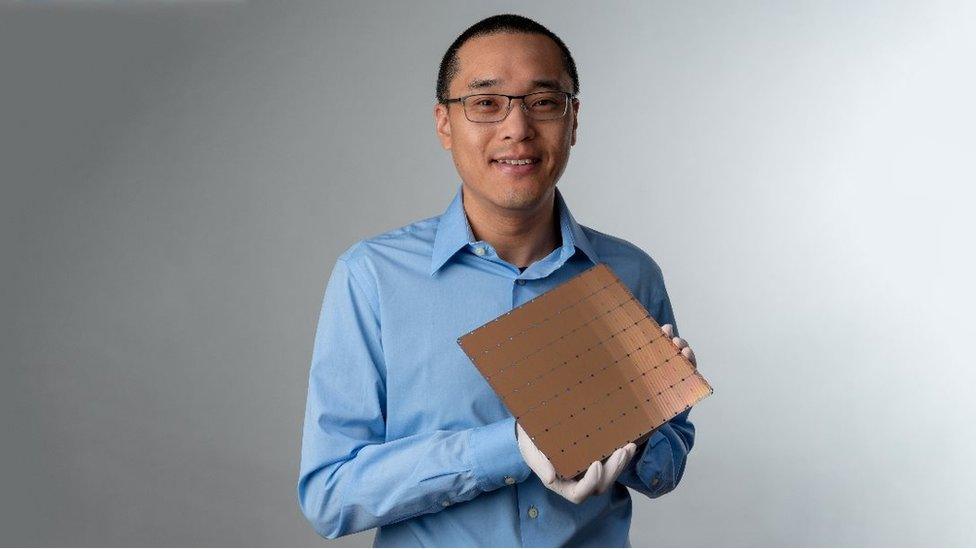
Также произошло и с компанией Cerebras. Это компания, которая разрабатывает суперкомпьютеры и процессоры для ускорения работы искусственного интеллекта.

Недавно она презентовала свои новые чипы, которые по площади гораздо объемнее всех остальных чипов (она на фото к посту). И многие стали шутить, что с такими "решениями" чипы станут размером с солнечные панели.

Но для тех, кто попытался разобраться в этом, открылась реальная причина в таком размере.

Cerebras долго разбиралась как сделать свои чипы эффективнее. Все мы знаем, что в мире, из-за развития ИИ, стало строиться гораздо больше дата центров и выпускаться чипов для них. И в какой-то момент это стало практически лидером по потреблению электроэнергии.

На регулярное обучение сверхмоделей и поддержки бесплатного доступа к чату (а значит и к вычислительным мощностям миллионам пользователей) требуется огромный расход энергии каждый день.

В итоге все упирается в то, сколько энергии и как потребляют эти чипы.

По расчетам Cerebras для перемещения 1 бита информации в чипе требуется около 1–10 pJ энергии. А с их новым чипом большей площади для той же операции требуется всего 0.1 pJ энергии! Экономия значительная!

Это достигается за счет того, что перемещение битов информации в рамках чипа намного дешевле, чем перемещение данных с одного чипа на другой.

На мой взгляд это потрясающе! В то время, как все взгляды устремлены на флагманские модели типа Астры и Фейбл, такие компании действительно делают революцию в мире.

#chips


Поиск на основе триграмм

Если вы разрабатываете свои агентные системы и "второй мозг", где необходим поиск по огромным массивам документов, то эта новость для вас.

Microsoft выпустила tgrep — инструмент для очень быстрого поиска текста по большим кодовым базам. Он уже используется внутри GitHub Copilot CLI.

Главное отличие tgrep от обычного grep или ripgrep в том, что он использует предварительно построенный индекс.

Обычный поиск при каждом запросе проходит по файлам проекта и проверяет их содержимое. ripgrep делает это очень эффективно и быстро, но принцип остаётся тем же: файлы нужно просмотреть при выполнении поиска.

tgrep сначала индексирует проект. Во время индексации он анализирует содержимое файлов и создаёт специальный триграммный индекс. Триграмма — это последовательность из трёх символов. Для каждой такой последовательности индекс хранит информацию о том, в каких файлах она встречается.

После этого при поиске tgrep сначала обращается к индексу и определяет небольшой набор файлов, в которых вообще может находиться искомый текст. И только затем проверяет эти файлы непосредственно.

Например, если в репозитории 500 тысяч файлов, поиск не обязательно будет читать все 500 тысяч. Индекс может показать, что подходящие файлы находятся, например, среди нескольких сотен — и проверить нужно уже их.

При этом индекс не остаётся статичным. tgrep может работать в режиме сервера, который отслеживает изменения в проекте и обновляет индекс при изменении файлов.

Именно поэтому основное преимущество tgrep проявляется при повторных поисках в очень больших репозиториях.

В тестах Microsoft поиск по Firefox занимал у ripgrep около 33 секунд, а у tgrep — около 643 миллисекунд. Для Chromium результаты составляли примерно 41 секунду против 2,6 секунды, а для Linux — 5,4 секунды против 256 миллисекунд.

То есть в зависимости от проекта поиск может ускоряться в несколько, десятки и даже больше раз.

При этом tgrep не является безусловной заменой ripgrep. Для небольших проектов предварительная индексация может быть просто не нужна. Если нужно один раз найти что-то в нескольких тысячах файлов, обычный ripgrep зачастую будет проще.

tgrep имеет смысл там, где кодовая база очень большая, а поиск выполняется постоянно.

По сути, его основная идея довольно простая: не искать одно и то же по всему проекту заново при каждом запросе, а заранее создать индекс и использовать его для следующих поисков.

Для агентных ИИ такая система поиска тоже может быть очень полезна. Агенту часто приходится много раз искать по исходному коду: находить функции, классы, места использования переменных, похожие участки кода или конкретные реализации. Если проект большой, использование индексированного поиска позволяет выполнять такие операции значительно быстрее и не тратить время на повторное сканирование всей кодовой базы.

В RAG-системах принцип похожий. Вместо того чтобы каждый раз просматривать весь набор документов или файлов, можно использовать индекс для быстрого определения релевантных документов, а уже затем передавать найденное содержимое модели. При этом tgrep не заменяет векторный поиск: это другой подход. Его сильная сторона — очень быстрый точный поиск по содержимому, который можно использовать как отдельный этап retrieval или вместе с семантическим поиском.

#indexsearch


Рефлексия в понедельник утром

Раньше многие мелкие предприниматели шутили, что чем меньше у тебя денег, тем больше ты сам маркетолог, seo'шник, юрист, бухгалтер и уборщик. Эта тенденция сохраняется и сейчас, только теперь к ним добавились еще и разработчики, они же вайбкодеры.

Еще буквально год-два назад тебе было достаточно иметь хорошие знания в одной области разработки: фронтенд, бекенд, девопс и т.д. Да и специализация была зачастую в одном языке программирования.

Сейчас же границы стираются, и разработчику потребуется понимать вообще всю теорию, на которой ведется его проект: от фронтенд фреймворка и устройства бекенда до серверных движков и различий в мощностях vps.

Когда я разрабатывал свои проекты mcp клиента, lazyauditor или пайплайны для аудита, то одним из требований для нейронки было использование того стека, что я хорошо знаю. Я хотел контролировать каждый шаг claude и проверять код практически вручную. Тогда единственным новым шагом было для меня загрузка на vps сервер. С подсказками нейросети все прошло отлично.

Далее были еще пара проектов, где я столкнулся с проблемой мощности сервера. Пришлось изучать как это все устроено и что с некоторыми проблемами можно справиться только "рублем", но я уже представлял, какая нагрузка меня ждет и к чему нужно быть готовым.

Чуть позже, этой весной, когда вышли более сильные модели типа claude 4.8, я решил прогнать проекты на безопасность. И вот тут меня и накрыло...

В каждом случае, когда я полагал, что предусмотрел все дыры в реализации, всегда находились серьезные проблемы, в тех местах, о которых я даже не подозревал. Тогда я понял, что если разработчик специально не изучал безопасность и взлом вебсайтов, то он никогда не сможет предусмотреть и половины всех проблем в своем проекте. Не потому что он может плохо знать какой-то язык, а потому, что он просто не увидит всю картину целиком.

В смарт контрактах, даже в тех, что считали крупными на 5000 - 10 000 строк, всегда находили проблемы. А представьте, сколько проблем может быть в коде на 100 000 строк или миллион?

Сейчас же, с выходом передовых моделей, все грани языков и разработки полностью стираются. Уже не важно знаешь ли ты язык и на каком уровне им владеешь, нейронка будет делать это лучше.

P.S. Я не беру сейчас во внимание разработчиков уровня Линуса Торвальдса. Речь идет о 99% остальных программистах.

Сейчас я пробую создавать проекты на Rust и Go, вообще не проверяя код, а только финальный результат. И это действительно работает. Базовые знания алгоритмов, циклов, структур данных - помогают мне понимать код с подсказками нейронок.

Разбивка по спринтам, циклы аудитов кода, проверка на безопасность различными моделями позволяют создавать достаточно хороший код в сжатые сроки. И я понимаю, что даже со знаниями этих языков, я бы не написал лучше...

Все это я веду к тому, что через год-два разработчикам нужно будет изучать только теорию. Но теорию вообще всего: и фронтенд языка, и бекенд, и девопс, и контейнеров, и всего остального. Просто потому, что нейронка все равно сделает это лучше.

Лучшее, что вы можете сейчас сделать для себя, это купить книги, типа "Разработка высоконагруженных приложений" и потихоньку изучать, как все устроено.

Люди становятся оркестраторами высшего уровня для нейросетей.

#dev

613 1 10 24 24

Датасет в опенсорс

Так как я решил завязать с аудитами смарт контрактов до какого-нибудь следующего "большого бума" в этой сфере, то смысла держать проекты по этой теме на сервере нет. Поэтому я решил открыть код одного проекта, который так и не вышел из беты и большой датасет с уязвимостями в смарт контрактах.

1. https://huggingface.co/datasets/Zaevlad/audit-findings-dataset

Тут находится датасет с 23 625 уязвимостями, которые я собрал весь прошлый год из различных аудиторских отчетов частных аудиторов и конкурсных платформ.

И тут его версия на гитхаб: https://github.com/zaevlad/solidity-audit-findings-dataset

Буду признателен за пару звезд!

P.S. Единственно что, я не нашел полностью очищенный и подготовленный сет для тренировки моделей, и данный вариант его исходная версия. Другими словами, все уязвимости распределены по категориям, по весу, по описаниям и т.д. Но чтобы обучат нейронки на них, потребуется привести все к общему формату и убрать большие части.

2. https://github.com/zaevlad/lazyauditor_open

Это был проект, который я делал для себя для ленивого аудита контрактов. Грубо говоря, тут мы добавляем проект смарт контракта с гитхаб, он парсится и разбивается по функциям в древо. Потом можно изучать каждую функцию отдельно и задавать вопросы нейронке прямо во встроенном чате.

Также можно добавлять документацию для дополнительного контекста, которая через rag будет добавляться к запросам к модели ии.

Отдельно стоит упомянуть, что тут я экспериментировал с сжатием смарт контрактов для экономии токенов без потери качества и смысла. В некоторых случаях удавалось сократить контекст контракта до 60%!

Это бета версия, так как содержит ошибки и недочеты, до которых не дошли руки. Если вы делаете что-то подобное, то может какие идеи из моего репо придутся вам по вкусу или какой-то код сможете взять к себе в наработки.

Надеюсь, у вас тут получится лучше, чем у меня!

#opensource

790 1 30 18 26

Последние новости и смена парадигмы

Привет всем! Давно уже я не делал постов на канале, хотя несколько раз планировал вернуться, но все никак не мог подобрать слова. Если кратко, то я думаю сменить основную тему с Solidity на более обширную: по машинному / глубокому обучению, агентного ИИ, математики и всего, что связано с этим напрямую и косвенно. При этом, если что-то будет происходить действительно интересное в мире web3, новости об этом обязательно будут появляться и тут.

Учитывая то, что я по прежнему люблю Solidity, блокчейн и аудиты, я все больше замечаю некоторый стазис в сфере. Вместо того, чтобы как-то развиваться в массы, разработчики за последние несколько лет не придумали ничего нового, кроме как очередной defi или l2 блокчейн. Даже оплату криптой принимают единицы! Я писал в чате, что если бы популярные платформу типа Steam, Ollama, Spotify начали принимать оплату в крипте, это позволило бы сделать новый толчок в адаптации критовалют у простых пользователей сети. Но этого не происходит и в планах нет...

С ИИ другое дело - этот хайп не останавливается уже третий год, и с каждым выходом новой модели становится только сильнее. И при этом все снова движется с огромной скоростью.

Я помню, как в 2022 нужно было просто знать Solidity, чтобы получить работу. Потом добавились тесты, потом знание l2 сетей, потом основы безопасности и к концу 2025 года требовался действительно впечатляющий объем знаний для получения работу в этой сфере.

Так же и в AI. Сначала требовался навык написания промтов, потом появился rag, потом оркестрация, потом агенты. И сейчас это объемная сфера, где машинное / глубокое обучение стоит в центе всего, и при этом абсолютно не требуется, чтобы использовать эти технологии.

Я начала свой путь в изучении ml/dl (machine learning / deep learning) около 1,5 лет назад. Сначала меня просто интересовали модели ии: что это такое, как работает, какие определения там есть и т.д. А с прошлого года, практически с сентября, я ушел в самые основы всего.

Тогда пришлось читать много и постоянно. Я понимал, что без математики ничего не получится. С ноября я учил этот предмет с преподавателем: базовую и линейную алгебру, матанализ, статистику и байесовскую статистику. Основным запросом было не "поступить на мехмат", а, скорее, комфортно читать разборы машинного обучения и Дайзенрота. В общем, это получилось.

Позже я с апреля усиленно втягивался в разработку: учил numpy, pandas, matplotlib, seaborn и застрял на sklearn. Тут огромное количество метрик, где ты должен хорошо разбираться в мат расчетах, чтобы пришло понимание, как это все использовать. И на этом этапе немного перегорел. С начала июля вообще не мог ничего ни читать, ни учить.

Понятное дело, и канал вести совсем не хотелось.

В середине августа стало легче. Я потихоньку начал возвращаться к обучению и книгам. Делать свои проекты, копаться в работе агентов и т.д.

И вот после всего этого я решил, что лучше не закрывать канал, а просто сменить основную тему и постить "что вижу, то пою" по новой теме.

Надеюсь, новый формат вам также зайдет как и посты про Solidity.

Еще раз: рад всех видеть и надеюсь, что дальше мы пойдем вместе!

#offtop


Обучение и обновление VulnFlow

Очень интенсивный месяц для моего обучения. С момента старта учебного отпуска я практически заново изучил numpy, matplotlib, pandas и seaborn. Выполнил более 100 упражнений (и Claude делает действительно отличные подборки задач по указанным ему материалам). В итоге словил информационный перегруз...

У меня это такое ощущение, что код прекрасно понимаешь и читаешь, можешь написать разбор за какое-то время, и при этом каждая строка кода дается с невероятными усилиями... Мозг как будто просто отключается от продумывания написания функций. Да и другая образовательная информация пропускается мимо строк, как например, когда вы читаете абзац и потом не понимаете, что только что произошло в тексте...

И получается, что мой лимит "задротства" около месяца интенсива. И нужно отдохнуть.

Вместе с этим в начале месяца встретил крутой репо на гитхаб - OpenGenerativeUI. Грубо говоря, это проект для чата с моделью ИИ, в котором она может создавать различные артефакты: html, канвасы и т.д. И я подумал, что это отлично может вписаться в мой проект VulnFlow, о котором я писал раньше. И вот такое обновления я выпустил вчера.

Главное изменение — полностью переработанный AI Chat. Теперь это не просто окно с ответами модели, а полноценный агент, который понимает состояние текущей сессии и может работать вместе с пользователем внутри интерфейса.

Чат теперь постоянно видит активную вкладку, состояние pipeline, структуру workspace, подключённые ресурсы, документацию и другие данные контекста. Благодаря этому ответы стали не абстрактными, а напрямую привязанными к текущему процессу аудита и анализа.

Сам агент теперь умеет не только отвечать текстом. Он может читать файлы проекта, искать информацию в RAG-документации, использовать внешние инструменты и базы знаний, анализировать pipeline и даже изменять его в реальном времени через "canvas actions".

Например, можно попросить агента добавить новый слой верификации после узла для аудита — и он сразу изменит граф pipeline прямо в интерфейсе. Все действия логируются, а изменения можно откатить через undo.

Сильно изменился и сам формат ответов. Вместо обычного текстового вывода ответы теперь состоят из отдельных потоковых частей: markdown-блоков, статусов вызова инструментов, визуальных карт плана, интерактивных iframe-виджетов, canvas mutations и системных сообщений. Это делает взаимодействие с агентом намного более прозрачным и удобным.

Также появился встроенный редактор кода Monaco с полноценной работой внутри workspace. Ответы агента с ссылками вида path:line стали кликабельными — можно мгновенно открыть нужный файл и перейти к конкретной строке кода прямо из чата.

Отдельно переработана работа с визуализациями. Теперь агент может генерировать интерактивные HTML/SVG-виджеты внутри sandbox iframe и использовать их как часть рабочего процесса, а не просто как статичную картинку.

Фактически VulnFlow постепенно превращается из обычного dashboard в единую среду ИИ аудита!

Выше приложил скрины с работы VulnFlow.

Если вам понравилась идея, буду благодарен за звезду на репо. Напомню, что он полностью опенсорс с MIT лицензией.

Ссылка на репо - https://github.com/zaevlad/vulnflow-audit

Всем хорошего дня!

#vulnflow #study


block-2-4-activations.html
60.6Кб
numpy_all_projects2.html
171.3Кб
Мини апдейт

Я никуда не пропал, просто все еще в учебном отпуске. Решил выйти на канал, чтобы поделиться двумя темами: сколько нужно учиться для освоения навыка и как учиться с нейросетями.

Прежде всего теперь я могу ответить на один из самых популярных вопросов во время запусков курсов: А сколько нужно уделять времени в день, чтобы выучить Solidity?

Хоть я учу не Solidity, а библиотеки для машинного и глубокого обучения (numpy, matplotlib, seaborn, pandas, scikit, pytorch, huggingface), я могу с точность рассказать на что и сколько времени у меня уходит каждый день.

Обычно я сажусь за учебу около 12 дня и учу один из этапов библиотек часов до 15-15:30. Потом концентрация падает и нужно передохнуть пару часов. Затем я часа два сижу над своими проектами, скажем с 17 до 20. Потом еще немного отдыхаю и еще час занимаюсь математикой. В общем итоге у меня уходит около 5 часов в день на учебу нового материала и выполнение упражнений для его закрепления.

За это время я прошел материалы только по numpy и matplotlib. Сейчас делаю упражнения в Google Colab для получения навыков обращения с этими библиотеками. Затем подтяну pandas и seaborn. И как только пойму, что могу оперировать кодом хотя бы как джун, начну изучать scikit.

Я думал, что получится освоить и scikit до конца мая, но это было через чур амбициозно. Матрицы и линейная алгебра даются сложно.

И теперь пару слов про мой способ обучения с нейронными сетями. Знали ли вы, что Claude может создавать прекрасные обучающие материалы в html?

Для меня это было настолько впечатляюще, что я купил подписку, чтобы иметь возможность создавать такие страницы в большем количестве. Примеры таких генераций вы можете найти в прикрепленных файлах: один - это задания для практики numpy, а второй - урок по математике.

Такой способ это отличный вариант разобраться в теме, в которой вы "плаваете" или же получить задания для практики. Объясните нейронной сети, каков объем ваших знаний, что вы хотите изучить, как он должен объяснить тему (попросите сделать богатый визуал с графиками, интерактивными элементами и т.д.) и скажите сгенерировать html с уроком.

Самое крутое то, что вы можете через общение с нейронкой редактировать материал под себя: просить рассказать проще про конкретную тему, добавить задания в конец уроков, проиллюстрировать что-либо. Т.е. это отличное обучение с виртуальным учителем.

Может ли нейронка ошибаться? Да, вполне. Я сам ловил ее на некоторых моментах. Но они были чрезвычайно редки в Claude. Да и на базовом уровне изучения, они редко когда дают что-то совсем не верное. Вы так или иначе можете запросить уточнение или правки.

Если бы я не запустил SoliditySet в январе-феврале, то сейчас бы просто оставил эту идею. При этом горжусь, что получилось собрать, переработать и написать столько материалов для курса еще до бума нейронных сетей.

Кроме того, я считаю, что сейчас, во время затишья в web3 и мире нейронных сетей, самое время научиться чему-то новому и освоить новые навыки. Особенно учитывая то, что делать это теперь намного легче!

Давайте учиться вместе!

#learning


Ухожу в учебный отпуск

Последний год я активно погружался в изучение тем современных нейронных сетей, читал книги, смотрел видео, разбирал техническую документацию и делал свои проекты, применяя навыки из разных областей. Последние три месяца я также учил начальные библиотеки для погружения в сферу машинного обучения: pandas, numpy, matplotlib и scikit. Теперь я хочу потратить некоторое время на практику с этими библиотеками, чтобы позже с комфортом начать изучать pytorch и huggingface.

Поэтому этому решил потратить несколько недель на активное повторение пройденного, без какой-либо другой работы и изучения. Это хорошее время для паузы на канале, так как грядут майские праздники и многим будет все равно не до новых постов на канале. Вернусь после 11 мая.

А пока, напоследок, хотел поднять тему дополнительных навыков для современных разработчиков, в том числе и для web3 программистов.

Когда я делал сайты для solidityset или hornetmcp, я понял, что это за некоторой гранью моих знаний.

Да, в прошлом я был фуллстек разработчиком с хорошим опытом, но в базе у меня были PHP и JavaScript (React). Это с чем я работал большую часть времени и за качество чего я мог отвечать. Теперь же мои сайты были написаны на Python (который я выучил буквально в прошлом году) и React+Vite. Кроме того, загрузка на сервер вообще никогда не была в моих обязанностях. Но время "не знаю, значит не могу" уже прошло.

С развитием нейронных сетей, а также сред разработки, включая Cursor, Codex, Open code и т.д. и таких проектов как Lovable, V0, от вас будут по умолчанию ожидать, что вы можете ими пользоваться.

Создать простой сайт (с backend/frontend, а не просто html страничка), настроить seo, выбрать сервер (даже VPS) и настроить его (а за рубежом еще понимать и AWS и Azure), мониторить активность, использовать последние продукты в web3: skill для пред-аудита, написание тестов формальной верификации, дебаг транзакций в разных сетях - это все уже ожидается от начинающего разработчика.

Конечно, я сейчас не говорю о погружении в эти области и получения дополнительных знаний, я подчеркиваю, что вы должны уметь задавать правильные вопросы нейронкам и уметь разобраться в ее ответах.

Когда вы в следующий раз будете практиковаться с написанием смарт контрактов, попробуйте создать локальный вебресурс и позже загрузить его на сервер. Задача будет завершенной, когда у вас будет: web3 протокол, 100% покрытие тестами + invariant + fv, документация с описанием логики вашего протокола, загрузка его в блокчейн и настройка мониторинга, веб страница на сервере, которая сможет получать данные из вашего протокола и отсылать новые. Теперь это такой полный цикл разработки в web3.

Составляйте план с Claude, ChatGPT, GML, Kimi и т.д. Разбивайте его на этапы. Задавайте им вопросы по каждой части, которую вы не знаете. Выходите за рамки простого вайб-кодинга, и учитесь задавать больше вопросов и разбираться в теме, которую не знаете.

Если вы выбрали путь разработчика, то непрерывное обучение будет преследовать вас постоянно. И то, как вы сможете делать это максимально быстро, может определить вашу карьеру.

Всем легкого обучения и хорошей недели! А я пошел копаться в numpy.

#edu


UPD Работы на сервере

Работы закончились, работа сайтов восстановлена. При этом есть некоторые комментарии, если вы используется программы смены виртуальной локации.

При работе таких програм могут быть недоступны сайты в ru домене в частности в браузерах Chrome и Brave. Но, почему-то, в FireFox все работает стабильно и так и так.

И наоборот, например мой проект HornetMCP, который находится в зоне com, не работает при прямых запросах и нужно менять локацию для доступа. И опять же на Firefox все работает нормально.

Я не очень понимаю как работают доменные зоны (DNS) и настройки браузера, поэтому в случае каких-либо проблем с доступом, попробуйте выключить смену локации или зайти через Firefox браузеры.

Тем не менее, сайты точно доступны и работают стабильно.

Спасибо всем за ожидание.

#offtop


Работы на сервере

На хостинге, где расположен SoliditySet ведутся работы от самого провайдера. Обещают до конца дня все сделать.

Не волнуйтесь, все скоро починят)

Буду держать вас в курсе.

UPD. Они закончили работы, но нарушили некоторые мои проекты на сервере. Восстанавливаю в онлайн режиме с поддержкой.

#solidityset


Безопасность протоколов все еще не решена

Безопасность протоколов в веб3 остаётся открытой проблемой, несмотря на активное внедрение передовых технологий. Недавно Cyfrin представила Cygent, первого ИИ-инженера по безопасности для web3, способного не только выявлять уязвимости в смарт контрактах, но и автоматически устранять их. Этот инструмент интегрируется с GitHub и мессенджерами, анализирует пул-реквесты и самостоятельно генерирует код для исправления ошибок, превращая сложные аудиторские отчёты в готовые решения. Ещё раньше другие компании, например Recon, открыли исходный код своих агентов и программ для проверки безопасности и написания тестов для смарт-контрактов. На рынке появляется всё больше решений для мониторинга блокчейна, в том числе основанных на искусственном интеллекте.

Казалось бы, с таким арсеналом средств хакерам придётся несладко. Однако проблема не решается простым наращиванием технологий. Мне всегда была близка аналогия безопасности в web3 с камерами видеонаблюдения в современных жилых комплексах: "Когда у вас украдут велосипед, все всегда будете знать цвет куртки вора". Зачастую всё, что удаётся отследить после взломов, — это путь транзакций от кошелька до очередного миксера. Но что это меняет? Возникает закономерный вопрос: повышают ли новые боты безопасность протоколов и блокчейна в целом или же служат лишь инструментом заработка для своих создателей?

Современные взломы давно вышли за рамки простого анализа кода. Сегодня это искусная социальная инженерия и тончайшая настройка параметров атаки, где роль играют комиссии, объём газа, стоимость взлома, актуальные балансы и многие другие переменные. Такие атаки зачастую невозможно предотвратить с помощью инвариантных тестов или формальной верификации в их классическом понимании. В случае социальной инженерии всё работает как в командной эстафете: надёжность системы определяется её самым слабым звеном. Хакерам не нужно взламывать всю инфраструктуру — достаточно войти в доверие к паре сотрудников, получить доступы, и цель достигнута. И здесь уже совершенно неважно, что ваш код проверяли лучшие аудиторы мира, самые продвинутые ИИ и системы непрерывного мониторинга.

Другой путь требует значительно более глубоких усилий: развитие математического моделирования и симуляций. Когда ИИ объединится с формальной верификацией, получит доступ к данным о математических расчётах в блокчейне, к оракулам или их архивным стабильным показателям, тогда появится возможность тестировать транзакции кросс-чейн, кросс-протокол и кросс-контракт в условиях, максимально приближенных к реальным. Это сделало бы экосистему чуть безопаснее. Однако такая задача неизмеримо сложнее, чем создание очередного анализатора на Rust или оркестрация агентами.

Таким образом, ключевая идея моего поста состоит в том, что технологическая гонка вооружений в web3 сама по себе не гарантирует безопасности. Автоматизированные инструменты и ИИ-ассистенты способны повысить барьер для атак, но они бессильны против системных уязвимостей, связанных с человеческим фактором, и не охватывают всю сложность многопараметрических взломов. Подлинный прогресс возможен лишь при комплексном подходе, который сочетает развитие математического моделирования, формальных методов, кросспротокольной симуляции и, что особенно важно, культуры безопасности среди людей. Пока этот баланс не будет достигнут, любые инновации останутся лишь частичным решением, а не панацеей.

#security


На данный момент я рассматриваю эту версию как базу для построения более сложных и продвинутых систем, которые будут добавляться со временем. Любой пользователь может скачать проект и доработать его так, как ему нужно, поэтому лицензию оставил MIT. Надеюсь, что это даст небольшой буст к развитию подобных систем для аудита и проверок смарт контрактов на разных языках.

Ссылка на репо - https://github.com/zaevlad/vulnflow-audit

Буду рад любым отзывам и предложениям!

#ai #vulnflow


Vulnflow - открытие проекта для аудита с ИИ

Сегодня я рад представить вам свой первый опенсорс проект, над которым работал последние 2 месяца.

Идея проекта пришла в голову, когда я пытался собрать своего бота для аудита контрактов с использованием различных скиллов. Тогда я понял, что мне очень не хватает некой визуальной части, где я мог бы просто собирать пайплайн из нужным мне частей. Так появился Vulnflow.

VulnFlow — это локальная платформа для аудита смарт контрактов, которая позволяет превратить сложный и разрозненный процесс анализа в понятный, управляемый и воспроизводимый workflow. Вместо ручного запуска множества агентов и постоянной потери контекста между этапами, пользователь собирает единый пайплайн из независимых блоков, каждый из которых выполняет конкретную задачу: анализ кода, поиск уязвимостей, обработку данных или взаимодействие с внешними сервисами.

Подход VulnFlow строится вокруг визуального конструктора по примеру n8n, где логика аудита представляется в виде графа. Это позволяет не только гибко настраивать процесс под конкретный проект, но и сохранять его в виде структуры, которую можно повторно использовать, масштабировать и дорабатывать. Таким образом аудит перестаёт быть набором одноразовых действий и становится системным процессом с чёткой логикой и воспроизводимыми результатами.

Платформа поддерживает работу с AI моделями, включая локальные (Ollama, LM Studio или llama.cpp) и OpenAI-compatible модели, что даёт возможность автоматизировать анализ, выдвижение гипотез и объяснение потенциальных уязвимостей. Вам не нужно тратить бюджет на дорогой GPT или Claude для каждого агента. Вы сами решаете, сколько агентов использовать — от одного простого до сложного многошагового пайплайна.

Важной частью системы являются skills и lead_skills. Skills — это переиспользуемые модули поведения агента: специализированные промпты, логика анализа и сценарии поиска уязвимостей, которые можно комбинировать между собой. Пользователь может использовать как собственные skills, так и любые другие — готовые варианты и рекомендации по ним можно найти в репозитории и адаптировать под свои задачи. Lead_skills управляют общим ходом рассуждения агента, задают стратегию анализа и координируют использование отдельных skills внутри сложных пайплайнов. Такой подход позволяет не просто запускать модели, а выстраивать структурированное и контролируемое поведение агентов.

Кроме того, встроенная проверка по YAML-правилам позволяет описывать собственные уязвимости и проверять их автоматически.

VulnFlow также решает проблему контекста за счёт встроенной системы памяти и поиска по embedding, что позволяет подключать документацию, отчёты об аудитах и другие источники знаний прямо в процесс анализа. Память работает как долговременное хранилище результатов и наблюдений: агенты могут сохранять промежуточные выводы, извлекать релевантный контекст и использовать его на следующих этапах пайплайна. Это особенно важно при анализе сложных систем, где информация накапливается постепенно и требует повторного использования.

Поддержка выполнения Python-кода даёт возможность реализовывать кастомную логику любой сложности, а для усиления проверок можно подключить внешние инструменты вроде Solodit или HornetMCP через блок Tool — модель получит доступ к базам известных багов и внешнему контексту.

VulnFlow поддерживает два режима аудита: Contract для прямого анализа отдельных sol-файлов и Cluster для автоматической группировки связанных контрактов в крупных кодовых базах. Все собранные пайплайны сохраняются в папке pipelines и могут быть переиспользованы на других проектах без перенастройки.

В результате пользователь получает не просто инструмент для поиска уязвимостей, а полноценную среду для построения собственных систем аудита, где знания формализуются, автоматизируются и могут быть повторно использованы в любых проектах.

Показано 20 последних публикаций.